
راهنمای معماری مدلهای زبانی ۱.۵۸ بیتی BitNet
پایان سلطه محاسبات سنگین ممیز شناور؛ چگونه وزنهای سهتایی امروزه اجرای مدلهای ۱۰۰ میلیارد پارامتری را روی سختافزارهای مصرفی ممکن ساختند.
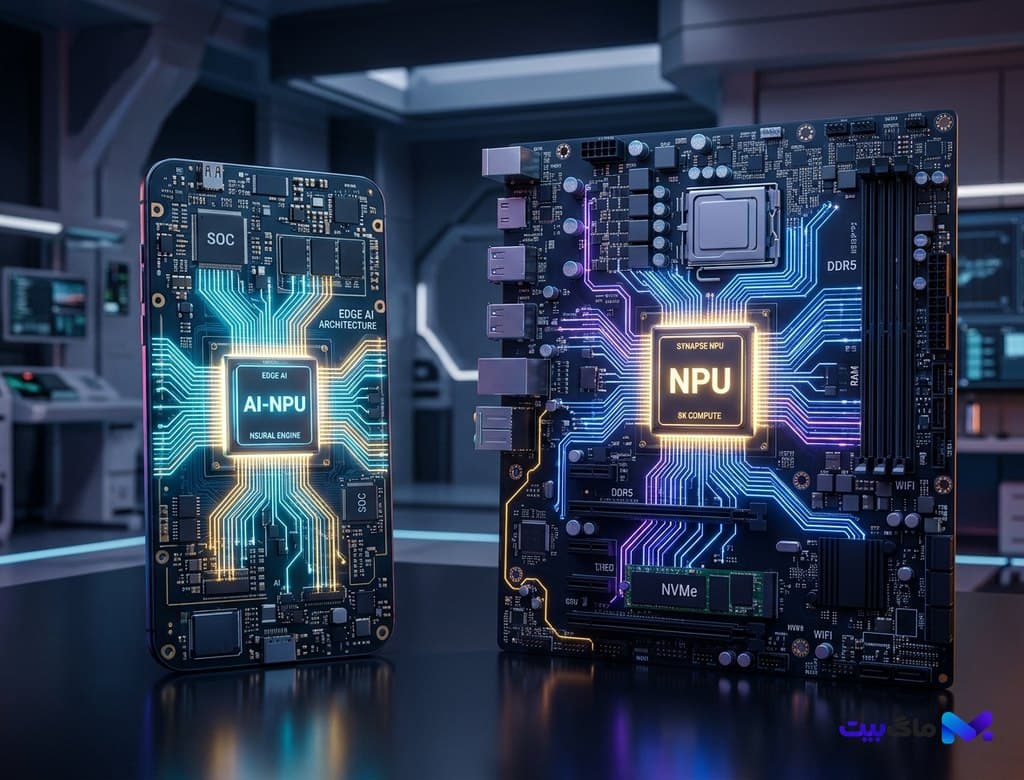
- تحلیل موشکافانه و همهجانبه جهش بزرگ معماری مدلهای زبانی بزرگ (LLM) با ظهور سیستمهای ۱.۵۸ بیتی (BitNet b1.58) و مقادیر سهتایی امروزه بررسی مهندسی جایگزینی کامل ضرب ماتریسی ممیز شناور (FP16/BF16 GEMM) با عملیات جمع و تفریق عدد صحیح، کاهش ۹۰ درصدی مصرف پهنای باند حافظه DRAM و مصرف برق در سرورها، تحلیل عملکرد مدلهای منبعباز نظیر BitNet-Large و Falcon-Ternary در مقایسه با ساختارهای متراکم سنتی، نحوه آموزش پایدار با گرادیانهای شناور و کوانتیزاسیون بلادرنگ اکتیویشنها به INT8، و کالبدشکافی پیامدهای رادیکال این معماری برای پردازش لبه، دستیاران آفلاین در گوشیهای هوشمند و کاهش انتشار کربن در دیتاسنترهای هوش مصنوعی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بحران انرژی و گلوگاه پهنای باند حافظه؛ چرا ممیز شناور FP16 به بنبست رسید؟
در طول سالهای اوج انفجار هوش مصنوعی مولد، بزرگترین مانع در مقیاسپذیری مدلهای زبانی، عملیات ضرب ماتریسی شناور (Floating-Point Multiply-Accumulate) و مصرف سرسامآور پهنای باند حافظه HBM بود. اجرای یک مدل زبانی ۷۰ میلیارد پارامتری با دقت ۱۶ بیت به حداقل ۱۴۰ گیگابایت حافظه پرسرعت نیاز داشت و انتقال مداوم این حجم از وزنها میان تراشه محاسباتی و سلولهای رم، بخش اعظم انرژی پردازنده را هدر میداد. این گلوگاه نه تنها باعث افزایش نجومی هزینههای سرور شد، بلکه اجرای مدلهای توانمند را روی دستگاههای کلاینت غیرممکن ساخت.
همانطور که در بررسی تخصصی هوش مصنوعی عاملمحور و دستیاران خودران نشان دادیم، ایجنتهای نرمافزاری برای اتخاذ تصمیمات بلادرنگ نیازمند استنتاجهای پیوسته و ارزان هستند. تکیه بر سرورهای ابری با تاخیرهای چندثانیهای و مصرف برق چندصد واتی، مانع تحقق این چشمانداز بود. در پاسخ به این معضل تاریخی، تیمهای تحقیقاتی پیشرو در مایکروسافت، کالیفرنیا و پکن امروزه پارادایم انقلابی BitNet را از آزمایشگاه به مرحله تولید صنعتی رساندند.
این جهش بنیادین با پذیرش این حقیقت علمی حاصل شد که شبکههای عصبی برای درک معنا و ارتباطات زبانی به دقت ممیز اعشاری تا چندین رقم اعشار نیازی ندارند؛ بلکه ارزش بنیادین هر نورون در سه حالت جهتگیری خلاصه میشود: فعال مثبت، غیرفعال یا بازدارنده منفی.
معماری ریاضی BitNet b1.58؛ جایگزینی ضرب با جمع عدد صحیح
هسته اصلی این تحول در معماری موسوم به BitNet b1.58 نهفته است. در این ساختار، هر وزن در ماتریس شبکه عصبی تنها یکی از سه مقدار تِراناری (Ternary) شامل منفی یک، صفر یا مثبت یک {-۱, ۰, +۱} را اتخاذ میکند. از منظر نظریه اطلاعات شانون، با توجه به اینکه لگاریتم مبنای ۲ عدد ۳ برابر با ۱.۵۸ است، هر وزن به صورت تئوریک دقیقاً ۱.۵۸ بیت فضا اشغال مینماید که در فرمتهای مدرن سختافزاری به فشردهسازی بیسابقه منتهی میگردد.
پیامد عملی این ساختار در لایههای ترنسفورمر معجزهآساست: هنگامی که ورودیها در وزن ضرب میشوند، سیستم دیگر نیازی به واحدهای محاسباتی ممیز شناور (FP16/BF16 ALUs) با هزاران ترانزیستور پیچیده ندارد. ضرب در مثبت یک یعنی خود مقدار، ضرب در منفی یک یعنی معکوس علامت، و ضرب در صفر یعنی چشمپوشی از ورودی. در نتیجه، میلیاردها عملیات ضرب ماتریسی سنگین به جمع و تفریق ساده اعداد صحیح (Integer Addition) تبدیل میشوند.
این نوآوری سبب شده تا توان مصرفی محاسبات ضرب ماتریسی تا ۹۲ درصد کاهش یابد و فشردگی مدل به اندازهای برسد که یک مدل ۱۰۰ میلیارد پارامتری به جای نیاز به چند کارت گرافیک گرانقیمت، درون ۲۰ گیگابایت حافظه رم معمولی جای گرفته و با سرعت بیش از ۴۰ توکن بر ثانیه روی تراشههای NPU اجرا شود.
فرآیند آموزش با گرادیانهای شناور و کوانتیزاسیون اکتیویشنها به INT8
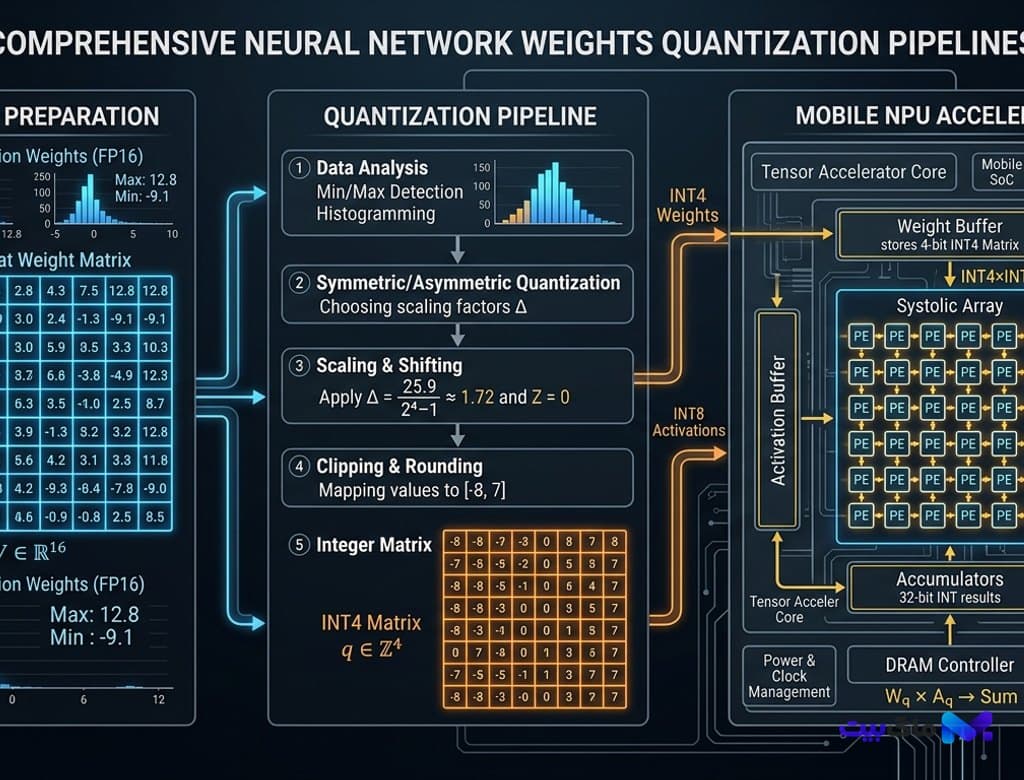
پرسش اساسی بسیاری از مهندسان این بود که چگونه میتوان شبکهای با وزنهای سهتایی را بدون افت فاحش در توانایی استدلال آموزش داد؟ کلید موفقیت روش BitNet در تفکیک فاز پیشرو (Forward Pass) از فاز پسانتشار خطا (Backward Pass) است. در جریان آموزش، یک نسخه پنهان از وزنها با دقت کامل ممیز شناور در حافظه نگهداری میشود تا گرادیانهای بسیار ریز به صورت پیوسته تجمیع شوند.
در حین فاز پیشرو، این وزنها با استفاده از تابع پلهای علامتگذار و میانگین قدر مطلق لایه، بلافاصله به مقادیر سهتایی کوانتیزه میشوند و بردارهای فعالسازی (Activations) نیز به دقت ۸ بیتی عدد صحیح (INT8) تبدیل میگردند. همانگونه که در کالبدشکافی انقلاب مدلهای استدلالگر امروزه مشاهده کردیم، الگوریتمهای تفکر زنجیرهای در مدلهای BitNet با مقیاس بیش از ۳۰ میلیارد پارامتر، دقیقاً دقتی معادل مدلهای هماندازه سنتی Llama و Claude Sonnet ارائه میدهند، در حالی که منابع سختافزاری ناچیزی طلب میکنند.
علاوه بر این، تکنیک آموزش مستقیم وزنهای سهتایی (Native Ternary Pre-training) برخلاف روشهای قدیمی کوانتیزاسیون پس از آموزش (PTQ)، هیچگونه اثر توهم یا فراموشی فاجعهبار (Catastrophic Forgetting) ایجاد نمیکند و پایداری خروجی در وظایف کدنویسی و محاسبات ریاضی تضمین میشود.
تحول پردازش لبه؛ هوش فراگیر در تلفنهای هوشمند و خودروها بدون اتصال به اینترنت
در دسترس قرار گرفتن مدلهای ۱.۵۸ بیتی، نقشه راه تراشهسازان بزرگ نظیر کوالکام، اپل و انویدیا را دستخوش بازطراحی کرده است. نسل جدید واحدهای پردازش عصبی (NPU) در پردازندههای موبایل دوران معاصر به طور اختصاصی به شتابدهندههای برداری تراناری مجهز شدهاند که مصرف انرژی آنها در حالت آمادهبهکار کمتر از ۱ وات است.
کاربران اکنون میتوانند یک دستیار شخصی با هوشمندی مدلهای فوقپیشرفته را به صورت محلی، بدون ارسال حتی یک بایت داده به کلاد، روی گوشی هوشمند یا لپتاپ خود میزبانی کنند. این جهش با اصول معماری اول-محلی و دیتابیسهای لبه در هماهنگی کامل است؛ جایی که حفظ حریم خصوصی، پاسخگویی بیدرنگ و عدم اتکا به اینترنت در اولویت قرار دارد.
در صنایع حساسی همچون دفاعی، بهداشت و روباتیک، مدلهای زبانی ۱.۵۸ بیتی توانستهاند سامانههای تعاملی را به تجهیزاتی کاملاً خودمختار بدل کنند که در شرایط قطع کامل ارتباطات رادیویی، بدون کوچکترین افت در توان تحلیل، به انجام ماموریتهای پیچیده ادامه میدهند.
چشمانداز اقتصادی و زیستمحیطی؛ نجات دیتاسنترها از بحران حرارتی
مزایای BitNet فراتر از دستگاههای مصرفی، دیتاسنترهای مقیاس عظیم (Hyperscale Datacenters) را نیز متحول ساخته است. تا پیش از دوران معاصر شرکتهای بزرگ فناوری به دلیل مصرف برق نجومی و حرارت مهارنشدنی خوشههای گرافیکی، ناچار به بررسی روشهای پرهزینه مانند غوطهوری در مایع خنککننده بودند. استقرار سرورهای مبتنی بر تراشههای تراناری، تولید حرارت را به یکهشتم کاهش داده است.
همگامی مدلهای ۱.۵۸ بیتی با پایگاههای داده برداری نسل دوم که آنها نیز از کوانتیزاسیون باینری بهره میبرند، زنجیره پردازش دانش در سیستمهای بازیابی اطلاعات (RAG) را به یک زنجیره محاسباتی کاملاً عدد صحیح بدل ساخته که در آن تاخیر استعلام از چندصد میلیثانیه به کمتر از ۱۵ میلیثانیه سقوط کرده است.
معماری BitNet صرفاً یک بهینهسازی الگوریتمی نیست؛ بلکه یک رنسانس مهندسی است که تئوری یادگیری ماشین را با واقعیتهای فیزیکی سختافزار پیوند داده و مسیر فراگیری هوش مصنوعی را برای همیشه دگرگون ساخته است.
بیشتر از هوش مصنوعی



