
پایگاهدادههای برداری توزیعشده و GraphRAG
جستجوی سنتی وکتوری دیگر پاسخگوی سیستمهای هوش مصنوعی سازمانی نیست؛ دیتابیسهای برداری-گرافی و GraphRAG دوران کنونی حافظه تریلیونتوکنی ایجنتها را با دقت توپولوژیک تضمین میکنند.
- بررسی جامع و عمیق زیرساختهای مهندسی داده و نسل نوین دیتابیسهای برداری توزیعشده و معماری GraphRAG امروزه. عبور از بازیابی معنایی تکبعدی مبتنی بر شباهت کسینوسی ساده به سمت ساختارهای هیبریدی تلفیق گراف و بردار؛ بررسی الگوریتمهای پیشرفته سلسلهمراتبی HNSW، فشردهسازی اسکالر بردارها با متد کالیبراسیون کوانتیده، ادغام گرافهای دانش سازمانی جهت پاسخگویی به کوئریهای پیچیده چندمرحلهای (Multi-Hop Reasoning)، کاهش هزینههای ذخیرهسازی و تاخیر بازیابی در مقیاس میلیاردها بردار و تضمین حافظه پایدار برای ایجنتهای هوشمند خودمختار.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بنبست شباهت کسینوسی؛ چرا وکتور دیتابیسهای سنتی برای درک سازمانها کافی نبودند؟
با گسترش سامانههای بازیابی مبتنی بر تولید (RAG) در سالهای گذشته، بسیاری تصور میکردند خرد کردن متون به قطعات چندصد کلمهای و ذخیره بردارهای متناظر در یک پایگاه داده برداری، حلال تمامی چالشهای حافظه هوش مصنوعی است. اما شرکتهای سازمانی به زودی با واقعیتی تلخ مواجه شدند: شباهت کسینوسی برداری (Cosine Similarity) تنها کلمات و مفاهیم سطحی هممعنی را مییابد، اما قادر به درک «روابط علت و معلولی»، «سلسلهمراتب مالکیتی» و «وابستگیهای چندهاپی» در حجم دادههای سازمانی نیست.
اگر از یک سیستم RAG سنتی پرسیده میشد: «کدام تامینکننده قطعات باتری پروژه X در صورت بروز بحران در تایوان آسیب میبیند؟»، سیستم به دلیل عدم وجود این جمله دقیق در اسناد، پاسخی ناقص یا توهمآمیز میداد. همانگونه که در بررسی تخصصی انقلاب ایجنتهای خودمختار مهندسی نرمافزار و معماری چندایجنت امروزه تشریح گردید، ایجنتهای پیشرفته نیازمند نقشهای ساختیافته از جهان کسبوکار هستند.
معماری GraphRAG یکپارچه امروزه این شکاف بنیادین را پر کرده است؛ تلفیق گرافهای دانش غنی با بردارهای توزیعشده، پیوندهای معنایی میان موجودیتها (اشخاص، پروژهها، سرورها و قراردادها) را به صورت توپولوژیک مدلسازی میکند.
الگوریتمهای سلسلهمراتبی HNSW و متدهای کوانتیزاسیون اسکالر در مقیاس تریلیونی
چالش فنی اصلی در مقیاسپذیری پایگاههای داده برداری، مصرف سرسامآور حافظه RAM بود. ذخیره یک میلیارد بردار با ابعاد ۱۵۳۶ و دقت اعشاری FP32 نیازمند ترابایتها حافظه بسیار گرانقیمت سرور بود که توجیه اقتصادی پروژهها را به بنبست میکشاند. امروزه موتورهای برداری مدرن با بهرهگیری از تکنیکهای نوین کوانتیزاسیون ضربی (Product Quantization) و کوانتیزاسیون اسکالر ۱ بیتی کالیبرهشده، حجم هر بردار را تا ۹۴ درصد کاهش دادهاند، در حالی که دقت بازیابی بالای ۹۹.۲ درصد حفظ میشود.
همزمان، الگوریتمهای ناوبری گراف دنیای کوچک قابلانعطاف سلسلهمراتبی (Hierarchical Navigable Small World - HNSW) با محاسبات SIMD موازی بر روی شتابدهندهها بهینهسازی شدهاند. همانگونه که در مقاله جهش شتابدهندههای محاسباتی فوتونیک و شبکههای عصبی نوری امروزه بررسی شد، مهاجرت به پردازشهای برداری فوقسریع موجب شده تا جستجوی نزدیکترین همسایه در کلاسترهایی با ۱۰ میلیارد رکورد، در کمتر از ۸ میلیثانیه به سرانجام برسد.
این راندمان بالا به کسبوکارها اجازه میدهد تا تمام دادههای ساختارنیافته شامل کدهای مخزن، تیکتهای پشتیبانی، قراردادهای مالی و لاگهای سرور را در یک پایگاه داده یکپارچه بدون افت کارایی ایندکس کنند.
استخراج خودکار گراف دانش و سنتز سرفصلهای مفهومی با ایجنتهای داده
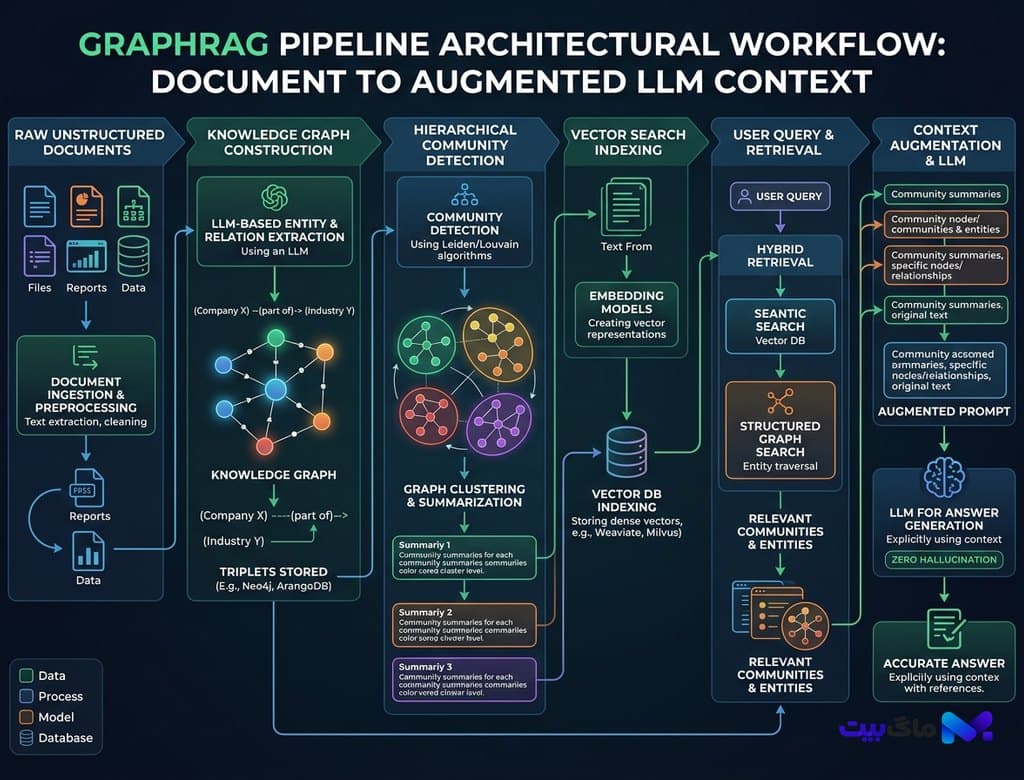
ایجاد و نگهداری دستی گراف دانش در گذشته فرآیندی طاقتفرسا و پرهزینه بود. اما در معماری نوین GraphRAG دوران کنونی خط لولههای هوشمند داده به طور خودکار اسناد ورودی را پارس کرده، موجودیتها و روابط بین آنها را استخراج نموده و خوشههای معنایی مرتبط را با الگوریتمهای تشخیص جامعه (Community Detection مانند Leiden) دستهبندی میکنند.
برای هر خوشه، ایجنتهای هوشمند یک خلاصهسازی کلان تولید میکنند. زمانی که کاربر یا ایجنت سوالی جامع و کلان مطرح میسازد (Global Query)، سیستم به جای اتلاف کانتکست با هزاران تکه متن پراکنده، خلاصههای خوشههای سطح بالا را ترکیب کرده و پاسخی جامع، مستند و فاقد تناقض ارائه میدهد.
همانگونه که در واکاوی پیادهسازی استانداردهای رمزنگاری پساکوانتومی و پروتکلهای KEM امروزه تشریح شد، لایههای امنیتی برچسبگذاری رمزنگاریشده در این دیتابیسها تعبیه شده تا اطمینان حاصل شود که هر ایجنت تنها به زیرمجموعه مجاز از گراف دانش سازمان دسترسی دارد.
آینده زیرساختهای داده؛ از حافظه پایدار ابری تا تصمیمگیری بلادرنگ در لبه
تکامل پایگاهدادههای برداری-گرافی امروزه پایهگذار نسلی تازه از هوش مصنوعی سازمانی است که فراموشی، تکرار اشتباهات گذشته و توهم حقایق در آن ریشهکن شده است. سیستمهای نظارتی شرکتهای بزرگ مالی و بیمه اکنون تمامی تراکنشها و ارتباطات را بر بستر این گرافها لحظه به لحظه مانیتور کرده و شبکههای پولشویی و کلاهبرداری را پیش از وقوع شناسایی میکنند.
همچنین تیمهای مهندسی با متصل ساختن معماری سیستمهای خود به این گرافها، تغییرات ساختاری کدها را به طور کامل اعتبارسنجی میکنند تا اطمینان حاصل نمایند هیچ سرویس حیاتی دچار تداخل نخواهد شد.
بدون تردید پایگاهدادههای برداری-گرافی توزیعشده، ستون فقرات نامرئی اما حیاتی تمام سیستمهای خودمختار و هوشمند امروزه و فراتر از آن خواهند بود؛ شالودهای استوار که بدون آن، رویای هوش مصنوعی عمومی سازمانی امکانپذیر نمیشد.
بیشتر از فناوری



