
معماری GraphRAG و پایگاههای برداری
امروزه شرکتهای بزرگ متوجه شدند که جستجوی برداری ساده برای پرسشهای کلان سازمانی کور است. راهنمای فنی پیوند گراف دانش با دیتابیسهای برداری را بخوانید.
- بررسی عمیق نسل نوین سامانههای بازیابی اطلاعات تقویتشده (GraphRAG) در زیرساختهای انترپرایز؛ کالبدشکافی محدودیتهای RAGهای سنتی مبتنی بر شباهت کسینوسی، نحوه استخراج سهگانههای معنایی و خوشهبندی لیدن با Neo4j و Milvus، و حذف کامل توهم در سیستمهای هوش مصنوعی سازمانی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان ماه عسل RAG سنتی؛ چرا جستجوی برداری برای سازمانها ناکافی بود؟
در سالهای اولیه فراگیری مدلهای زبانی بزرگ، الگوی «بازیابی تقویتشده با تولید» (RAG) به عنوان معجزه حل مشکل دانش اختصاصی کسبوکارها معرفی شد. ایده در ظاهر ساده بود: اسناد شرکت به تکههای کوچک متنی (Chunks) خرد میشدند، توسط مدلهای امبدینگ به بردارهایی در فضا تبدیل شده و در پایگاههای داده برداری ذخیره میگردیدند. در زمان پرسش کاربر، با محاسبه شباهت کسینوسی، مرتبطترین تکهها استخراج و در پنجره پرامپت تزریق میشدند.
اما با رسیدن به دوران معاصر و استقرار این سیستمها در سازمانهای مالی، حقوقی و پزشکی، ترکهای عمیق این معماری آشکار شد. RAGهای برداری سنتی در پاسخ به سوالات نقطهای (مانند «شماره بیمهنامه آقای کریمی چیست؟») خوب عمل میکردند، اما در برابر پرسشهای مفهومی، تحلیلی و کلان (مانند «چه زنجیرهای از تصمیمات مدیریتی در سه ماهه گذشته باعث افت سود بخش لجستیک شد؟») کاملاً شکست میخوردند؛ چرا که اطلاعات پاسخ در دهها سند مختلف پراکنده بود و هیچ همبستگی آماری مستقیمی میان کلمات وجود نداشت.
این ناتوانی ساختاری منجر به پدیده خطرناک «توهم مصنوعی» (Hallucination) میشد؛ معضلی که در محیطهای سازمانی نابخشودنی است و نیازمند یک انقلاب معماری بود که امروزه با نام GraphRAG شناخته میشود.
معماری بنیادین GraphRAG؛ از استخراج موجودیتها تا خوشهبندی سلسلهمراتبی لیدن
معماری GraphRAG رویکردی ریشهای را در پیش میگیرد: متون ورودی پیش از ذخیرهسازی، توسط یک مدل زبانی تحلیل شده و تمامی موجودیتها (Entities)، مفاهیم، افراد و سازمانها همراه با روابط دقیق میان آنها (Relations) در قالب سهگانههای گراف استخراج میشوند (برای نمونه: «شرکت الف» --[تامینکننده قطعه]--> «پروژه ب»).
سپس این گراف با بهرهگیری از الگوریتمهای پیشرفته تشخیص جوامع شبکهای مانند الگوریتم لیدن (Leiden Community Detection) به صورت سلسلهمراتبی خوشهبندی میشود. برای هر خوشه و زیرخوشه، یک خلاصه جامع تحلیلی (Community Summary) تولید شده و همزمان این خلاصهها بردارسازی میشوند.
هنگامی که کاربر یک سوال استراتژیک میپرسد، موتور بازیابی دیگر در میان هزاران پاراگراف تصادفی سردرگم نمیشود؛ بلکه ابتدا خوشههای مرتبط در بالاترین لایه گراف را پیمایش کرده و سپس مانند یک بازرس کارکشته، گره به گره مسیر روابط را تا کشف شواهد قطعی دنبال میکند. این فرآیند دقیقاً مکمل رویکردی است که در مقایسه دستیاران مهندسی نرمافزار خودکار امروزه برای حل مسائل پیچیده چندفایلی با AST تشریح کردیم.
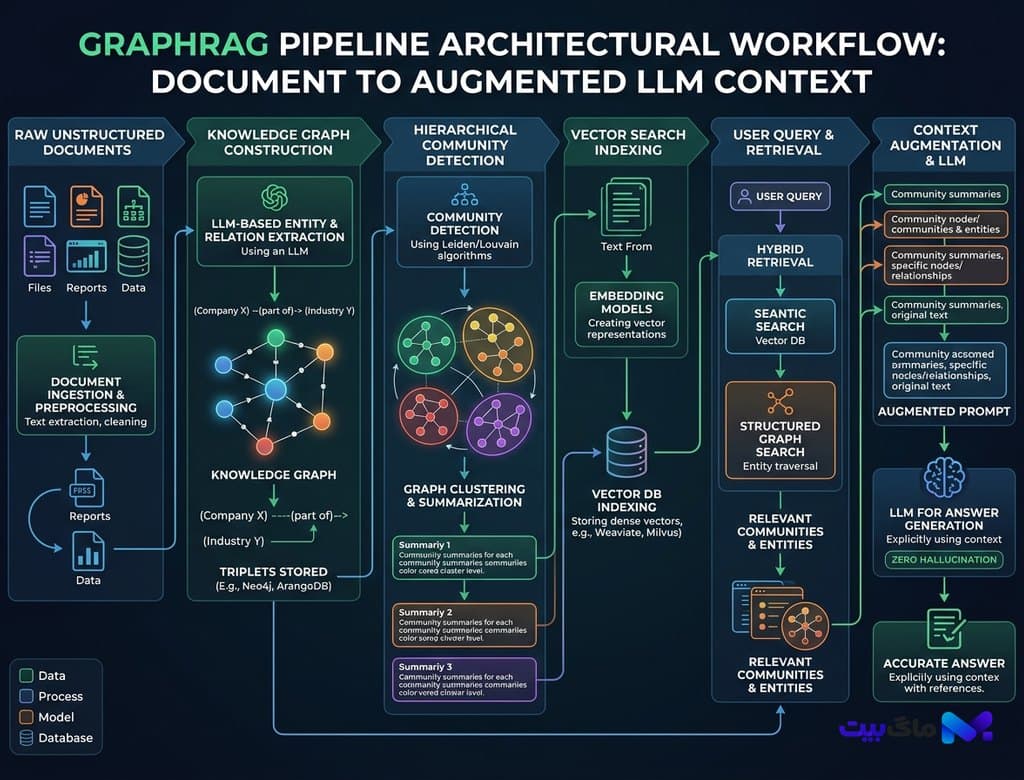
ترکیب قدرتمند Neo4j و دیتابیسهای برداری توزیعشده مانند Milvus 3 و Qdrant
در لایه زیرساخت، نسل جدید پایگاههای داده هیبریدی مرز میان پایگاههای سنتی رابطه، گراف و بردار را محو کردهاند. سیستمهای مدرن پایگاه داده برداری مانند Milvus 3.0 و Qdrant با اضافه کردن ایندکسهای گرافی و پشتیبانی از کوئریهای فیلترشده پیچیده، تاخیر پیمایش گرافهای چندمیلیاردی را به کمتر از ۲۰ میلیثانیه کاهش دادهاند.
همزمان، موتورهای گراف بومی مانند Neo4j Aura با ادغام مستقیم جستجوی هیبریدی (Hybrid Cypher + Vector Search)، به توسعهدهندگان اجازه میدهند تا با نوشتن یک دستور واحد، هم بر اساس معناشناسی متنی و هم بر اساس مجاورت توپولوژیکی در گراف به جستجو بپردازند. این ترکیب طلایی موجب شده تا حتی در پایگاههای داده عظیم با مقیاس پتابایت، فرآیند بازیابی دقیق با تضمین صحت شواهد انجام گیرد.
سلفهاستینگ و امنیت دادههای محرمانه در معماریهای نوین RAG
یکی از دغدغههای جدی مدیران ارشد فناوری (CTO)، جلوگیری از نشت دادههای مالی و کدهای انحصاری به سرورهای کلاد عمومی است. معماریهای GraphRAG نوین به گونهای طراحی شدهاند که با مدلهای زبانی محلی با وزنهای آزاد (نظیر خانواده Llama و Qwen) بر روی کلاسترهای داخلی شرکتها مستقر شوند.
این همگرایی با زیرساختهای محلی هماهنگی چشمگیری با اصول مطرحشده در راهنمای عملی سلفهاستینگ و کلاد شخصی امروزه دارد؛ جایی که سازمانها با حذف وابستگی به APIهای ابری ناپایدار، مالکیت کامل زنجیره ارزش دادههای خود را بازپس میگیرند و امنیت را در بالاترین لایه حفظ مینمایند.
بنچمارکهای میدانی؛ مقایسه نرخ دقت و هزینه استقرار در محیطهای Enterprise
بر اساس ارزیابیهای مستقل فنی امروزه پیادهسازی GraphRAG توانسته است نرخ خطای ادراکی و پاسخهای متناقض را در آزمونهای ارزیابی چندمرحلهای (Multi-hop QA) از ۴۲ درصد در RAG سنتی به کمتر از ۲.۸ درصد تقلیل دهد. این دقت خارقالعاده اگرچه در مرحله آمادهسازی اولیه گراف (Graph Indexing) به حدود ۲ الی ۳ برابر توان محاسباتی بیشتر نیاز دارد، اما در بلندمدت با کاهش چشمگیر توکنهای هدررفته در پرامپتهای بیهوده، هزینه کلی استنتاج سازمان را تا ۳۵ درصد کاهش میدهد.
سازمانهایی که امروزه این پارادایم را اتخاذ کردهاند، دیگر نگران غافلگیری هوش مصنوعی در جلسات هیئتمدیره نیستند؛ چرا که هر ادعایی با یک پیوند صریح به گرههای گراف دانش مستند شده است.
نتیجهگیری: گذر به حافظه ساختیافته و آینده هوش تصمیمساز
دنیای فناوری در حال عبور از دوره شیفتگی به مدلهای بزرگ بیحافظه به سمت عصر معماریهای یکپارچه دانشبنیان است. GraphRAG صرفاً یک ترفند پرامپتینگ جدید نیست؛ بلکه ایجاد یک سیستم عصبی ساختیافته برای هوش مصنوعی است که در آن حافظه، منطق و استدلال به شکلی شفاف و قابلردگیری به یکدیگر گره خوردهاند.
برای مهندسان نرمافزار و رهبران فناوری امروزه تسلط بر تقاطع گرافهای دانش و پایگاههای برداری حیاتیترین مهارت شغلی برای باقی ماندن در لبه مرز نوآوری به شمار میرود.
بیشتر از فناوری



