
دیتابیسهای گراف وکتوری هیبریدی در مهندسی داده
پایان جستجوهای کور برداری؛ چگونه پایگاههای داده هیبریدی گراف وکتور با اتصال امبدینگهای معنایی به شبکه روابط منطقی، بازیابی دانش را به بالاترین دقت امروزه رساندند.
- تحلیل تخصصی و کاربردی ظهور نسل جدید پایگاههای داده ترکیبی گراف-وکتور امروزه چرا شاخصگذاری صرفاً برداری در پاسخ به کوئریهای چندمرحلهای شکست میخورد؟ بررسی معماریهای نوین در Neo4j Vector، Milvus 3 و Weaviate 2، ساخت خودکار آنتولوژیهای پویا با ایجنتهای هوش مصنوعی و بهینهسازی سیستمهای بازیابی ارتقایافته با تولید (GraphRAG) در زیرساختهای ابری.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
شکست RAG سنتی در درک پیوندهای پیچیده؛ نقص بنیادین فضاهای برداری ایزوله
در سالهای نخست رونق هوش مصنوعی زاینده، الگوی بازیابی اطلاعات تقویتشده با تولید (RAG) به عنوان استاندارد صنعتی برای اتصال مدلهای زبانی به اسناد داخلی شرکتها پذیرفته شد. در این الگو، متنها به چانکهای مجزا تکهتکه شده و توسط مدلهای امبدینگ به بردارهایی در یک فضای چندبعدی نگاشت میشدند؛ سپس با استفاده از الگوریتمهایی نظیر شباهت کسینوسی در پایگاههای داده برداری، تکههای متنی نزدیک به پرسش کاربر بازیابی میشدند. با این حال، با استقرار این سامانهها در صنایع حساس نظیر بهداشت و درمان، امور مالی و مهندسی هوافضا، یک نقص بنیادین آشکار گردید: ناتوانی در پیمایش روابط چندگانه و دید کلنگر.
جستجوی برداری سنتی در سناریوهایی نظیر «تاثیر تغییر نرخ بهره فدرال رزرو بر تامینکنندگان رده سوم باتری خودروهای برقی چیست؟» کاملاً به گل مینشست؛ زیرا تکههای اطلاعاتی مربوط به این زنجیره در بخشهای متفاوتی از صدها سند دفن شده بودند و هیچ شباهت برداری مستقیمی میان «نرخ بهره» و «معدن لیتیوم در شیلی» وجود نداشت. سیستم تکههای تصادفی را بازیابی میکرد و در نهایت مدل به توهم و نتیجهگیری گمراهکننده پناه میبرد.
جامعه مهندسی داده دریافت که مفهوم «معنا» صرفاً فاصلهای در فضای برداری نیست، بلکه حاصل ساختاری شبکهای از موجودیتها و پیوندهای ساختاریافته (Subject-Predicate-Object) است. پاسخ به این بحران، ادغام ساختاری دو دنیای متمایز بود: ترکیب گرافهای دانش قطعی با امبدینگهای شناور معنایی در قالب دیتابیسهای هیبریدی گراف وکتور.
کالبدشکافی معماری دیتابیسهای هیبریدی گراف وکتور؛ تلفیق HNSW با ایندکسهای گرافی
در نسل نوین دیتابیسهای هیبریدی دوران معاصر نظیر موتورهای ارتقایافته Neo4j Vector، Milvus 3 و Weaviate 2، ساختار داده به گونهای طراحی شده که هر گره (Node) و هر یال (Edge) در گراف دانش نه تنها دارای ویژگیهای رابطهای سنتی است، بلکه بردار امبدینگ اختصاصی خود را در ساختار درختی Hierarchical Navigable Small World (HNSW) به صورت پیوسته حمل میکند.
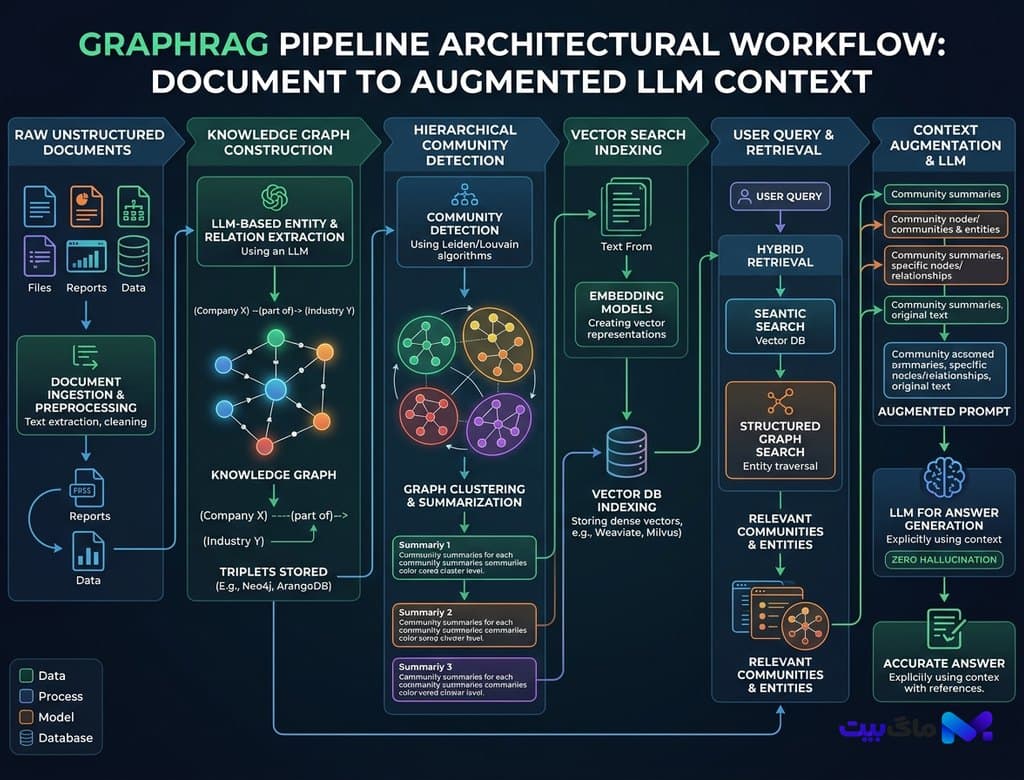
هنگامی که پرسش پیچیدهای به پایگاه داده ارسال میشود، پایپلاین بازیابی در دو مرحله هماهنگ عمل میکند: نخست، با جستجوی برداری سریع، مناسبترین گرههای ورودی (Anchor Nodes) در گراف شناسایی میشوند. بلافاصله در مرحله دوم، الگوریتمهای پیمایش گراف مانند Personalized PageRank و Breadth-First Search فعال شده و همسایگیهای درجه دو و سه، نهادهای متصل، قوانین تجاری و زنجیرههای علی و معلولی را با سرعت زیر ۱۰ میلیثانیه استخراج مینمایند.
این معماری با بهرهگیری از شتابدهندههای سختافزاری که پیشتر در مقالاتی مانند تحلیل پردازش موازی و دیتابیسهای ابری با Polars و cuDF تحلیل شده بودند، میلیاردها یال گرافی را در حافظه رم کارتهای گرافیکی پویش میکند و خروجیهایی ۱۰۰ درصد مستند و بدون کوچکترین توهم تولید مینماید.
استخراج خودکار موجودیتها و روابط با مدلهای استدلالگر در پایپلاینهای بلادرنگ
بزرگترین مانع تاریخی استقرار گرافهای دانش، فرآیند پرهزینه، زمانبر و دستی تدوین آنتولوژیها (Ontology Engineering) توسط متخصصان انسانی بود. امروزه این مانع تاریخی با ورود مدلهای استنتاج عمیق و ایجنتهای خودمختار به کلی برچیده شده است. سیستمهای سازمانی مدرن از پایپلاینهای اتوماتیک موسوم به Dynamic Triplet Ingestion بهره میبرند.
در این پایپلاینها، اسناد خام، گزارشهای مالی و رکوردهای پایگاههای داده رابطهای بلافاصله پس از ورود به زیرساختهای ذخیرهسازی ابری شخصی و سازمانی، توسط ایجنتهای تخصصی مجهز به پروتکل ارتباطی بین ایجنتها (A2A) و هماهنگی ازدحامی پردازش میشوند. این ایجنتها با تفکیک دقیق موجودیتها و اعتبارسنجی منطقی، گراف را به صورت بلادرنگ بازسازی و بهروزرسانی میکنند.
حتی در شاخههای فوقپیشرفته نظیر کشف ابررساناها و مواد کوانتومی با هوش مصنوعی مولد ، این پایگاههای داده به فیزیکدانان اجازه میدهند تا پیوندهای پنهان میان ترکیبات کریستالی گوناگون را با ترکیب شهود معنایی و روابط قطعی کریستالوگرافی کشف نمایند.
مقایسه میدانی عملکرد ابزارها و راهنمای استقرار در سرورهای ابری و محلی
بررسیهای بنچمارک صنعتی امروزه نشان میدهد که سیستمهای مبتنی بر GraphRAG هیبریدی در معیارهای وفاداری پاسخ (Faithfulness) و پوشش محتوایی (Answer Relevance)، نسبت به معماریهای RAG خطی سنتی تا ۸۲ درصد بهبود را به ثبت رساندهاند. همچنین نرخ پاسخهای اشتباه در پرسشهای با وابستگی عمیق به کمتر از ۱.۵ درصد تقلیل یافته است.
برای تیمهای مهندسی که به دنبال استقرار این راهکار در سرورهای محلی یا کلاد هیبریدی هستند، ابزارهای متعددی توسعه یافتهاند. فریمورکهای جدید امکان استقرار یک کلاستر ترکیبی را با کانتینرهای Docker و پیکربندیهای بهینهسازی حافظه در کمتر از چند دقیقه فراهم میسازند. با ادغام این دیتابیسها در قلب پایپلاینهای تحلیلی، کسبوکارها سرانجام به ابزاری دست یافتهاند که ساختار داده را همانند ذهن انسان درک میکند: شبکهای بینهایت از ایدههای مرتبط که هر لحظه بر پایه دانش نو بازآفرینی میشوند.
پایگاههای داده برداری بدون گراف امروزه به گذشته پیوستهاند؛ آینده مهندسی داده در گرو همزیستی ریاضیات توپولوژیک و فضاهای معنایی متراکم است.
بیشتر از فناوری



