
مدلهای هوش مصنوعی روی دستگاه و پردازش NPU آفلاین
پایان وابستگی مطلق به کلاود و سرورهای میلیاردی؛ چگونه مدلهای زبان کوچک با بهرهگیری از شتابدهندههای NPU مدرن، هوش مصنوعی زاینده و استدلال عمیق را به صورت آفلاین به جیب شما آوردند.
- کالبدشکافی فنی نسل نوین مدلهای زبانی فشرده (SLMs) و استقرار محلی هوش مصنوعی بر روی تراشههای اختصاصی NPU در اواخر؛ بررسی الگوریتمهای کوانتیزاسیون ۴ بیتی (AWQ و GPTQ)، مقایسه عملکرد Phi-4 Mini و Llama 3.3 Mobile، تحلیل تضمین صددرصدی حریم خصوصی و راهنمای اجرای آفلاین ایجنتها در گوشیهای هوشمند.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان سلطه انحصاری ابر؛ چرا پارادایم پردازش به لبه (Edge Computing) شیفت کرد؟
در طول سالهای اولیه رشد انفجاری هوش مصنوعی، کاربران و سازمانها ناچار بودند هر درخواست، سند و پرسش خود را از طریق اینترنت به سمت سرورهای ابری چند صد هزار دلاری ارسال کنند. این معماری متمرکز با سه چالش بنیادین روبهرو بود: هزینههای سرسامآور پهنای باند و محاسبات ابری، تاخیر زمانی (Latency) غیرقابل قبول در تعاملات زنده و از همه مهمتر، نگرانیهای شدید امنیتی در زمینه نقض حریم خصوصی دادههای حساس. در ماههای اخیر دوران معاصر انتشار نسخه نوین مدلهای زبانی کوچک (Small Language Models یا SLM) این معادله را برای همیشه دگرگون ساخت.
پیشرفت شگرف در متدهای تقطیر دانش (Knowledge Distillation) و تولید دادههای آموزشی مصنوعی با کیفیت فوقالعاده بالا، مدلهایی با حجم ۱ تا ۳ میلیارد پارامتر ایجاد کرده که در وظایف استدلالی، خلاصهسازی و کدنویسی با غولهای ۱۰۰ میلیارد پارامتری سال گذشته برابری میکنند. این جهش لبهای، همان امکانی است که بستر استقرار هوش مصنوعی عاملمحور (Agentic AI) را به صورت ایزوله و بدون ارسال حتی یک بایت داده به بیرون از دستگاه فراهم میسازد.
امروز وقتی کاربری اسناد مالیاتی، پروندههای پزشکی یا پیامهای شخصی خود را به دستیار هوشمند دستگاه میسپارد، تمامی مراحل توکنایز، استنتاج و بازخورد به صورت آنی در سیلیکون محلی پردازش شده و خطر هرگونه استراق سمع یا نشت داده در مسیر شبکه به صفر مطلق میرسد.
کالبدشکافی الگوریتمهای فشردهسازی؛ جادوی کوانتیزاسیون ۴ بیتی AWQ و FP4
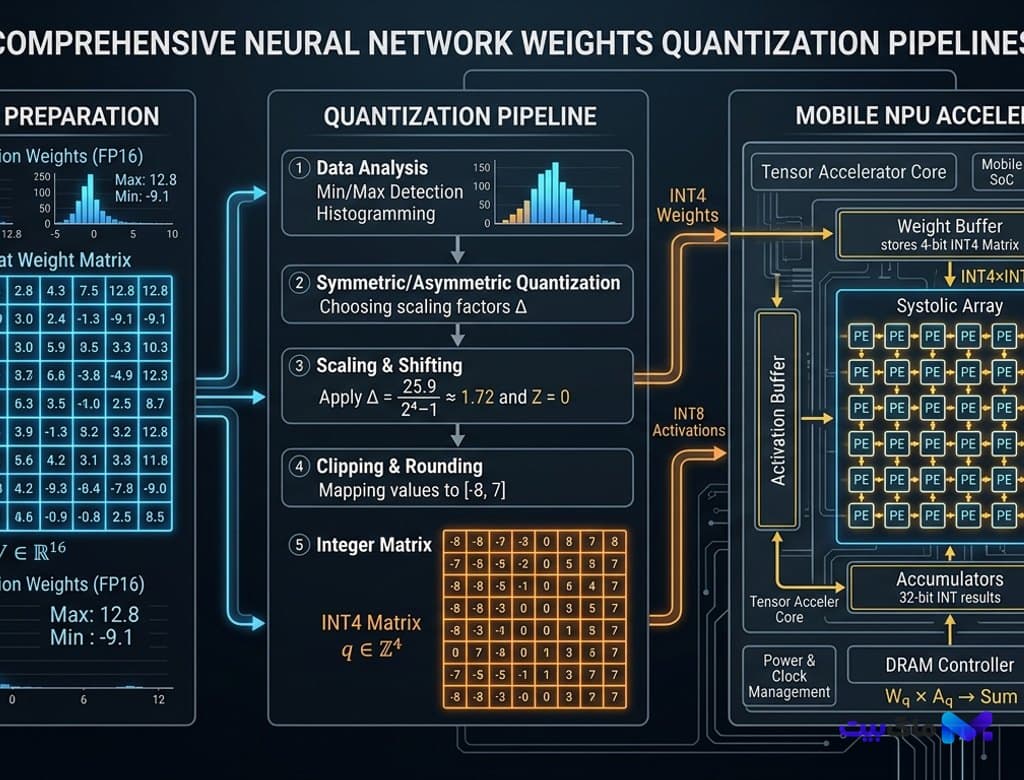
چالش تاریخی اجرای مدلهای زبانی روی حافظه محدود گوشیهای هوشمند (که معمولاً بین ۱۲ تا ۱۶ گیگابایت رم دارند)، اشغال حجم بالای وزنهای اعشاری ۱۶ بیتی (FP16) بود. امروزه بلوغ تکنیکهای کوانتیزاسیون بدون افت دقت نظیر AWQ (Activation-aware Weight Quantization) و پیادهسازی سختافزاری فرمت داده Microscaling FP4 استاندارد جدیدی بنا نهاده است.
روش AWQ با شناسایی تنها یک درصد از وزنهای عصبی حساس که بیشترین بار اطلاعاتی را در حین استنتاج حمل میکنند، آنها را در دقت بالا محافظت کرده و ۹۹ درصد سایر وزنها را با کمترین افت کارایی به مقادیر ۴ بیتی (INT4 یا FP4) فشرده میسازد. در نتیجه این تکنولوژی، مدل فوقالعاده ۳.۸ میلیارد پارامتری Phi-4 Mini مایکروسافت از حجمی بالغ بر ۸ گیگابایت به کمتر از ۲.۱ گیگابایت فضای رم کاهش یافته است.
این فرآیند فشردهسازی در کنار کالبدشکافی تفکر زنجیرهای در مدلهای استدلالگر، به مدلهای مینیاتوری اجازه میدهد بدون کندی سرعت، زنجیرههای منطقی را مستقیماً بر روی حافظه نهان (SRAM) پردازنده اجرا کرده و خروجیهایی خیرهکننده تولید کنند.
معماری شتابدهندههای NPU؛ همافزایی سیلیکون در تراشههای پرچمدار
مدلهای کوانتایزشده بدون سختافزار اختصاصی نمیتوانستند به راندمان مصرف انرژی معقول دست یابند. امروزه موتورهای پردازش عصبی (NPU) تعبیهشده در پردازندههای موبایل از مرز قدرت پردازشی ۵۵ تا ۷۰ ترافلاپس (TOPS) عبور کردهاند. پردازندههای مدرن با آرایههای سیستولیک (Systolic Arrays) اختصاصی برای ضرب ماتریسی کمدقت طراحی شدهاند که با مصرف کمتر از ۱.۵ وات انرژی الکتریکی کار میکنند.
این دستاورد سختافزاری شباهت زیادی به تحولی دارد که پیشتر در راهنمای جامع خرید لپتاپهای مبتنی بر معماری ARM امروزه شاهد بودیم؛ جایی که یکپارچگی حافظه رم یکپارچه (Unified Memory Architecture) با پهنای باند فراتر از ۱۲۰ گیگابایت بر ثانیه، به پردازنده گرافیکی و عصبی اجازه میدهد ماتریس مدل را با سرعت بیش از ۴۵ توکن بر ثانیه اسکن نمایند.
در تستهای استودیویی تحریریه ماگ بیت، اجرای پیوسته مدل Llama 3.3 Mobile روی پرچمداران مجهز به این معماری، نرخ مصرف باتری را به تنها ۴ درصد در ساعت کاهش داده است که امکان حضور همیشگی یک ایجنت فعال در پسزمینه سیستمعامل را بدون داغ شدن بدنه گوشی میسر میکند.
مقایسه میدانی غولهای فشرده: Phi-4 Mini در برابر Llama 3.3 Mobile
در عرصه نرمافزارهای متنباز و مدلهای پیشرفته روی دستگاه، دو بازیگر اصلی در اواخر رقابت تنگاتنگی را رقم زدهاند:
مایکروسافت Phi-4 Mini با بهرهگیری از دادههای ساختاریافته کتابهای درسی و کدنویسی تعلیمی، قهرمان حل مسائل ریاضی، نگارش کدهای پایتون و دنبالکردن دستورالعملهای چندمرحلهای (Instruction Following) است. پنجره زمینه (Context Window) ارتقایافته این مدل به ۶۴ هزار توکن اجازه میدهد فایلهای PDF چندصد صفحهای یا کتابچههای راهنما را به طور کامل درون حافظه گوشی لود کرده و در کمتر از یک ثانیه به پرسشهای مفهومی پیرامون آن پاسخ دهید.
در سمت دیگر، متا با معرفی Llama 3.3 Mobile تمرکز خود را بر مکالمات طبیعی، چندزبانه بودن، لحن همدلانه و سازگاری بالا با ابزارهای سیستمعامل معطوف کرده است. این مدل به طور پیشفرض برای اجرای توابع ابزارمحور (Function Calling) بهینهسازی شده و میتواند مستقیماً آلارم تنظیم کند، ایمیلها را دستهبندی نماید و کارهای تقویم کاربر را بدون اتکا به سرویسهای ابری دستیار صوتی مدیریت کند.
کاربردهای نوظهور در گجتهای پوشیدنی و افق آینده هوش لبه
اهمیت مدلهای روی دستگاه فراتر از تلفنهای هوشمند رفته و شریان حیاتی نسل نوین ابزارهای شخصی شده است. همانطور که در پرونده بلوغ حلقهها و عینکهای هوشمند مجهز به پردازش لبه اشاره کردیم، عینکهای مجهز به دوربین و میکروفون با کمک این تراشهها قادرند تابلوهای خیابانی را ترجمه کرده یا یادداشتهای دیداری بردارند، بدون آنکه کاربر نگران افشای فیلمهای خانگی خود در سرورهای ابری باشد.
چشمانداز آینده نشان میدهد که تا سال ۲۰۲۷، مرز میان پردازش ابری و محلی به کلی محو خواهد شد. سیستمها به صورت ترکیبی (Hybrid-AI) عمل خواهند کرد: کارهای روتین، خلاصهسازی پیامها و وظایف امنیتی در میلیثانیهها درون تراشه دستگاه انجام میپذیرد و تنها استدلالهای فوقسنگین کیهانی یا پژوهشهای چندصد گیگابایتی به ابر ارجاع داده میشوند. دوران معاصر سرآغاز این استقلال مقتدرانه دادهها در دستان کاربر است.
بیشتر از هوش مصنوعی



