
رونمایی رسمی از مدل استدلالگر OpenAI o1؛ آغاز عصر هوش مصنوعی سیستم ۲، تفکر گامبهگام پنهان و قانون مقیاسپذیری زمان آزمون
تحلیل عمیق معماری هوش مصنوعی OpenAI o1؛ بررسی تفکر سیستم ۲، زنجیره تفکر پنهان، قانون مقیاسپذیری زمان آزمون، یادگیری تقویتی و تحول در حل مسائل نخبگان.
- شرکت OpenAI با رونمایی رسمی از خانواده مدلهای استدلالگر o1 (موسوم به پروژه مرموز Strawberry)، مرزهای هوش مصنوعی مولد را درنوردید. مدل o1 بر خلاف مدلهای سنتی که توکنها را بلافاصله و با تکیه بر همبستگی آماری پیشبینی میکنند، مجهز به تفکر شناختی سیستم ۲ است؛ به این معنا که پیش از پاسخدهی، در پشت صحنه زمان صرف تعمق، آزمون فرضیهها، شناسایی اشتباهات و بازنگری منطقی میکند. این جهش معماری به همراه قانون نوین مقیاسپذیری زمان استنتاج، رکوردهای شگفتانگیزی در المپیاد بینالمللی ریاضی، آزمونهای دکتری علوم پایه و مسابقات کدنویسی بر جای گذاشته است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران پاسخهای نسنجیده؛ چرخش بنیادین از طوطیهای آماری به مغزهای متفکر
در سالهای اخیر، مدلهای زبانی بزرگ نظیر GPT-4 به عنوان شگفتیهای پردازش زبان طبیعی شناخته میشدند، اما یک پاشنه آشیل اساسی همواره منتقدان را نگران میکرد: این سیستمها بیشتر شبیه «طوطیهای تصادفی شگفتانگیز» بودند تا متفکران واقعی. آنها کلمات را بر اساس احتمالات آماری و بدون هیچگونه تأمل عمیق یا ارزیابی پیشینی پشت سر هم میچیدند. همین امر باعث میشد حتی باهوشترین مدلها در مواجهه با یک معمای چندمرحلهای ساده یا یک مسئله اثبات منطقی دچار خطاهای فاحش هذیان (Hallucination) شوند.
اما عرضه رسمی خانواده مدلهای OpenAI o1 (که ماهها در محافل تخصصی با نام رمز پروژه Strawberry از آن یاد میشد)، نقطه عطفی تاریخی در نقشه راه رسیدن به هوش جامع مصنوعی (AGI) رقم زد. در کنار دستاوردهایی چون ادغام موتور جستجوی هوشمند در چتجیپیتی (ChatGPT Search) و کنترل کامپیوتر توسط هوش مصنوعی عاملمحور انتروپیک Claude 3.5 Sonnet، مدل o1 توانسته قابلیتی را به نمایش بگذارد که انسانها از آن به عنوان «فکر کردن پیش از سخن گفتن» یاد میکنند.
سیستم ۱ در برابر سیستم ۲؛ پیادهسازی نظریه دانیل کانمن در سیلیکون
برای درک شاهکار مهندسی OpenAI o1، باید به روانشناسی شناختی و اثر ماندگار دانیل کانمن، برنده فقید جایزه نوبل، یعنی کتاب «تفکر، سریع و کند» رجوع کنیم. کانمن ذهن انسان را به دو سامانه پردازشی تقسیم میکند: سیستم ۱ سریع، غریزی، اتوماتیک و نیازمند کمترین انرژی ذهنی است (مانند خواندن یک تابلو یا جاخالی دادن ناگهانی)، در حالی که سیستم ۲ کند، خودآگاه، تحلیلی، استدلالی و متمرکز بر حل مسائل دشوار است (مانند محاسبه ضرب دو عدد سهرقمی یا بردن یک بازی شطرنج).
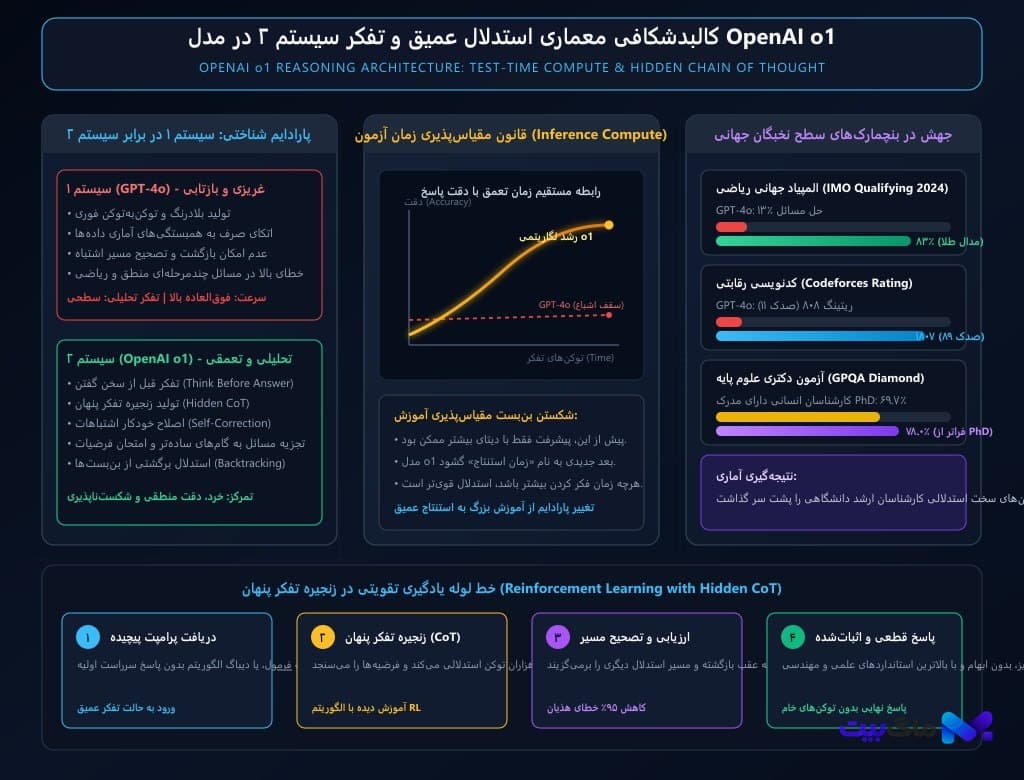
تمامی مدلهای زبانی نسل پیشین (از جمله GPT-4o و Gemini 1.5) نماینده ناب سیستم ۱ بودند؛ آنها برای پاسخ به یک سوال فوقسخت دقیقاً به اندازه یک سلام و احوالپرسی ساده زمان و بار محاسباتی مصرف میکردند. در نقطه مقابل، OpenAI o1 نخستین مدل تجاری جهان است که به سامانه شناختی سیستم ۲ مجهز شده است. این مدل هنگام رویارویی با یک پرامپت چالشبرانگیز، فوراً شروع به تایپ نمیکند، بلکه چند ثانیه تا چند دقیقه سکوت اختیار کرده و زنجیرهای عمیق از افکار داخلی را در کمال تمرکز پردازش مینماید.
قانون نوین مقیاسپذیری زمان آزمون (Test-Time Compute Scaling Law)
در طول یک دهه گذشته، پیشرفت یادگیری عمیق بر مبنای قانون مقیاسپذیری چنچیلا (Chinchilla Scaling Laws) پیش میرفت: هرچه اندازه شبکه عصبی بزرگتر شود و حجم دادههای دوره پیشآموزش (Pre-training) افزایش یابد، هوش مدل ارتقا مییابد. اما در سال ۲۰۲۴، کمبود دادههای باکیفیت و هزینههای نجومی خوشههای ابری نشان داد که این محور در حال رسیدن به محدوده اشباع است.
محققان OpenAI با معرفی o1 بعد سومی را در قوانین مقیاسپذیری بنیان نهادند: «مقیاسپذیری محاسبات در زمان آزمون» (Test-Time Compute). آزمایشهای تجربی اثبات کردهاند که اگر به مدل اجازه داده شود در زمان استنتاج توکنهای تفکر بیشتری تولید کند، نرخ خطای آن به صورت لگاریتمی کاهش مییابد. همانگونه که در تبیین پایههای فیزیک آماری در شبکههای عصبی عمیق و دستاوردهای هاپفیلد و هینتون در یادگیری ژرف مشاهده کردیم، پویایی حالتهای پایدار شبکه عصبی در زمان جستجو نقشی تعیینکننده در حل مسائل بهینهسازی غیرخطی ایفا میکند.
زنجیره تفکر پنهان و یادگیری تقویتی؛ سازوکار تصحیح خودکار خطاها
یکی از برجستهترین ارکان معماری o1، سازوکار «زنجیره تفکر پنهان» (Hidden Chain of Thought) است. برخلاف تکنیکهای مهندسی پرامپت سنتی (مانند CoT دستی)، زنجیره تفکر در o1 مستقیماً توسط الگوریتمهای یادگیری تقویتی در سطح وسیع (Large-Scale RL) بهینهسازی شده است.
در این فرآیند، مدل برای هر تفکر درست پاداش دریافت میکند و یاد میگیرد که استراتژیهای شناختی انسان را در پیش بگیرد:
۱. تجزیه مسئله به زیرمسئلهها: مسئله پیچیده به گامهای کوچکتر و قابل اثبات شکسته میشود.
۲. شناسایی بنبست و بازگشت (Backtracking): اگر مدل متوجه شود مسیری که پیش گرفته به تناقض ریاضی یا بنبست کدنویسی ختم میشود، بدون هراس فرضیه خود را خط زده و مسیر متفاوتی را امتحان میکند.
۳. ارزیابی انتقادی و اعتبارسنجی: مدل خروجی میانی خود را با شبیهسازی نتایج بازبینی میکند. این معماری الهامبخش ساختارهای نسل نوین در مأموران هوشمند و چارچوبهای اتوماسیون فرایندی برای واگذاری وظایف پیچیده مهندسی است.
زلزله در بنچمارکهای نخبگان؛ المپیاد جهانی ریاضی و مسابقات کدنویسی
دادههای منتشرشده توسط OpenAI شگفتآور است. در آزمون مرحله مقدماتی المپیاد بینالمللی ریاضی (IMO Qualifying 2024)، مدل GPT-4o تنها توانست ۱۳ درصد مسائل را حل کند، در حالی که OpenAI o1 با کسب نمره شگفتانگیز ۸۳ درصد، عملاً در سطح برندگان مدال طلای المپیاد ظاهر شد.
در پلتفرم کدنویسی رقابتی Codeforces، مدل o1 به ریتینگ ۱۸۰۷ دست یافت که آن را در صدک ۸۹ تمام برنامهنویسان انسانی مسابقات جهانی قرار میدهد. همچنین در آزمون فوقتخصصی GPQA Diamond که مجموعهای از سوالات بسیار دشوار در سطوح دکتری زیستشناسی، شیمی و فیزیک است، o1 توانست امتیاز ۷۸.۰ درصد را کسب کند و برای نخستین بار در تاریخ، متخصصان انسانی دارای مدرک PhD را پشت سر بگذارد.
جدول مقایسه جامع معماری OpenAI o1 با مدلهای پیشین
در جدول زیر، تفاوتهای کلیدی مدل استدلالگر OpenAI o1 با مدلهای پرچمدار نسل قبل مورد بررسی تطبیقی قرار گرفته است:
| ویژگی معماری و عملکرد | OpenAI o1 (پروژه Strawberry) | OpenAI GPT-4o | Anthropic Claude 3.5 Sonnet |
|---|---|---|---|
| **سامانه شناختی** | سیستم ۲ (کند، تحلیلی و تعمقی) | سیستم ۱ (سریع، غریزی و واکنشی) | سیستم ۱ پیشرفته همراه با درک مصنوعات |
| **زمان تفکر قبل پاسخ** | متغیر بر حسب سختی (۵ تا ۹۰ ثانیه) | صفر (تولید توکن آنی) | صفر (تولید توکن آنی) |
| **نحوه تصحیح خطا** | بازگشت از بنبست در حین تفکر | نیازمند پرامپت بعدی از طرف کاربر | وابسته به هدایت تکمیلی کاربر |
| **المپیاد ریاضی (IMO 2024)** | **۸۳.۰٪ (معادل مدال طلا)** | ۱۳.۴٪ | حدود ۱۵٪ |
| **کدنویسی Codeforces** | **ریتینگ ۱۸۰۷ (صدک ۸۹)** | ریتینگ ۸۰۸ (صدک ۱۱) | ریتینگ حدود ۱۲۰۰ |
| **آزمون دکتری GPQA** | **۷۸.۰٪ (بالاتر از دکترای انسانی)** | ۵۶.۱٪ | ۶۵.۰٪ |
| **مناسب برای** | ریاضیات عالی، علوم پایه، دیباگ پیچیده | مکالمات روزمره، خلاصهسازی، چندرسانهای | کدنویسی رابط کاربری، نگارش خلاقانه |
افق پیشرو؛ ایمنی، کاهش هذیان و آینده علم در دستان هوش مصنوعی استدلالگر
یکی از شگفتانگیزترین مزایای جانبی آموزش زنجیره تفکر با یادگیری تقویتی، ارتقای خیرهکننده ایمنی (Alignment & Safety) است. از آنجا که مدل پیش از صدور پاسخ، قوانین ایمنی و تبعات حقوقی پاسخ خود را نیز در خفا استدلال میکند، آزمونهای نفوذ نشان داده که دور زدن حفاظهای ایمنی (Jailbreaking) در o1 بسیار دشوارتر از تمامی مدلهای پیشین است.
علاوه بر این، در حوزههای حساسی مانند داروسازی، کشف مولکولهای درمانی و طراحی سختافزار، قابلیت استدلال چندگامی o1 میتواند کاتالیزور انقلابی بزرگ باشد. هوش مصنوعی دیگر یک ماشین کپیبرداری از متون اینترنت نیست، بلکه همکار خستگیناپذیری است که پشت میز آزمایشگاه نشسته، فرضیه میسازد، آن را با منطق ریاضی میآزماید و جهان را به سوی کشفیات شگرف هدایت میکند.
بیشتر از هوش مصنوعی



