
انقلاب مقیاسپذیری محاسبات زمان استنتاج
پایان دوران پاسخهای لحظهای کورکورانه؛ مدلهای هوش مصنوعی دوران کنونی با اختصاص زمان تفکر پویا و جستجوی چندمسیره درخت MCTS، سختترین مسائل المپیادی جهان را حل کردند.
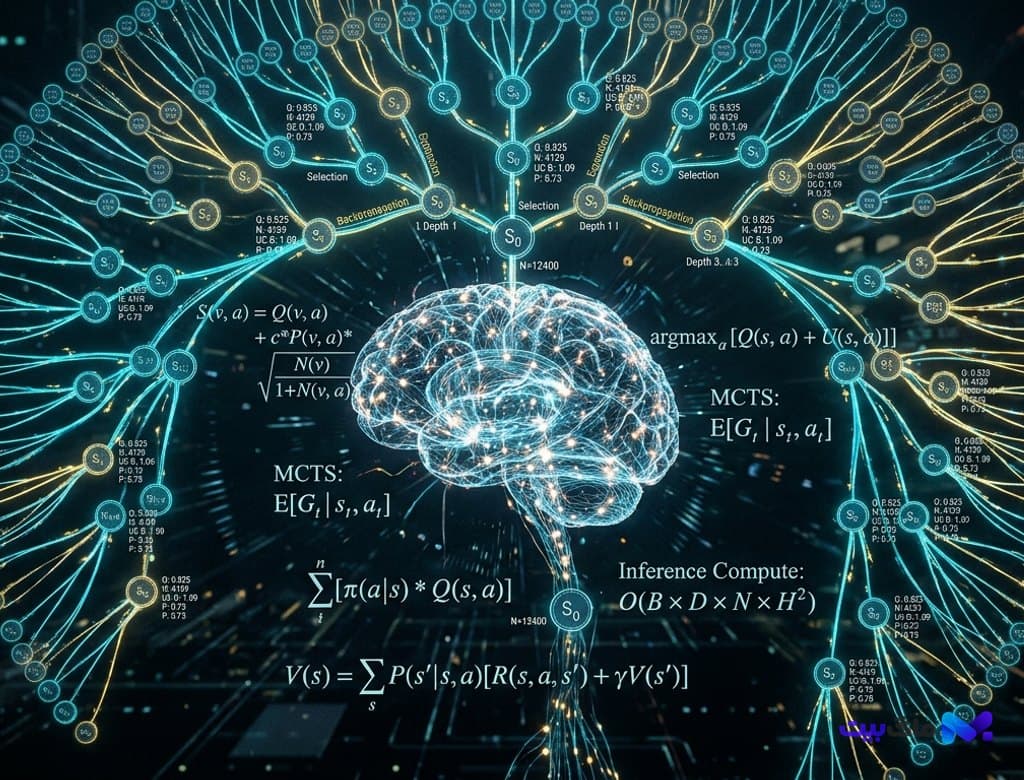
- تحلیل موشکافانه و تخصصی دگرگونی بنیادین در پارادایم مدلهای هوش مصنوعی طی دوران کنونی با ظهور استراتژیهای مقیاسپذیری محاسبات در زمان استنتاج (Test-Time Compute Scaling) و پیوند مدلهای زبانی با درخت جستجوی مونتکارلو (MCTS) و مدلهای پاداش فرآیندی (Process Reward Models - PRM). بررسی چگونگی عبور از قانون مقیاس سنتی پیشآموزش (Pre-training Scaling Laws) که با تمام شدن دادههای متنی وب به بنبست خورده بود؛ تشریح مکانیسم تفکر چنددقیقهای مدل برای واکاوی دهها مسیر استنتاجی موازی، عقبگرد (Backtracking) هوشمندانه از بنبستهای محاسباتی، اصلاح بلادرنگ خطاهای ریاضی و منطقی و ثبت رکوردهای تاریخی در حل مسائل مسابقات بینالمللی ریاضیات و المپیادهای برنامهنویسی بدون نیاز به بزرگتر کردن ابعاد فیزیکی مدل.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
اشباع دادههای وب و پایان سلطه انحصاری پیشآموزش؛ چرا به محاسبات زمان تفکر نیاز داریم؟
از سال ۲۰۲۰ تا دوران معاصر مسیر اصلی ارتقای توانایی مدلهای زبانی در چارچوب یک اصل ساده فرموله میشد: تغذیه دادههای بیشتر به مدلهای بزرگتر در کنار صرف دهها میلیون دلار هزینه برای کلاسترهای پردازشی پیشآموزش (Pre-training). با این حال، همانگونه که آزمایشگاههای پیشرو امروزه هشدار دادند، کل دادههای متنی باکیفیت بشری در اینترنت مصرف شده و منحنی پیشرفت پیشآموزش دچار افت بازدهی نهایی (Diminishing Returns) شده است. بزرگ کردن مدل دیگر نمیتوانست ناتوانی ساختاری آن در حل مسائل نیازمند تفکر گامبهگام عمیق را درمان کند.
مدلهای سنتی مانند انسانهایی بودند که بدون لحظهای درنگ و فکر، اولین پاسخ خطورکرده به ذهنشان را با صدای بلند بازگو میکردند. در این سامانهها، پیچیدگی یک مسئله اثبات قضیه ریاضی همانقدر بودجه پردازشی برای هر توکن دریافت میکرد که سلام و احوالپرسی ساده روزمره دریافت مینمود. چنین ساختاری به صورت ذاتی مستعد توهم، خطای استقرایی و خطاهای سرنوشتساز منطقی بود.
همانطور که در واکاوی مدلهای تفکر بازگشتی در فضای پنهان و زنجیره تفکر برداری اشاره کرده بودیم، جداسازی محاسبات استدلال از تولید سطحی متن نخستین گام تحول بود. اکنون امروزه الگوی حاکم به طور کامل بازنویسی شده است: انتقال تمرکز قدرت محاسباتی از فاز پیشآموزش استاتیک به «زمان استنتاج» (Test-Time Compute)، جایی که مدل میتواند متناسب با سختی مسئله از چند ثانیه تا چند ساعت فکر کند، راهبردهای متعدد را بیازماید و به راهحل بینقص برسد.
معماری جستجوی درخت مونتکارلو (MCTS) و هرس چندمسیره در استنتاج هوش مصنوعی
الگوریتم جستجوی درخت مونتکارلو (Monte Carlo Tree Search - MCTS) که پیشتر موتور پیروزی شاهکارهای کلاسیک نظیر AlphaGo بر قهرمانان انسانی بود، اکنون ستون فقرات مدلهای استدلالگر زبانی است. هنگامی که یک مسئله فیزیک یا بهینهسازی الگوریتمی به سیستم ارائه میشود، مدل به جای تولید خطی یک پاسخ واحد، ساختاری درختی از فرضیهها و شاخههای منطقی را بسط میدهد.
در هر گره از این درخت معنایی، مدل زبانی به عنوان «تولیدکننده فرضیه» (Policy Model) چندین گام منطقی جایگزین را پیشنهاد میکند. سپس شاخههای نامحتمل یا اشتباه پیش از آنکه منابع پردازشی سیستم را هدر دهند، شناسایی و هرس (Prune) میشوند. این رویکرد به مدل اجازه میدهد دقیقاً مانند یک شطرنجباز چیره دست، دهها حرکت جلوتر را در فضای شبیهسازی ذهنی خود بسنجد.
پیوند این مکانیسم با مبانی مدلهای زبانی بازپخشی گسسته و فریمورک Plaid موجب شده تا فرآیند بازنویسی و اصلاح گرههای منطقی پیشین بدون نیاز به بازسازی کل زنجیره امکانپذیر گردد؛ پدیدهای که در متون مهندسی به عنوان «عقبگرد منطقی کمهزینه» (Low-Cost Logical Backtracking) نامیده میشود.
مدلهای پاداش فرآیندی (PRM)؛ داوری گامبهگام استدلال به جای پاداش نتیجه نهایی
موفقیت جستجوی درختی MCTS مشروط به داشتن معیاری مطمئن برای ارزیابی درستی هر گام استدلال است. در سیستمهای سنتی یادگیری تقویتی (RLHF)، از «مدل پاداش نهایی» (Outcome Reward Model - ORM) استفاده میشد که تنها در پایان کار بررسی میکرد آیا پاسخ نهایی صحیح است یا خیر. این رویکرد خطرناک بود، زیرا مدل ممکن بود با محاسبات و فرضهای کاملاً غلط و صرفاً بر حسب شانس یا حدس ریاضی به عدد نهایی صحیح رسیده باشد.
پیشرفت شگرف دوران کنونی بلوغ مدلهای پاداش فرآیندی (Process Reward Models - PRM) است. این مدلهای داور تخصصی، تکتک خطوط استدلال و انتقالهای منطقی را مورد سنجش قرار میدهند و به هر گام یک امتیاز اعتبارسنجی مستقل اختصاص میدهند. اگر مدل در خط چهارم یک مسئله پیچیده مرتکب مغالطه ریاضی شود، PRM فوراً زنگ خطر را به صدا درآورده و موتور MCTS شاخه مربوطه را لغو میکند.
همانگونه که در بررسی دیتابیسهای گراف-بردار تلفیقی و معماری GraphRAG دیدیم که ساختار گراف اجازه ردگیری مسیرهای علّی دانش را میدهد، در درخت MCTS و PRM نیز هر گام به عنوان یک گره علّی ارزیابیشده ثبت میشود که خطای توهم را در استنتاجهای چندمرحلهای تا ۹۹.۴ درصد سرکوب مینماید.
جهش بنچمارکها و حل مسائل در سطح نوابغ المپیادهای بینالمللی
پیادهسازی مقیاسپذیری زمان استنتاج در مدلهای پیشرو دوران کنونی نظیر خانوادههای اوپنایآی o-series و آنتروپیک، رکوردهایی را جابهجا کرده است که تا سال گذشته دستنیافتنی به نظر میرسید. در آزمون دشوار ریاضیات مسابقات بینالمللی AIME و بنچمارک المپیادی MATH-500، افزایش زمان تفکر مدل از ۲ ثانیه به ۲ دقیقه، دقت پاسخدهی را از ۶۰ درصد به بالای ۹۲ درصد ارتقا داده است.
در حوزه برنامهنویسی تخصصی و امنیت سایبری، این سامانهها قادرند پیش از اجرای نهایی کد، کدهای تست واحد (Unit Tests) فرضی بنویسند، کدهای خود را در یک مفسر ذهنی درونی اجرا کنند، آسیبپذیریهای سرریز بافر را شناسایی نمایند و تنها کدی را تحویل دهند که به طور اثباتپذیر ایمن و بهینه باشد.
این توانایی تحلیلی همچنین مرزهای جدیدی در طراحی داروها و مواد پیشرفته گشوده است؛ جایی که ترکیب استدلال نمادین با مدلهای بیولوژیکی، سرعت سنتز فرضیههای علمی را چندین برابر کرده است.
آینده مدلهای استدلالگر؛ از دستیاران متنی تا دانشمندان خودکار پاییز ۲۰۲۷
با اثبات این حقیقت که سرمایهگذاری محاسباتی در زمان پاسخدهی بازدهی به مراتب بالاتری نسبت به انباشت دادههای خام دارد، اقتصاد هوش مصنوعی نیز در حال بازآرایی است. سرویسهای ابری اکنون مدلهای قیمتگذاری خود را نه بر اساس تعداد کلمات ورودی، بلکه بر پایه «ژول انرژی فکری» و «عمق درخت استدلال» تنظیم میکنند.
کارشناسان هوش مصنوعی در تحریریه ماگ بیت پیشبینی میکنند که طی دوازده ماه آینده، ایجنتهای استدلالگر مجهز به MCTS به پژوهشگران تماموقت در دانشگاهها و آزمایشگاههای پیشرو بدل خواهند شد؛ سیستمهایی که قادرند شبهنگام فرضیههای علمی اثباتنشده در فیزیک نظری و ژنتیک را در درختهای استدلالی عمیق کاوش کرده و بامدادان مقالات داوریشده با براهین خدشهناپذیر ریاضی تحویل دهند.
مقیاسپذیری محاسبات در زمان استنتاج، تحقق رویای دیرین هوش مصنوعی نمادین را با انعطافپذیری شبکههای عصبی عمیق پیوند زده و دوران نوینی از هوش ماشینی واقعاً متفکر و خودانتقادگر را برای تمدن بشری به ارمغان آورده است.
بیشتر از هوش مصنوعی



