
مدلهای جهانمدل و هوش فضایی
امروزه هوش مصنوعی صرفاً کلمات را کنار هم نمیچیند، بلکه قوانین جاذبه، برخورد اجسام و دینامیک فضا را شبیهسازی میکند. کالبدشکافی نسل نوین World Models را بخوانید.
- تحلیل موشکافانه گذار از مدلهای زبانی متنی به موتورهای عصبی شبیهسازی فیزیک دنیای واقعی؛ بررسی معماری Google Genie 2، موتور شبیهساز بلادرنگ Oasis، پیوند با معماری V-JEPA و نقش بنیادین آنها در جهش رباتهای انساننما و محیطهای تعاملی دوران معاصر.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
عبور از توکنهای متنی به ماتریسهای فضایی؛ چرا LLMها برای درک واقعیت کافی نبودند؟
برای بیش از نیم دهه، صنعت هوش مصنوعی بر این باور متمرکز بود که با افزایش مقیاس پارامترهای مدلهای زبانی بزرگ (LLM) میتوان به نشانههای هوش فراگیر دست یافت. اما با وجود تسلط این مدلها بر ادبیات، کدنویسی و تحلیل منطقی، یک ضعف بنیادین همواره خودنمایی میکرد: ناتوانی در تجسم هندسه سهبعدی، پیشبینی برهمکنش اشیا و درک شهودی رابطه علت و معلولی در دنیای فیزیکی.
اگر از یک مدل زبانی سنتی میخواستید رفتار یک فنجان لغزنده روی میزی شیبدار را پیشبینی کند، پاسخ متنی دقیقی بر اساس مقالات دانشگاهی ارائه میداد؛ اما در عمل قادر به محاسبه مسیر دقیق واژگونی، زاویه پاشش مایع و نیروی بازدارنده اصطکاک نبود. امروزه جامعه پژوهشی با پرچمداری آزمایشگاههای گوگل دیپمایند و استارتاپ Decart، گام بزرگ تاریخی خود را برداشت: گذار رسمی به عصر «مدلهای جهانمدل» (World Models).
این گذار بنیادین به گونهای طراحی شده که برخلاف رویکردهای پیشین که در کالبدشکافی مدلهای هوش مصنوعی تولید ویدیو در Sora 2 و Runway بررسی کردیم، صرفاً به دنبال تولید پیکسلهای سینمایی چشمنواز نیست؛ بلکه یک ماتریس پویای ۴ بعدی متشکل از هندسه، زمان، تکانه و جرم را در حافظه پنهان خود مدلسازی میکند.
کالبدشکافی معماری Google Genie 2؛ تولید جهانهای سهبعدی تعاملی از دل تصویر منفرد
عرضه Genie 2 توسط گوگل نقطه عطفی در توسعه محیطهای شبیهسازی تلقی میشود. جینی ۲ تنها با دریافت یک تصویر ثابت دوبعدی، یک طرح مفهومی یا حتی یک پرامپت متنی کوتاه، یک جهان تعاملی کامل سهبعدی با زاویه دید آزاد ۳۶۰ درجه تولید میکند که کاربر یا یک عامل نرمافزاری میتواند با کیبورد، ماوس یا کنترلر در آن حرکت کرده و با عناصر محیط دستوپنجه نرم کند.
هسته مهندسی Genie 2 بر مبنای ترکیبی از مدلهای اتورگرسیو فضایی-زمانی (Spatio-Temporal Autoregressive Models) و توکنایزرهای عصبی پیوسته بنا شده است. هنگامی که کاربر دکمه حرکت به جلو را فشار میدهد، مدل بر اساس بردار کنش ورودی (Action Vector)، وضعیت بعدی جهان را با نرخ ثابت ۶۰ فریم بر ثانیه پیشبینی و رندر مینماید. نکته شگفتانگیز، ثبات ساختار اشیا (Object Permanence) است؛ اگر دیواری را دور بزنید و دوباره به نقطه اول بازگردید، آجرها، سایهها و زاویه تابش نور دقیقا بدون ذرهای تغییر بر سر جای خود باقی ماندهاند.
این سطح از پایداری فضایی و استنتاج علت و معلولی دقیقا با آنچه در تحلیل تفکر زنجیرهای در مدلهای استدلالگر o3 و دیپسیک تشریح کردیم همراستاست؛ با این تفاوت که زنجیره تفکر اینبار به جای توکنهای زبانی، در قالب فریمهای دینامیکی فیزیک بازتولید میشود.
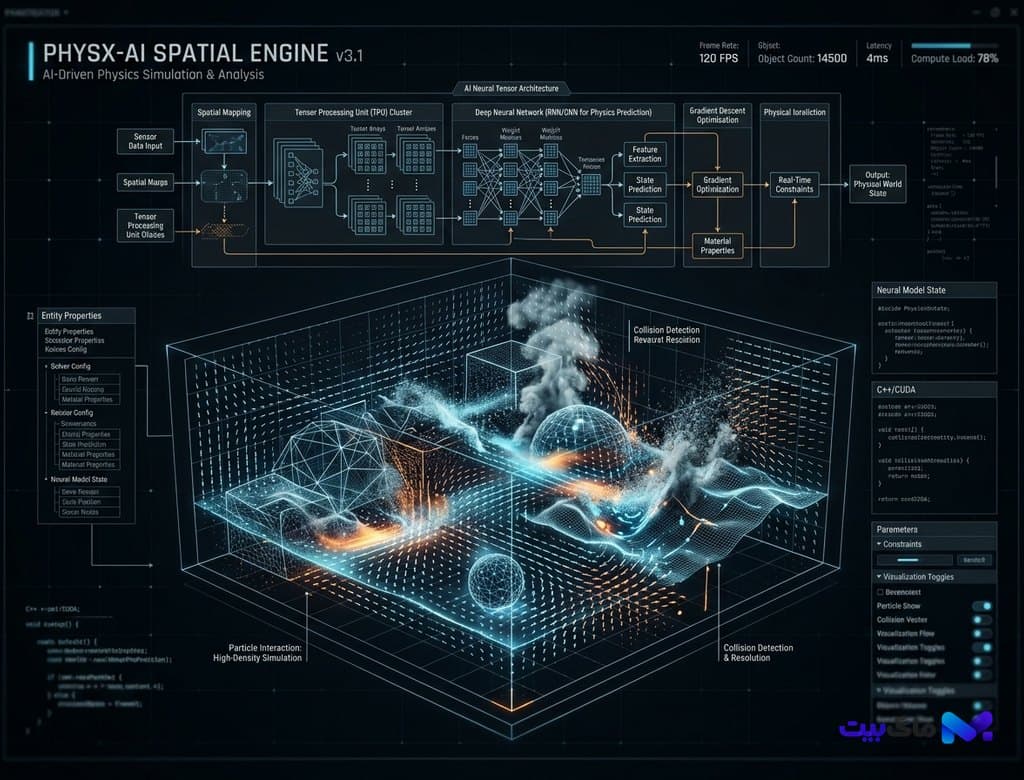
شبیهساز Oasis و موتورهای عصبی بدون کد؛ پایان خط لولههای سنتی رندر سهبعدی؟
شگفتی دیگر دوران کنونی مدل Oasis است؛ نخستین مدل جهانمدل متنباز که بدون استفاده از حتی یک خط کد سنتی، موتور فیزیک، یا فایلهای هندسی سهبعدی (مانند موتورهای Unreal یا Unity)، یک بازی شبیه به ماینکرفت را کاملاً درون لایههای شبکه عصبی شبیهسازی میکند. تمام منطق بازی شامل استخراج بلوکها، سقوط اجسام تحت جاذبه، جریان مایعات و چرخه شب و روز مستقیماً حاصل یادگیری الگوهای آماری از میلیونها ساعت گیمپلی ویدیویی است.
مهندسان با بهرهگیری از تکنیکهای بهینهسازی کوانتیزاسیون وزنها (INT4 و FP8)، توانستهاند تاخیر استنتاجی Oasis را به کمتر از ۱۶ میلیثانیه بر روی پردازندههای گرافیکی تجاری کاهش دهند. این یعنی یک ماشین بدون اینکه بداند مفهوم مثلث یا شیدر در کامپیوتر چیست، در هر لحظه تصویری میسازد که منطبق بر قوانین نیوتنی دنیای واقعی است.
این نوآوری زیرساختی، پیوند مستقیمی با تحولات کلان هوش مصنوعی عاملمحور و سیستمهای خودران امروزه برقرار کرده است؛ چرا که عاملهای هوشمند به جای آزمون و خطای خطرناک و پرهزینه در دنیای واقعی، میتوانند میلیونها سناریوی بحرانی را در این جهانهای عصبی با سرعت هزاران برابر زمان واقعی شبیهسازی و سپری کنند.
معماری V-JEPA یان لکان و یادگیری فضایی در فضای تجرید
یکی از ستونهای تئوریک این دگرگونی، معماری پیشبینی خودرهنمون انرژیمحور مشترک بصری (V-JEPA) است که توسط تیم پژوهشی متا و یان لکان توسعه یافته است. نقدی که لکان همواره به مدلهای مولد پیکسلی وارد میکرد، اتلاف توان پردازشی روی بازسازی تکتک پیکسلهای غیرضروری پسزمینه (مانند حرکت برگ یک درخت) بود.
در V-JEPA، مدل جهان را در فضای ویژگیهای انتزاعی (Latent Embedding Space) پیشبینی میکند، نه در سطح پیکسل خام. این معماری تنها متغیرهایی را پردازش میکند که در نتیجه کنشهای فیزیکی دستخوش تغییر میشوند. به این ترتیب، مصرف انرژی پردازشی تا ۷۰ درصد کاهش یافته و امکان استقرار این مدلها روی پردازندههای لبه (Edge NPUs) در روباتهای خانگی و پهپادهای نسل جدید فراهم آمده است.
کاربرد بنیادین در رباتیک انساننما و خودروهای خودران سطح چهار
اصلیترین مشتریان جهانمدلها امروزه شرکتهای پیشرو در توسعه روباتهای انساننما مانند تسلا (Optimus Gen 3)، بوستون داینامیکس و فیگور هستند. آموزش یک روبات برای برداشتن تخممرغ یا راه رفتن روی یخ در محیط فیزیکی با ریسک آسیبدیدگی بالا و استهلاک قطعات همراه است.
با ادغام مدلهای جهانمدل، روباتها پیش از اعمال ولتاژ به موتورهای مفاصل خود، نتیجه احتمالی لغزش یا فشار پنجهها را در ذهن عصبی خود پیشنمایش میکنند. این تخمین پیشبینانه (Predictive Control) دقت ناوبری و تعادل در محیطهای نامتعین را به شکلی باورنکردنی ارتقا داده و گامی حیاتی به سوی روباتیک کارگاهی عمومی محسوب میشود.
نتیجهگیری و چشمانداز تحریریه ماگ بیت: سپیدهدم بازیهای بیپایان و واقعیت چندگانه
آنچه امروزه پیش روی ماست، صرفاً یک پیشرفت فنی در هوش مصنوعی نیست؛ بلکه بازتعریف ماهیت رسانههای تعاملی، بازیهای ویدیویی و مهندسی نرمافزار است.
در آیندهای نهچندان دور، بازیهای ویدیویی دیگر پکیجهای نصبی ۱۰۰ گیگابایتی نخواهند بود، بلکه بذرهایی نورونی هستند که بر اساس تصمیمات آنی گیمر، داستانی بیپایان با فیزیکی یکتا را خلق میکنند. مدلهای جهانمدل پل نامرئی میان ذهن انسان، قوانین طبیعت و نبوغ محاسباتی ماشین به شمار میروند.
بیشتر از هوش مصنوعی



