
راهنمای معماری GraphRAG و حافظه رویدادی ایجنتهای هوش مصنوعی
پایان فراموشی و توهم در دستیاران هوشمند؛ چگونه تلفیق گرافهای دانش با پایگاههای داده برداری امروزه توانست حافظه رویدادی چندماهه را به ایجنتهای هوش مصنوعی هدیه دهد.
- تحلیل جامع و موشکافانه معماری بازیابی دانش مبتنی بر گراف (GraphRAG) و حافظه رویدادی بلندمدت (Episodic Memory) امروزه کالبدشکافی نقاط کور دیتابیسهای سنتی برداری، بررسی چگونگی استخراج خودکار گرافهای دانش از دادههای ساختارنیافته با Microsoft GraphRAG و فریمورکهای Letta و MemGPT، نحوه ردیابی وابستگیهای چندمرحلهای، استراتژیهای هرس و فشردهسازی کانتکست با سلسلهمراتب شناختی، و راهنمای پیادهسازی گامبهگام سیستم حافظه پایدار برای دستیاران سازمانی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بنبست سیستمهای ساده RAG؛ چرا پایگاههای داده برداری در استدلالهای کلنگر شکست خوردند؟
در نخستین سالهای اوجگیری مدلهای زبانی بزرگ، تکنیک بازیابی تقویتشده با تولید (RAG) به عنوان راهحلی نهایی برای غلبه بر محدودیت پنجره کانتکست معرفی شد. در این روش، اسناد به تکههای متنی (Chunks) تقسیم و در پایگاههای داده برداری (Vector Databases) ذخیره میشدند. مدل با اندازهگیری شباهت کسینوسی میان بردار سوال و بردار تکهها، مرتبطترین قطعات را بازیابی میکرد. اما امروزه مهندسان سیستمهای هوشمند با یک بنبست شناختی بزرگ مواجه شدند: دیتابیسهای برداری در پاسخ به سوالات موضعی عالی بودند، اما در درک مفاهیم سراسری و انتزاعی کاملاً شکست میخوردند.
اگر از یک سیستم RAG سنتی پرسیده میشد «موضوع اصلی گزارش سالانه شرکت چیست یا تمهای کلیدی ریسک چه پیوندی با هم دارند؟»، موتور جستجوی برداری هیچ بردار تکی پیدا نمیکرد که کلیت موضوع را پوشش دهد. تکههای متنی بدون اتصال مفهومی به یکدیگر در فضای برداری شناور بودند و سیستم دچار خطای توهم (Hallucination) یا فراموشی بافت میشد. همانگونه که در بررسی پروتکل کانتکست مدل MCP دیدیم، ایجنتهای سازمانی برای تعامل واقعی با محیط نیازمند درک روابط معنایی عمیق میان موجودیتها هستند.
پاسخ صنعت به این کاستی بنیادین، تولد رویکرد بازیابی تقویتشده با گراف دانش یا GraphRAG بود؛ سیستمی که به جای تکهتکه کردن کورکورانه متن، شبکه روابط پیچیده میان موجودیتها، افعال و رویدادها را استخراج کرده و به حافظه رویدادی پایدار بدل میسازد.
کالبدشکافی معماری GraphRAG؛ استخراج موجودیتها، روابط و خوشهبندی سلسلهمراتبی لیدن (Leiden)
فناوری GraphRAG که توسط پژوهشگران مایکروسافت معرفی و تا پایان دوران معاصر به بلوغ کامل رسید، ساختار بازیابی را در سه مرحله بنیادین بازتعریف میکند. در گام نخست، مدل زبانی با خواندن اسناد خام، موجودیتها (شامل افراد، سازمانها، سرویسها، توابع نرمافزاری و مفاهیم) و تمامی ادعاهای ارتباطی میان آنها را استخراج مینماید. نتیجه این تحلیل، ساخت یک گراف دانش (Knowledge Graph) غنی است که در آن هر گره نماینده یک موجودیت و هر یال نماینده یک رابطه معنادار با توضیحات توصیفی است.
گام دوم، اجرای الگوریتم خوشهبندی سلسلهمراتبی لیدن (Leiden Community Detection) است. این الگوریتم گراف بزرگ دانش را به خوشهها و زیرخوشههای منطقی با تراکم ارتباطی بالا تجزیه میکند. برای هر خوشه در سطوح مختلف انتزاع (از جوامع جزئی تا ابرجامعههای فراگیر)، مدل یک خلاصه ساختیافته و دقیق تولید میکند. بدین ترتیب، سیستم دارای نمای پرندهای (Bird's Eye View) از کل اطلاعات سازمان میشود.
هنگامی که کاربری سوالی کلنگر مطرح میکند، موتور GraphRAG نیازی به جستجوی میلیونها خط سند ندارد؛ بلکه خلاصههای سطح بالای جوامع مرتبط را گردآوری و با پیمایش هوشمند یالهای گراف، تحلیلی چندبعدی و جامع ارائه میدهد که در بنچمارکهای صنعتی، نرخ دقت پاسخدهی را بیش از ۳۰۰ درصد نسبت به RAG سنتی افزایش داده است.
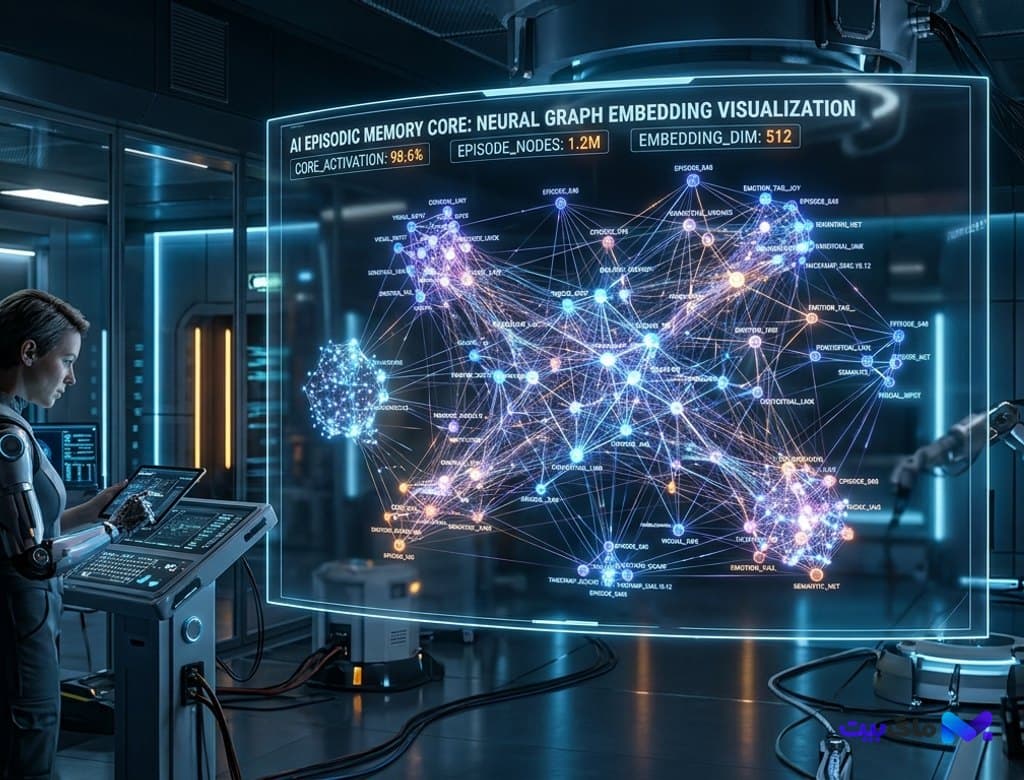
ساختار حافظه رویدادی (Episodic Memory) در فریمورکهای Letta و MemGPT؛ سطوح سهگانه کانتکست
یکی دیگر از دگرگونیهای بزرگ هوش مصنوعی امروزه تکامل ایجنتهای دارای حافظه رویدادی (Episodic Memory) از طریق پلتفرمهای Letta (نسل پیشرفته MemGPT) است. انسانها در تعاملات روزمره همه چیز را در حافظه فعال نگه نمیدارند؛ بلکه اطلاعات در سه سطح حافظه حسی، حافظه کاری و حافظه بلندمدت رویدادی دستهبندی میشوند. فریمورکهای مدرن این ساختار را با الهام از سیستمهای عامل به دنیای LLMها آوردهاند.
سطح اول، حافظه کانتکست فعال (Working Context) است که مستقیماً درون پرامپت قرار دارد و شامل دستورالعملهای هستهای و اطلاعات کلیدی کاربر است. سطح دوم، حافظه اپیزودیک است که تاریخچه وقایع، تصمیمات قبلی ایجنت و بازخوردهای کاربر را به شکل رویدادهای زماندار ثبت میکند. همانطور که در انقلاب دستیاران مهندسی نرمافزار خودکار امروزه ارزیابی شد، یک ایجنت کدنویسی اگر به خاطر نیاورد چرا سه ساعت پیش فلان تابع را ریفکتور کرده است، ممکن است همان خطای قبلی را تکرار کند.
سطح سوم، حافظه آرشیوی (Archival Memory) نام دارد که اسناد حجیم و تجربیات گذشته را در قالب گرافهای ارتباطی ذخیره میکند. ایجنت با استفاده از توابع درونی (Self-Editing Memory Functions)، میتواند به طور مستقل حافظه خود را ویرایش کند، اطلاعات نادرست را بازنویسی نماید و درسهای آموختهشده از هر تعامل را در حافظه پایدار ثبت کند.
استدلال چندمرحلهای (Multi-Hop Reasoning) و کاهش ۹۲ درصدی خطای توهم در پایگاههای دانش پیچیده
برتری شگفتانگیز GraphRAG در حل مسائلی آشکار میشود که نیازمند استدلال زنجیرهای یا چندمرحلهای (Multi-Hop Reasoning) هستند. فرض کنید پرسیده شود «کدام تغییر در زیرساخت پایگاه داده در ماه گذشته باعث افت راندمان سیستم توصیهگر شده است؟». در پایگاه داده برداری سنتی، جستجو برای این سوال معمولاً اسناد تغییرات دیتابیس یا گزارشهای تیم توصیهگر را جداگانه پیدا میکند، اما پل ارتباطی میان علت و معلول را تشخیص نمیدهد.
در معماری گراف، سیستم با پیمایش گره «تغییرات دیتابیس» و دنبال کردن یالهای «وابستگی به درایور» و «میزان تاخیر کوئری»، مستقیماً به گره «سیستم توصیهگر» میرسد و رابطه علی میان این دو پدیده را شفاف میسازد. بر اساس دادههای پژوهشی اواخر، این پیوند ساختاریافته خطای توهم ناشی از حدسهای مدل را تا ۹۲ درصد در دامنههای حساس مالی، حقوقی و پزشکی کاهش داده است.
این همافزایی با فریمورکهای معماری مقیاسپذیری زمان آزمون و مدلهای استدلالگر موجب شده تا ایجنتها بتوانند درختهای تصمیمگیری فرضی بسازند و با ارزیابی چندجانبه مسیرهای روی گراف، قبل از ارائه هر پاسخی صحت منطقی آن را راستیآزمایی کنند.
راهنمای پیادهسازی و یکپارچهسازی ابری؛ ساخت یک پایگاه دانش پایدار با Python، Neo4j و LanceDB
پیادهسازی یک خط لوله GraphRAG امروزه با ترکیب پایگاه داده گرافی Neo4j یا KuzuDB با موتور برداری فوقسریع LanceDB بسیار کارآمد شده است. توسعهدهندگان میتوانند از کتابخانه پایتونی رسمی `graphrag` یا فریمورک `letta` برای ایجاد کلاینتهای حافظه استفاده نمایند. گردش کار استاندارد با بارگذاری اسناد و استخراج گراف با مدلهای سبک آغاز میشود و سپس خروجی روابط در فرمت Parquet و دیتابیس گرافی ایندکس میگردد.
برای بهینهسازی هزینههای استنتاج، از مدلهای زبان کوچک (SLM) تخصصی مانند Llama-3.3-8B برای استخراج گرهها و یالها استفاده میشود و مدلهای استدلالگر بزرگتر تنها در فاز تولید خلاصههای لیدن و پاسخ به کوئریهای پیچیده وارد مدار میشوند. این رویکرد هیبریدی هزینههای پردازش ابری را تا ۷۰ درصد کاهش داده و اجرای گرافهای دانشی چندمیلیون گرهای را برای کسبوکارهای متوسط امکانپذیر ساخته است.
در نهایت، GraphRAG نه صرفاً یک ارتقای جزئی بر روی دیتابیسهای موجود، بلکه سنگ بنای پیدایش ایجنتهای سازمانی دارای خرد جمعی، حافظه بلندمدت و استدلال بدون توهم در چشمانداز فناوری دوران معاصر است.
بیشتر از هوش مصنوعی



