
مقیاسپذیری زمان آزمون و تفکر عمیق MCTS در هوش مصنوعی
پایان دوران انحصار پیشآموزشهای مگاواتی؛ چگونه مدلهای استدلالگر با تکنولوژی Test-Time Compute و جستجوی شاخهای MCTS، قدرت هوش مصنوعی را در زمان پاسخدهی صدها برابر ارتقا دادند.
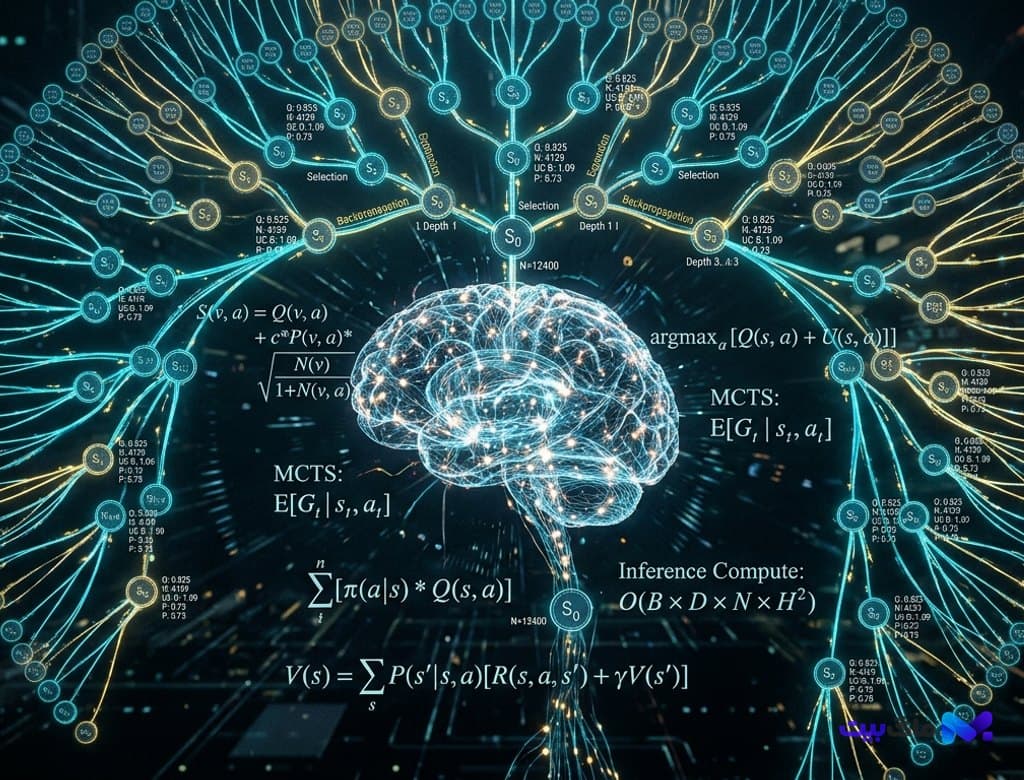
- کالبدشکافی عمیق معماری مقیاسپذیری زمان آزمون (Test-Time Compute) و کاربرد الگوریتم جستجوی درخت مونتکارلو (MCTS) در نسل نوین مدلهای استدلالگر دوران معاصر بررسی تغییر پارادایم از قوانین مقیاس چنچیلا به محاسبات پویا در زمان استنتاج، کالبدشکافی زنجیرههای تفکر خوداصلاحگر در OpenAI o3 و DeepSeek-R1، نقش تاییدگرهای صوری ریاضیاتی نظیر Lean 4 و تحلیل فریمورکهای مدرن vLLM و SGLang در بهینهسازی درختهای استنتاج موازی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران طلایی پیشآموزش خالص؛ چرا قانون مقیاس چنچیلا (Chinchilla) به دیوار فیزیکی برخورد کرد؟
از زمان معرفی ترنسفورمرها تا اواسط دهه جاری، قانون نانوشته صنعت هوش مصنوعی این بود که مدل بزرگتر با دادههای بیشتر و کلاسترهای GPU عظیمتر، همیشه هوشمندتر است. با این حال، امروزه شرکتهای پیشرو با دو مانع مهندسی غیرقابل عبور مواجه شدند: ته کشیدن دادههای متنی باکیفیت انسانی در اینترنت و محدودیتهای فیزیکی تامین انرژی کلاسترهای چند صدهزار تراشهای. مقیاسپذیری پیشآموزش (Pre-training Scaling) وارد فاز بازده نزولی شد، جایی که برای کسب ۱ درصد بهبود در بنچمارکها باید هزینههای پردازشی ۱۰ برابر افزایش مییافت.
این گره کور فنی، زمینه را برای بازتعریف کامل نحوه تخصیص بودجه محاسباتی فراهم ساخت. به جای آنکه تمام محاسبات پیش از استقرار مدل مصرف شود، مهندسان دریافتند که میتوان با اختصاص بودجه پردازشی پویا در لحظه پاسخدهی یا همان «مقیاسپذیری زمان آزمون» (Test-Time Compute Scaling)، دقت و توانایی حل مسئله را به صورت تصاعدی بالا برد. این همان فلسفهای است که در کالبدشکافی تفکر زنجیرهای در مدلهای استدلالگر آغاز شد و اکنون در اواخر به بلوغ کامل رسیده است.
امروز اگر مسئلهای ساده نظیر ترجمه یک جمله مطرح شود، مدل با کسری از ثانیه و کمترین توکن پاسخ میدهد؛ اما در مواجهه با اثبات یک قضیه پیچیده ریاضی یا دیباگ یک هسته لینوکس، سیستم میتواند برای دقایق طولانی هزاران فرضیه مختلف را درون حافظه خود تولید، شبیهسازی و ارزیابی کند تا به پاسخی کاملاً بدون خطا دست یابد.
کالبدشکافی ریاضی Monte Carlo Tree Search (MCTS)؛ مدلها چگونه در درخت تفکر قدم میزنند؟
هسته اصلی مقیاسپذیری در زمان استنتاج، الهامگرفته از سیستمهای کلاسیک بازی نظیر AlphaGo اما بازطراحیشده برای فضای بینهایت زبان طبیعی است. در مدلهای پیشرفته کنونی نظیر OpenAI o3 و رقبای متنباز آنها، فرآیند تولید پاسخ دیگر یک دنباله توکنبهتوکن خطی و حریصانه (Greedy Decoding) نیست، بلکه مبتنی بر الگوریتم جستجوی درخت مونتکارلو (MCTS) هدایت میشود.
در این معماری، هر گره در درخت نشاندهنده یک گام استدلال (Thought Step) است. الگوریتم چهار مرحله حیاتی را به صورت موازی طی میکند: انتخاب (Selection) با استفاده از فرمولهای مرز اطمینان بالا برای درختها (UCT)، گسترش (Expansion) که در آن مدل چندین ایده و فرضیه جایگزین را برای مرحله بعد تولید میکند، شبیهسازی (Simulation) که مسیرهای تفکر را تا رسیدن به نتیجه محتمل جلو میبرد، و در نهایت بازنشر امتیاز (Backpropagation) که ارزش موفقیت یا شکست را به ریشه درخت بازمیگرداند.
این فرآیند به کمک مدلهای زبانی کوچک روی دستگاه (On-Device SLMs) نیز پیادهسازی شده تا ارزیابی شاخهها با کمترین مصرف انرژی انجام شود. در نتیجه، مدل قبل از نگارش پاسخ نهایی، شاخههایی را که به تناقض یا بنبست محاسباتی میرسند هرس (Pruning) کرده و تنها طلاییترین مسیر منطقی را انتخاب میکند.
بازخورد تاییدگر صوری (Formal Verification)؛ نقش Lean 4 و کامپایلرها در داوری استدلال
یکی از بنیادیترین چالشهای جستجوی درخت در زبان طبیعی، توهم هوش مصنوعی (Hallucination) و فقدان مکانیزم داوری قطعی بود؛ مدل ممکن بود شاخهای کاملاً نامعتبر را با بیانی بسیار شیوا و متقاعدکننده گسترش دهد. امروزه ادغام زبانهای اثبات قضیه صوری نظیر Lean 4 و Coq به همراه سندباکسهای اجرای کامپایلر در خط لوله MCTS، این نقص را برای همیشه از میان برد.
وقتی مدل کدی مینویسد یا قضیهای را اثبات میکند، گامهای تولیدشده بلافاصله به یک تاییدگر صوری (Formal Verifier) یا کامپایلر زمان واقعی تحویل داده میشوند. اگر کد در تستهای مرزی شکست بخورد یا گام استقرای ریاضی با خطای کامپایل هسته مواجه گردد، تاییدگر یک سیگنال پاداش منفی بلادرنگ تولید میکند. این بازخورد به عنوان تابع پاداش خارجی عمل کرده و درخت MCTS را مجبور میسازد سریعاً از آن بنبست خارج شود.
این تحول باعث شده در پروژههای پیچیده مهندسی که به نبرد زبانهای برنامهنویسی سیستمی Rust، Zig و Mojo مربوط میشوند، سیستمهای هوش مصنوعی کدهایی با ایمنی تضمینشده تولید کنند که پیشاپیش تمام تستهای حافظه و همزمانی را در زمان استنتاج پاس کردهاند.
نبرد غولهای استنباطی در اواخر؛ مقایسه معماری OpenAI o3 و DeepSeek-R1
بازار مدلهای محاسباتی در زمان آزمون اکنون به دو اردوگاه اصلی تقسیم شده است: معماریهای اختصاصی و بستهمنبع تحت رهبری OpenAI با خانواده مدلهای o3 و o3-mini، و موج خیرهکننده مدلهای متنباز تحت هدایت DeepSeek با معماری R1. هر دو اردوگاه رویکردی مشابه به تخصیص زمان استنتاج دارند اما در مهندسی پیادهسازی تفاوتهای شگرفی نشان میدهند.
مدل OpenAI o3 از سیستم یکپارچه پاداش فرآیندی (Process Reward Models یا PRM) اختصاصی بهره میبرد که به ازای هر توکن تفکر، اعتبارسنجی را انجام میدهد و قابلیت تنظیم داینامیک بودجه استنتاج (از چند ثانیه تا چندین ساعت) را به توسعهدهنده ارائه میکند. در سوی دیگر، DeepSeek-R1 با معرفی استراتژی یادگیری تقویتی خالص بدون دادههای نظارتشده انسانی (Pure RL without Supervised Fine-Tuning) ثابت کرد که مدلها میتوانند تنها با آزمون و خطای مداوم و جستجوی پاداش در زمان آزمون، رفتارهای استدلالی فوقپیشرفته، کالبدشکافی خودکار و اصلاح اشتباهات را به طور خودجوش فرا بگیرند.
این سیستمها بستر بنیادین هوش مصنوعی عاملمحور (Agentic AI) را محقق ساختهاند؛ چرا که ایجنتها اکنون میتوانند ساعتها در پسزمینه بدون افت تمرکز یا گیج شدن در حلقههای باطل، برنامههای کاری چندمرحلهای را برنامهریزی و اعتبارسنجی نمایند.
بازتعریف زیرساخت سرور؛ فریمورکهای vLLM و SGLang در مدیریت حافظه KV Cache درختی
تولید هزاران شاخه استدلال موازی و ادغام آنها در درخت MCTS، بار محاسباتی عظیمی بر حافظه پرسرعت گرافیکی (VRAM) کلاسترها تحمیل میکند. ذخیرهسازی دادههای کلید-مقدار (KV Cache) برای دهها شاخه تفکر همزمان، دیتاسنترها را با بحران کمبود حافظه مواجه کرده بود. برای حل این مشکل، موتورهای پیشرفته استنتاج نظیر vLLM 0.7 و SGLang با نوآوری RadixAttention و ساختار درختی کَش وارد میدان شدند.
تکنیک RadixAttention به موتور استنتاج اجازه میدهد تاریخچه توکنهای پیشین و شاخههای مشترک تفکر را بدون کپیبرداری مجدد در حافظه، در قالب یک درخت پیشوندی (Prefix Tree) به اشتراک بگذارد. زمانی که یک شاخه جدید از گره تصمیمگیری جوانه میزند، بیش از ۸۰ درصد از KV Cache شاخههای والد بازاستفاده میشود که منجر به کاهش ۵ برابری مصرف VRAM و جهش ۳۰۰ درصدی در نرخ خروجی توکنها بر ثانیه گشته است.
با گسترش ارکستراسیون سیستمهای چندعاملی، ترکیب فریمورکهای سرورلس با مدلهای مقیاسپذیر در زمان آزمون، هزینه استنتاج مسائل علمی و مهندسی را به شدت مقرونبهصرفه ساخته و عصری نوین از کشف حقایق منطقی را رقم زده است.
بیشتر از هوش مصنوعی



