
پایگاههای داده برداری (Vector DB)؛ موتور جستجوی هوش مصنوعی
با انفجار حجم اِمبدینگهای هوش مصنوعی امروزه پایگاههای داده وکتور با تکیه بر درگاههای پرسرعت CXL و پردازش مستقیم روی GPU، مرزهای سرعت جستجوی شباهت را به محدوده زیر-میلیثانیهای کشاندهاند.
- تحلیل عمیق مهندسی نسل نوین پایگاههای داده وکتور (Vector DBs) امروزه بررسی گلوگاههای ساختار درختی و گرافهای HNSW در پردازندههای سنتی، یکپارچهسازی با پروتکل اشتراک حافظه CXL 3.1، شتابدهی توسط هستههای تانسوری GPU و کتابخانههای cuVS، و ارزیابی استراتژیهای جستجوی هیبریدی معنایی در مقیاسهای دهها میلیارد بردار.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بحران ابعادی در پایگاههای داده برداری و ناکارآمدی CPUهای سنتی
در سالهای اولیه فراگیری معماریهای بازیابی افزوده با تولید (RAG)، تیمهای مهندسی به استقرار نمایههای برداری ساده بر روی حافظههای اصلی پردازندههای مرکزی (CPU) با استفاده از الگوریتمهای سنتی مانند IVF-Flat بسنده میکردند. با این حال، با ظهور مدلهای چندوجهی مدرن و اِمبدینگهای غنی با ابعاد فراتر از ۴۰۹۶، مجموعههای داده شرکتی به سرعت به مقیاسهای دهها میلیارد بردار رسیدند و بحران محاسباتی شدیدی را رقم زدند.
در پردازندههای استاندارد x86 و ARM، پیمایش تصادفی در ساختارهای گرافی فشرده نظیر «دنیای کوچک ناوبری سلسلهمراتبی» (HNSW)، منجر به بروز فاجعه کشپریسی (Cache Miss) مکرر در سطوح L2 و L3 میشود. در این وضعیت، بیش از ۷۰ درصد چرخه حیات کلاک پردازنده صرف انتظار برای واکشی دادهها از رمهای کند DRAM میگردد؛ امری که تأخیر پاسخگویی (P99 Latency) را به دهها میلیثانیه رسانده و هزینه توان مصرفی را نجومی میکرد.
این چالش ارتباط مستقیمی با تقاضای عظیم محاسباتی در معماری ازدحام هوشمند سیستمهای چندعاملی خودمختار دارد؛ جایی که دهها عامل نرمافزاری به طور همزمان نیازمند کوئری زدن لحظهای به حافظه مشترک برای بازخوانی شواهد و کدهای مرتبط هستند.
جهش معماری با پروتکل CXL 3.1 و استخرهای حافظه نامتمرکز (Disaggregated Memory)
تحول بنیادین زیرساختهای داده امروزه با بهرهگیری از پورتهای اتصال سریع Compute Express Link (CXL نسخه ۳.۱) رقم خورد. تا پیش از این، ظرفیت حافظه رم هر سرور فیزیکی توسط سوکتهای پردازنده و استانداردهای DDR5 محدود بود. پروتکل CXL این محدودیت را از میان برداشته و مفهوم «استخرهای حافظه اشتراکی بدون سربار» را محقق ساخته است.
در این ساختار، یک سرور پایگاه داده میتواند به ترابایتها حافظه رم اشتراکی با تأخیر دسترسی کمتر از ۱۲۰ نانوثانیه متصل شود، بدون آنکه نیازی به تبادل پرهزینه بستههای شبکه TCP/IP یا پروتکلهای سنتی کلاسترینگ باشد. این همگامی حافظه، امکان نگهداری کل ساختار گرافهای غولپیکر HNSW و وکتورهای متراکم را درون یک فضای آدرسدهی واحد و پیوسته فراهم میکند.
امنیت این دادههای برداری حجیم در برابر دسترسیهای غیرمجاز با بهرهگیری از پروتکلهای سختافزاری تضمین میشود؛ الگوهایی که ساختار آنها با اصول تشریحشده در محاسبات ابری محرمانه با یونیکرنلهای Rust و اتصال CXL 3.1 کاملاً انطباق دارد و ایزولاسیون کامل را بر بستر مموری فراهم میآورد.
شتابدهی GPU و کتابخانههای cuVS؛ پردازش موازی تقریب نزدیکترین همسایه
در سطح پردازش ریاضی، الگوریتمهای جستجوی تقریب نزدیکترین همسایه (Approximate Nearest Neighbor یا ANN) اساساً شامل ضربهای نقطهای (Dot Product) و محاسبات فاصله کسینوسی و اقلیدسی میان بردارها هستند. این عملیات ماهیتی کاملاً موازیپذیر دارند و شتابدهندههای گرافیکی بهترین بستر برای اجرای آنها به شمار میروند.
امروزه شرکت انویدیا و جامعه متنباز با انتشار نسخه ۲.۵ کتابخانه cuVS (تکاملیافته از پروژه RAPIDS RAFT)، انقلابی در این حوزه ایجاد کردند. الگوریتمهای نوین گرافمحور مانند CAGRA (CUDA-Accelerated Graph for Rapid ANN) که برای معماری پردازندههای گرافیکی بهینهسازی شدهاند، با پرهیز از شاخهبندیهای شرطی واگرا (Divergent Branching)، توانستهاند نرخ پردازش کوئریها را به بیش از ۱۰۰,۰۰۰ درخواست در ثانیه بر روی یک GPU منفرد برسانند.
این شتابدهی نه تنها زمان اجرای کوئری را به محدوده حیرتانگیز زیر ۳۵۰ میکروثانیه تقلیل داده، بلکه مصرف انرژی به ازای هر کوئری را تا ۹۲ درصد در مقایسه با کلاسترهای سنتی مبتنی بر پردازندههای سرور کاهش داده است. در افقهای دورتر، ترکیب این موتورها با پردازندههای فوتونیکی سیلیکونی میتواند سرعت ضرب برداری را باز هم بالاتر ببرد.
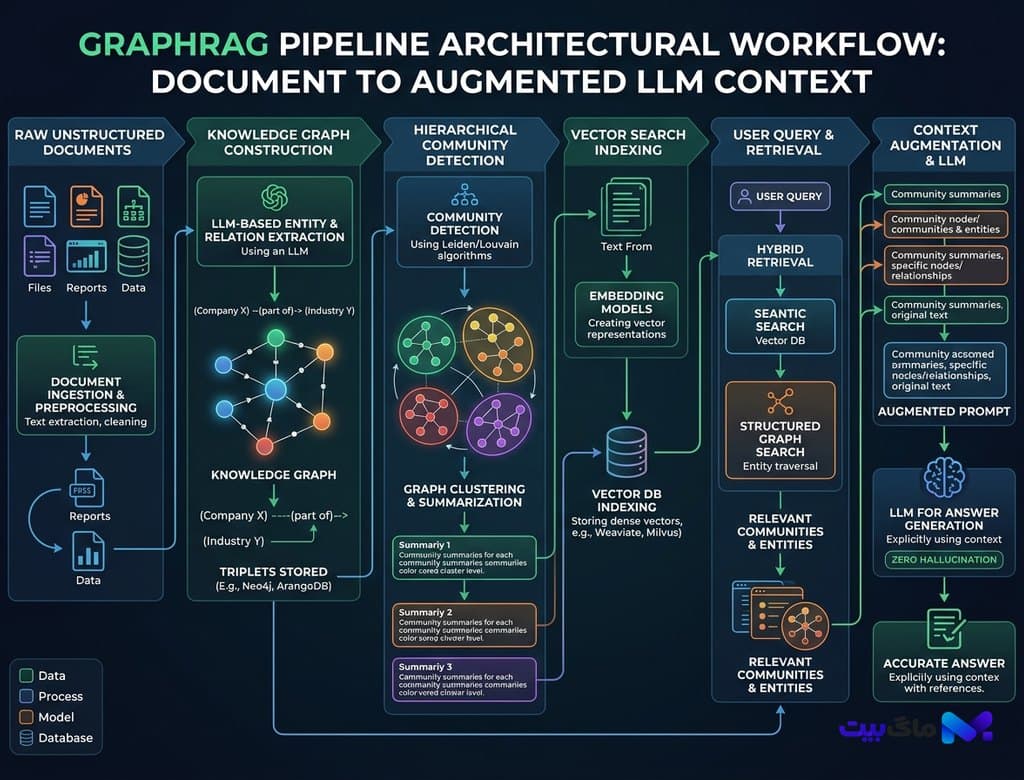
کوئریهای هیبریدی معنایی؛ ترکیب چگال-پراکنده (Dense & Sparse) در مقیاس صنعتی
پایگاههای داده برداری مدرن امروزه دیگر صرفاً به تطابق معنایی بردارهای متراکم (Dense Embeddings) متکی نیستند، زیرا این روشها گاهی در جستجوی کلیدواژههای دقیق فنی، شماره سریالها یا نامهای خاص دچار خطا میشوند. رویکرد استاندارد صنعتی امروز، استفاده از ساختار نمایهسازی چندگانه هیبریدی (Hybrid Dense-Sparse Indexing) است.
در این تکنیک، بردارهای متراکم مشتقشده از مدلهای زبانی با متدهای لکسیکال پیشرفته مانند BM25 و الگوریتمهای بردارهای پراکنده (Sparse Vectors نظیر SPLADE v3) درون یک گراف واحد تلفیق میشوند. با بهرهگیری از محاسبات ممیز شناور FP8 و کوانتیزاسیون هوشمند برداری (Product Quantization)، اندازه حافظه مورد نیاز برای هر بردار به کمتر از یکچهارم کاهش مییابد بدون آنکه دقت بازیابی (Recall@10) افت کند.
این یکپارچگی کارایی به سامانههای RAG اجازه میدهد تا با ادغام اسناد کانتکست چندصد هزار توکنی از معماریهای ترکیبی ترنسفورمر-مامبا، پاسخهای کاملاً مستند، بدون خطا و مستدل به کاربران ارائه دهند.
پایگاههای داده و ابزارهای پرچمدار امروزه
چشمانداز اکوسیستم پایگاههای داده وکتور امروزه شاهد بلوغ پروژههای پیشگام زیر بوده است:
۱. پایگاه Qdrant 2.0 (مبتنی بر Rust): مجهز به موتور اختصاصی شتابدهی GPU، پشتیبانی محلی از CXL Direct-Memory و امکان کوئرینویسی همزمان شرطی (Payload Filtering) با سرعت بیرقیب.
۲. موتور Milvus 3.5分布式: معماری ابری-بومی متمرکز بر جداسازی کامل محاسبات و ذخیرهسازی، یکپارچهسازی شده با شتابدهندههای cuVS و پروتکل RDMA بر بستر شبکههای ۲۰۰ گیگابیت.
۳. افزونه pgvector-pro برای PostgreSQL: نگارش بهینهشده با کامپایلر LLVM و پشتیبانی از گرافهای CAGRA که امکان بهرهگیری از پایگاه داده محبوب و پایدار PostgreSQL را برای پروژههای وکتوری سازمانی میسر میسازد.
۴. ابزار بنچمارک VectorDB-Perf: بنچمارک استاندارد صنعت برای ارزیابی نرخ بازیابی، تأخیر P99، سرعت ساخت نمایه (Build Time) و هزینه دلاری به ازای هر میلیون کوئری در شرایط بار واقعی.
نتیجهگیری و چشمانداز زیرساختهای هوش مصنوعی سازمانی
گذار به پایگاههای داده وکتور مجهز به شتابدهندههای سختافزاری، پایانی بر دوران کندی و محدودیت در سیستمهای بازیابی معنایی است. ادغام سختافزارهای حافظه مدرن نظیر CXL با قدرت پردازش موازی GPUها، زیرساختی مقیاسپذیر و بسیار کممصرف پدید آورده است.
این دگرگونی بنیادین نه تنها سرعت و دقت سامانههای RAG را دگرگون ساخته، بلکه زیربنای لازم برای خلق هوشهای مصنوعی همهمنظوره با حافظه دائمی و نامحدود را در دسترس صنایع گوناگون قرار داده است.
بیشتر از فناوری



