
ترکیب ترنسفورمر و مامبا؛ پایان محدودیت حافظه در هوش مصنوعی
امروزه محدودیت کوادراتیک ترنسفورمرها جای خود را به ترکیب نبوغآمیز Mamba-2 و مکانیسمهای توجه داده است؛ مدلی که پنجرههای زمینه چند ده میلیون توکنی را با مصرف حافظه ثابت و سرعت بیسابقه پردازش میکند.
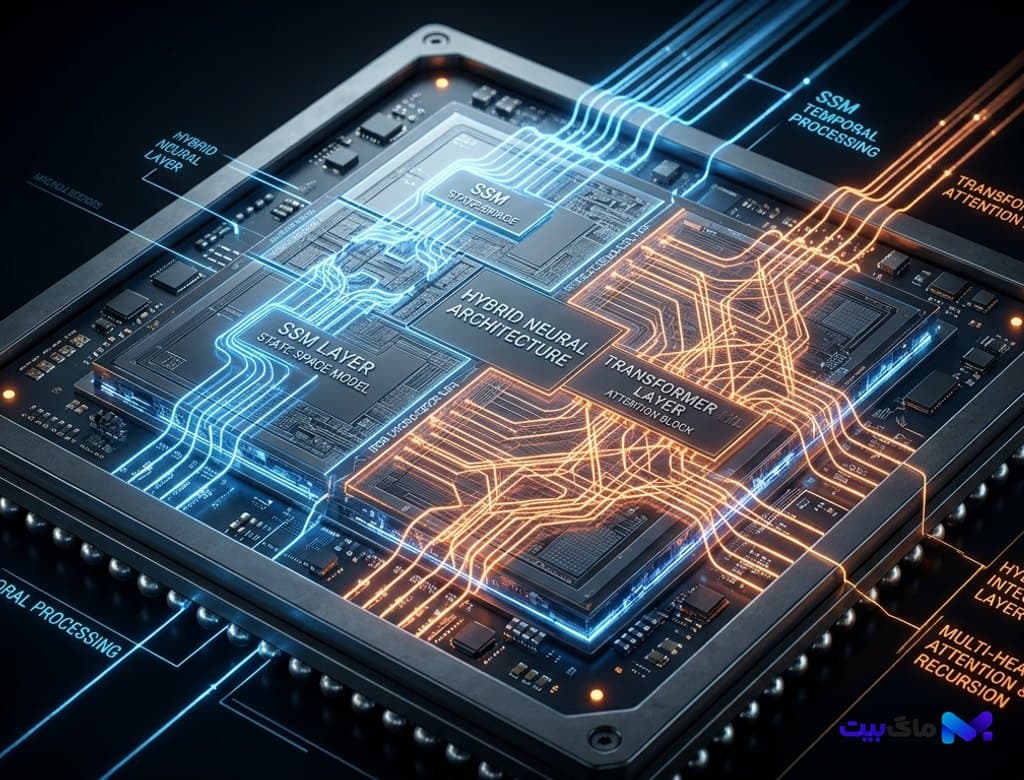
- تحلیل موشکافانه تکامل معماریهای هوش مصنوعی با ظهور هیبریدهای ترنسفورمر-مامبا امروزه بررسی ریاضیات نظریه دوگانگی حالت فضا (SSD)، حذف بحران اشغال حافظه کلید-مقدار (KV-Cache)، دستیابی به پردازش کانتکستهای نامحدود با پیچیدگی خطی O(N)، و ارزیابی بنچمارکهای صنعتی Jamba 1.5 و Samba بر روی سرورهای ابری و شتابدهندههای محلی لبه.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بحران مقیاسپذیری ترنسفورمرها و بنبست کوادراتیک حافظه KV-Cache
از زمان معرفی معماری ترنسفورمر در سال ۲۰۱۷، مکانیسم توجه سراسری (Multi-Head Self-Attention) به عنوان پیشران اصلی انقلاب هوش مصنوعی شناخته شده است. با این حال، ماهیت ذاتی این مکانیسم دارای یک نقص محاسباتی بنیادین است: پیچیدگی زمانی و حافظهای توجه با طول دنباله (Sequence Length) به صورت درجه دوم یا O(N^2) افزایش مییابد. در طول مراحل تولید متن و استدلال استنتاجی، مدل ناچار است تمامی بردارهای کلید و مقدار توکنهای پیشین را در قالب ساختاری موسوم به KV-Cache درون حافظه فوق سریع HBM گرافیکها نگهداری کند.
تا دوران معاصر پردازش کانتکستهای فراتر از ۱ میلیون توکن در مدلهای متداول، به صدها گیگابایت حافظه صرفاً برای ذخیرهسازی KV-Cache نیاز داشت؛ موضوعی که هزینه زیرساخت را نجومی کرده و استقرار مدلها را بر روی پردازندههای لبه و گجتهای هوشمند ناممکن میساخت. هرچند راهکارهایی مانند Grouped-Query Attention و فشردهسازی لایهای ارائه شدند، اما هیچکدام نتوانستند ماهیت رشد خطی ظرفیت حافظه به ازای طول مکالمه را مهار کنند.
این معضل شباهت شگفتانگیزی با چالشهای موجود در مدلهای بینایی-زبانی-اقدامی VLA و رباتیک تجسمیافته داشت؛ جایی که جریان پیوسته دادههای سنسورها و ویدئوی ورودی ربات با تأخیر استنتاجی ترنسفورمرها دچار افت فریم و لرزش حرکتی میشد و نیاز به یک الگوی بازگشتی سریع با حافظه ثابت را بیش از پیش آشکار میکرد.
پایههای ریاضیاتی Mamba-2 و نظریه دوگانگی حالت فضا (SSD)
جهش انقلابی دوران کنونی با بلوغ کامل ریاضیات مدلهای حالت فضا (State Space Models یا SSM) و معرفی نظریه «دوگانگی حالت فضا با توجه» (State Space Duality یا SSD) در چارچوب Mamba-2 رقم خورد. بر خلاف ترنسفورمرها که مستقیماً برهمکنش هر جفت توکن را با یکدیگر محاسبه میکنند، سیستمهای SSM ورودی پیوسته را از طریق یک بردار حالت پنهان بازگشتی با اندازه ثابت فشردهسازی مینمایند؛ رویکردی که هزینه حافظه استنتاج را مستقل از طول متن ورودی و در سطح O(1) تثبیت میکند.
نوآوری کلیدی SSD، یکسانسازی فرمالیسم ریاضی مدلهای حالت فضا با ضرب ماتریسهای تانسوری نیمهتفکیکپذیر (1-Semiseparable Matrices) است. این کشف اجازه داد که الگوریتمهای Mamba بر روی شتابدهندههای موازی مدرن نظیر پردازندههای Tensor Core انویدیا با سرعتی تا ۸ برابر سریعتر از نسخههای اولیه اجرا شوند و برای آموزش نیازی به توابع پیچیده و کند اسکن موازی نداشته باشند.
علاوه بر این، در بستر ریزمعماریهای غیرسیلیکونی، اتصال این الگوریتمها با نوآوریهایی نظیر پردازندههای فوتونیکی سیلیکونی و شتابدهندههای تانسوری نوری موجب شده تا عملگرهای ماتریسی Mamba با سرعت حرکت فوتونها و بدون اتلاف حرارتی ژول در دیتاسنترهای نسل نو پردازش شوند.
معماری ترکیبی Jamba 1.5 و Samba؛ آمیزهای متوازن از استدلال عمیق و سرعت خطی
علیرغم سرعت فوقالعاده مدلهای خالص SSM، آزمایشهای تجربی نشان دادند که شبکههای کاملاً فاقد Attention در آزمونهای دشوار بازیابی دقیق اطلاعات نظیر Needle In A Haystack و استدلالهای زنجیرهای چندمرحلهای (Multi-Hop Reasoning) در مقایسه با ترنسفورمرها با افت خفیف مواجه میشوند. از این رو، برجستهترین شاهکار مهندسی دوران کنونی خلق بلوکهای ترکیبی (Hybrid Architectures) در پروژههای پیشگامی چون Jamba 1.5 توسط AI21 Labs و Samba توسط مایکروسافت بود.
در این الگو، لایههای مدل به صورت یک الگوی متناوب مهندسی شدهاند: به عنوان مثال، از هر ۸ لایه مدل، ۶ لایه از بلوکهای فوق سبک Mamba-2 با پیشبینی حالت پنهان پیوسته تشکیل شده و تنها ۲ لایه به بلوکهای Attention با پنجره محلی اختصاص یافته است. این ترکیب نبوغآمیز سبب میشود که ۸۵ درصد از حجم سنگین حافظه KV-Cache حذف شود، در حالی که حافظه تصویری دقیق و توان استدلال ترکیبی مدل دستنخورده باقی بماند.
در بنچمارکهای جامع منتشر شده در سپتامبر، مدل هیبریدی Jamba-Large با ۳۹۸ میلیارد پارامتر کل و ۹۴ میلیارد پارامتر فعال مبتنی بر ساختار Mixture-of-Experts (MoE)، موفق شد متون حقوقی و کدهای برنامهنویسی با حجم ۱۰ میلیون توکن را بر روی یک سرور منفرد با ۴ کارت گرافیک H200 بدون کمترین افت دقت پردازش کند؛ دستاوردی که اجرای آن در ترنسفورمرهای سنتی دستکم نیازمند کلاستری از ۳۲ شتابدهنده گرانقیمت بود.
کاهش مصرف انرژی و شکوفایی استنتاج بر روی سختافزارهای لبه (Edge AI)
تأثیر دگرگونکننده معماریهای هیبریدی صرفاً به سرورهای ابری محدود نمیشود؛ بزرگترین برنده این گذار، دستگاههای لبه، گوشیهای هوشمند، خودروهای خودران و گجتهای هوشمند هستند. به دلیل حذف وابستگی به رمهای چندده گیگابایتی برای کش توکنها، مدلهای متراکم ۳ الی ۸ میلیارد پارامتری هیبریدی اکنون میتوانند به صورت پیوسته و با مصرف انرژی کمتر از ۵ وات بر روی پردازندههای عصبی (NPU) تلفنهای همراه و گجتهای پوشیدنی اجرا شوند.
این کارایی خارقالعاده، امکان پردازش آفلاین اسناد حجیم، خلاصه کردن ساعتها فایل صوتی جلسات و تحلیل بلادرنگ کدهای منبع را بدون ارسال دادهها به سرورهای خارجی فراهم کرده است. امنیت دادههای پردازششده در این محیطها با اتکا به سازوکارهای سیستمهای محاسبات ابری محرمانه با یونیکرنلهای Rust و استانداردهای CXL در بالاترین سطح استاندارد تضمین میگردد.
از سوی دیگر، همافزایی این مدلهای خطی با حافظههای فوق سریع نظیر حافظههای اسپینترونیک SOT-MRAM و محاسبات درونحافظهای گلوگاه تبادل داده میان پردازنده و رم را به کلی برطرف ساخته و امکان تولید بیش از ۱۲۰ توکن در ثانیه را بر روی سختافزارهای کممصرف باتریمحور محقق ساخته است.
جعبهابزار مهندسی دوران کنونی کتابخانهها و فریمورکهای پیادهسازی هیبریدی
برای توسعهدهندگان و مهندسان هوش مصنوعی امروزه بهرهگیری از مدلهای هیبریدی ترنسفورمر-مامبا به لطف فریمورکهای استاندارد شده به فرآیندی سرراست و بالغ تبدیل شده است. ابزارهای کلیدی این اکوسیستم عبارتند از:
۱. کتابخانه Mamba-SSM 2.2: هسته کامپایلشده CUDA و Triton برای لایههای Mamba-2 که از ادغام مستقیم با کتابخانههای Hugging Face Transformers و vLLM پشتیبانی میکند و سرعت استنتاج دستهای (Batched Inference) را به حداکثر میرساند.
۲. موتور استنتاج vLLM-Hybrid: نسخه بازمهندسی شده vLLM با موتور مدیریت حافظه دوگانه که به طور هوشمند حافظه دینامیک را میان توکنهای بازگشتی Mamba و کش محدود لایههای Attention تخصیص میدهد و قابلیت PagedAttention را با اسکن موازی SSD یکپارچه میسازد.
۳. فریمورک Hugging Face Optimum-SSM: ابزار اختصاصی برای تبدیل، بهینهسازی و کوانتیزاسیون وزنهای مدلهای هیبریدی به فرمتهای ۴ بیتی AWQ و GPTQ، به گونهای که یک مدل ۱۲ میلیارد پارامتری هیبریدی با ظرفیت کانتکست ۲ میلیون توکن به راحتی درون ۸ گیگابایت حافظه رم یک لپتاپ معمولی بارگذاری میشود.
۴. محیطهای بنچمارک Long-Bench نوین: ابزارهای ارزیابی خودکار برای سنجش دقت بازیابی، استدلال صوری، و ثبات خروجی در توالیهای فراتر از چند میلیون کلمه بدون انحراف شناختی یا توهم آماری.
چشمانداز آینده؛ حرکت به سوی مغزهای مصنوعی با حافظه کاری پیوسته و بیپایان
ظهور مدلهای ترکیبی ترنسفورمر-مامبا در ماههای پایانی نمایانگر گامی تاریخی در حل چالش حافظه در هوش مصنوعی است. سیستمهای آینده دیگر مانند مدلهای زبانی گذشته با هر بار ریست شدن پرامپت یا پر شدن کانتکست دچار فراموشی نمیشوند؛ بلکه همانند ساختار ادراکی مغز انسان، اطلاعات گذشته را در ابعاد فشرده و پویا نگهداری کرده و در هنگام نیاز، با تکیه بر لایههای تمرکز انتخابی به جزئیات مراجعه مینمایند.
همگرایی این معماریهای شناختی با جریانهای مداوم چندوجهی و استنتاجهای بلادرنگ، در حال بازتعریف تعامل انسان و ماشین در دستیاران هوشمند شخصی، سامانههای تحلیل دادههای ژنومی و سامانههای هدایت رباتهای خودران است. با تثبیت جایگاه مدلهای SSD و فریمورکهای هیبریدی در صنایع پیشرو، عصر بنبستهای محاسباتی ترنسفورمرها به پایان رسیده و افقهای نامحدودی از هوش مقیاسپذیر در برابر جهان گشوده شده است.
بیشتر از هوش مصنوعی



