
هوش مصنوعی تجسمیافته در رباتیک؛ وقتی رباتها میبینند و عمل میکنند
امروزه رباتیک سنتی مبتنی بر کینماتیک معکوس جای خود را به مدلهای یکپارچه Vision-Language-Action داده است؛ سیستمهایی که فهم فضایی، دستورات صوتی و گشتاور دقیق مفاصل را در یک شبکه عصبی پیوسته پردازش میکنند.
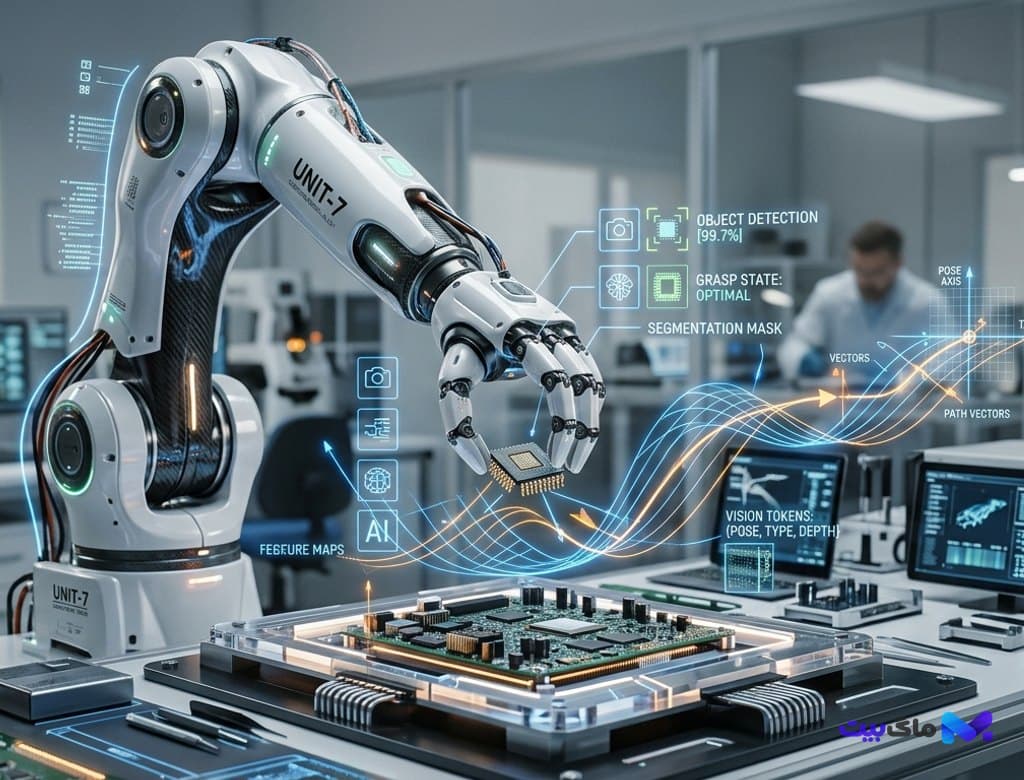
- واکاوی عمیق دگرگونی رباتیک تجسمیافته با ظهور مدلهای Vision-Language-Action (VLA) امروزه تحلیل ادغام ستونفقرات بینایی-زبانی با هدایت کنترلی انتشار پیوسته (Flow Matching)، فریمورکهای مرجع OpenVLA 2 و Hugging Face LeRobot، سازوکارهای تعمیم بین-رباتی (Cross-Embodiment)، و استنتاج لبه با تأخیر زیر ۲۰ میلیثانیه برای استقرار رباتهای انساننما در صنایع و خدمات.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
گذار از کنترل سنتی کینماتیک به هوش تجسمیافته؛ تولد پارادایم VLA
برای دههها، مهندسی رباتیک بر خط لولههای چندتکه و شکننده استوار بود: ابتدا حسگرهای لیدار یا دوربینها دادههای خام را به الگوریتمهای بینایی ماشین ارسال میکردند؛ سپس نقشههای عمق و موقعیت اجسام به ماژولهای برنامهریزی مسیر (Motion Planners) فرستاده میشد؛ و در نهایت، معادلات ریاضی سنگین کینماتیک مستقیم و معکوس (Forward/Inverse Kinematics) گشتاور موتورها را محاسبه میکردند. هر تغییر جزئی در نور محیط، جابهجایی زاویه دوربین یا لغزش یک شیء ناشناخته، کل زنجیره را با خطای محاسباتی مواجه میکرد و ربات را در شرایط بنبست قرار میداد.
اما امروزه جامعه هوش مصنوعی با موفقیت کامل پارادایم «مدلهای بینایی-زبانی-اقدامی» (Vision-Language-Action یا VLA) را به استاندارد غالب صنعت رباتیک تبدیل کرده است. در این معماری، همانگونه که مدلهای زبانی بزرگ متن را به متن تبدیل میکنند، مدلهای VLA توکنهای چندوجهی حاصل از تصاویر دوربین، هشدارهای لمسی و دستورات صوتی انسان را به صورت مستقیم و بدون واسطه به «توکنهای اقدام حرکتی» (Action Tokens) نظیر بردار ۶ درجه آزادی موقعیت گیره و زوایای مفاصل بازو ترجمه مینمایند.
این جهش مفهومی، تشابه شگفتانگیزی با آنچه در تحول مدلهای ترنسفورمر انتشار زمان واقعی DiT و شبیهسازی جهان رخ داد دارد؛ در آنجا فریمهای متوالی ویدئو به عنوان بازنمایی فیزیک جهان درک شدند و در اینجا، اعمال حرکتی ربات به عنوان پاسخ طبیعی هوش مصنوعی به پویاییهای فیزیکی دنیای واقعی مدلسازی میشوند.
معماری فنی OpenVLA 2؛ تطبیق مدلهای زبانی چندوجهی با جریانهای اقدام پیوسته
نسل نوین مدلهای پیشرو، به سرپرستی OpenVLA 2 و معماریهای اقتباسشده از ستونفقرات مدلهای زبانی چندوجهی (مانند Llama-3-Vision و Gemma-V)، از یک شبکه رمزگذار بصری با رزولوشن پویا برای استخراج ویژگیهای محیطی بهره میبرند. چالش بنیادین در طراحی VLAها، شکاف فرکانسی شدید میان زبان و کنترل موتورها بود؛ فرامین زبانی با نرخ چند کلمه در ثانیه صادر میشوند، در حالی که حلقههای کنترل حرکتی مفاصل برای تضمین پایداری مکانیکی نیازمند فرکانسهای ۵۰ الی ۱۰۰ هرتز هستند.
برای حل این چالش، پژوهشگران امروزه معماری «بستهبندی اقدام» (Action Chunking) مبتنی بر مدلهای تطبیق جریان (Flow Matching) و انتشار پیوسته (Diffusion Policies) را جایگزین گسستهسازی سنتی توکنها کردند. مدل VLA به جای پیشبینی موقعیت مفاصل در یک میلیثانیه بعد، یک مسیر برداری پیوسته شامل ۶۴ گام زمانی آتی را در قالب یک توزیع احتمالاتی هموار تولید میکند. سپس یک کنترلکننده محلی کمپایین، این بردار را به صورت روان و بدون لرزش به درایورهای موتور منتقل میسازد.
این ساختار عصبی دقیقاً همان فلسفهای است که در سیستمهای رانندگی خودران مبتنی بر معماری سرتاسر عصبی برای هدایت خودروهای نسل جدید به کار رفته است؛ جایی که برنامهریزی قطعی خطی با سیاستهای عصبی مشتقپذیر و یادگیری تقویتی سرتاسر جایگزین شده تا وسیله نقلیه یا ربات بتواند در شرایط پیشبینینشده رفتاری طبیعی و شبهانسانی از خود نشان دهد.
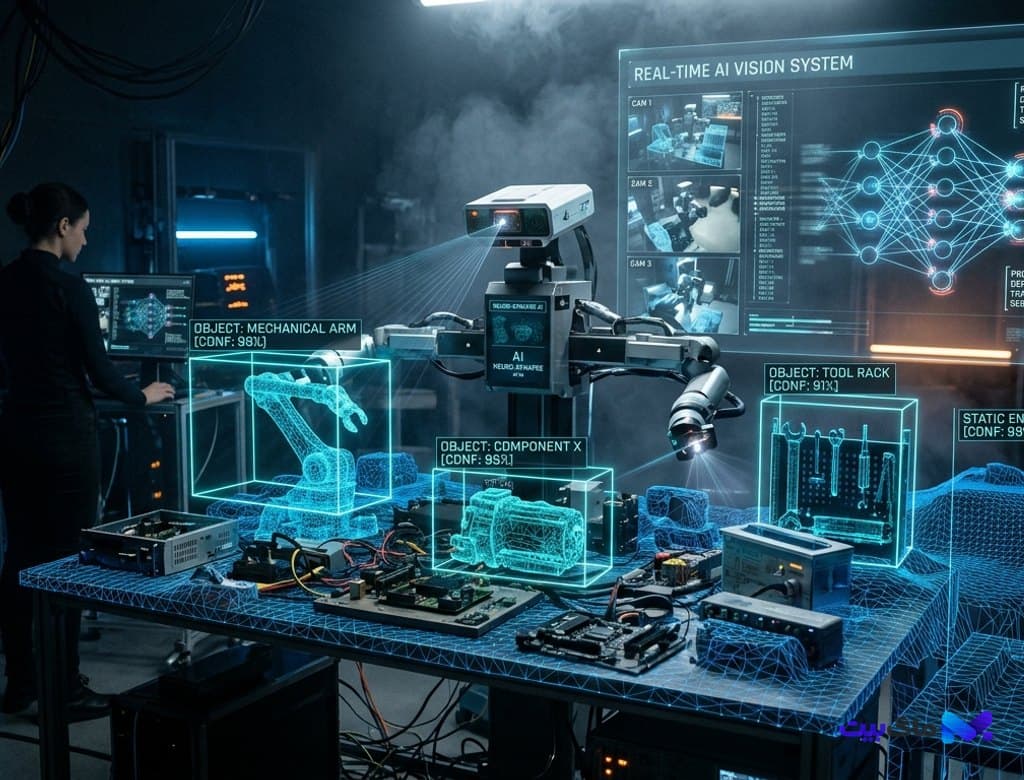
تعمیم بین-رباتی (Cross-Embodiment)؛ یادگیری یکپارچه از بازوهای صنعتی تا انساننماها
بزرگترین دستاورد علمی مدلهای VLA امروزه دستیابی به قابلیت تعمیم فرابدنی (Cross-Embodiment Generalization) است. تا پیش از این، مدلی که برای بازوی صنعتی KUKA آموزش میدید، هیچ درکی از دینامیک بازوی ربات انساننمای تسلا آپتیموس، فیگور ۰۲ یا بازوهای مقرونبهصرفه چاپ سهبعدی نداشت. جمعآوری دادههای تلهاوپریشن (Teleoperation) برای تکتک فرمفکتورهای رباتیک، هزینهای سرسامآور ایجاد میکرد.
فریمورکهای استاندارد با تعریف فضاهای حالت نرمالشده و ماتریسهای تطبیق جنبشی (Kinematic Normalization Embeddings)، موفق شدهاند دادههای آموزشی بیش از ۱۰۰ پلتفرم رباتیک متفاوت را در قالب مجموعه داده عظیم جهانی Open-X-Embodiment 2 ادغام کنند. مدل در طول پیشآموزش، مفاهیم انتزاعی نظیر «برداشتن فنجان»، «پیچاندن درپوش» و «برش با قیچی» را به عنوان اصول فیزیکی و هندسی مستقل از پیکربندی مفاصل فرامیگیرد.
همانگونه که در بررسی مقیاسپذیری محاسبات زمان آزمون و استدلال عصب-نمادین شاهد بودیم که اعتبارسنجی فرآیندها مانع از بنبستهای منطقی میشود، در رباتیک تجسمیافته نیز ترکیب VLA با پاداشهای بازخورد لمسی و هرس شاخههای ناممکن حرکتی، سبب شده تا نرخ موفقیت کارهای فیزیکی ظریف در محیطهای ناآشنا به بالای ۹۲ درصد صعود کند.
جعبهابزار مهندسی دوران کنونی انقلاب فریمورک Hugging Face LeRobot
دموکراتیزهشدن رباتیک متنباز در ماههای اخیر مدیون عرضه و تکامل کتابخانه LeRobot توسط هاگینگفیس و ابزارهای مرتبط در جامعه پژوهشی است. این اکوسیستم مدرن شامل کامپوننتهای حیاتی زیر است:
۱. فریمورک LeRobot Core: کتابخانه تخصصی پایتون برای مصورسازی بلادرنگ دادههای دورعملگری، پردازش ناهمگام استریمهای ویدئویی دوربینهای Realsense، و آموزش مقیاسپذیر سیاستهای کنترلی ACT (Action Chunking with Transformers) و Diffusion Policy.
۲. موتور استنتاج سختافزاری TensorRT-Robotics: بستهای بهینهشده برای شتابدهندههای انویدیا Jetson Orin و چیپهای لبه که اجازه میدهد مدلهای چندمیلیارد پارامتری VLA با تکنیک کوانتیزاسیون FP4 یا INT8 و با مصرف توان زیر ۲۵ وات بر روی ربات مستقر شوند.
۳. سیستم شبیهسازی فیزیکی Isaac Lab نوین: محیط شبیهسازی بر پایه پلتفرم Omniverse با قابلیت تولید دادههای مصنوعی (Synthetic Data) و انتقال بدون شکاف از شبیهسازی به واقعیت (Sim-to-Real) با استفاده از تصادفیسازی دامنههای نوری و فیزیکی.
علاوه بر این، در سطح ریزمعماری سختافزاری، بهکارگیری حافظههای نسل آینده نظیر حافظههای اسپینترونیک SOT-MRAM و محاسبات درونحافظهای این امکان را فراهم کرده تا وزنهای حجیم شبکههای VLA با تأخیر در حد نانوثانیه و بدون اتلاف توان در حالت آمادهباش، مستقیماً در مغز سختافزاری مفاصل ربات اجرا شوند.
چشمانداز صنعتی و چالشهای ایمنی؛ استقرار رباتها در خطوط تولید و منازل
با وجود درخشش مدلهای VLA، استقرار ایمن آنها در مجاورت انسانها مستلزم معماریهای ایمنی چندلایه است. خطای یک مدل زبانی در تولید متن صرفاً یک پاسخ نامربوط ایجاد میکند، اما خطای حرکتی یک بازوی فلزی ۲۰ کیلوگرمی میتواند خسارات فیزیکی جبرانناپذیر به بار آورد. به همین دلیل، امروزه استاندارد ایمنی سختگیرانهای تحت عنوان «حفاظ ایمنی برداری» (Safe Motion Envelope) تعریف شده است که خروجی ترنسفورمرهای VLA را با استفاده از فیلترهای محدودکننده توان و شتاب سختافزاری بازبینی میکند.
صنایع خودروسازی، زنجیرههای تأمین و حتی بیمارستانها در ماههای اخیر اولین دسته از رباتهای مجهز به VLA را در کارهای بدون ساختار مانند چیدمان انبار، مونتاژ کابلهای برق و شستشوی تجهیزات پزشکی مستقر کردهاند. دیگر نیازی به کدنویسی ماهها اسکریپت تخصصی نیست؛ اپراتور صرفاً به زبان طبیعی میگوید «جعبههای مقوایی آسیبدیده را از تسمه نقاله به پالت بازیافت منتقل کن» و ربات با درک هوشمندانه محیط، این وظیفه ظریف را به انجام میرساند.
آینده پیش رو در سالهای ۲۰۲۷ و پس از آن، ادغام مدلهای استدلال جهان با سیستمهای چندعاملی رباتیک خواهد بود؛ جایی که گروههایی از رباتهای همکار با درک متقابل از نیتهای یکدیگر، ساختارهای مهندسی را به صورت کاملاً خودکار و خودران بنا خواهند نهاد.
بیشتر از هوش مصنوعی



