
استدلال در لحظه (Test-Time Compute)؛ راز باهوشتر شدن هوش مصنوعی
امروزه تمرکز آزمایشگاههای مرجع هوش مصنوعی از بزرگتر کردن مدلها در فاز آموزش، به تخصیص هوشمندانه توان پردازشی در زمان استنتاج معطوف شده است؛ جایی که ترکیب جستجوی درختی و اثباتکنندههای صوری نمادین، خطا و توهم را ریشهکن میسازد.
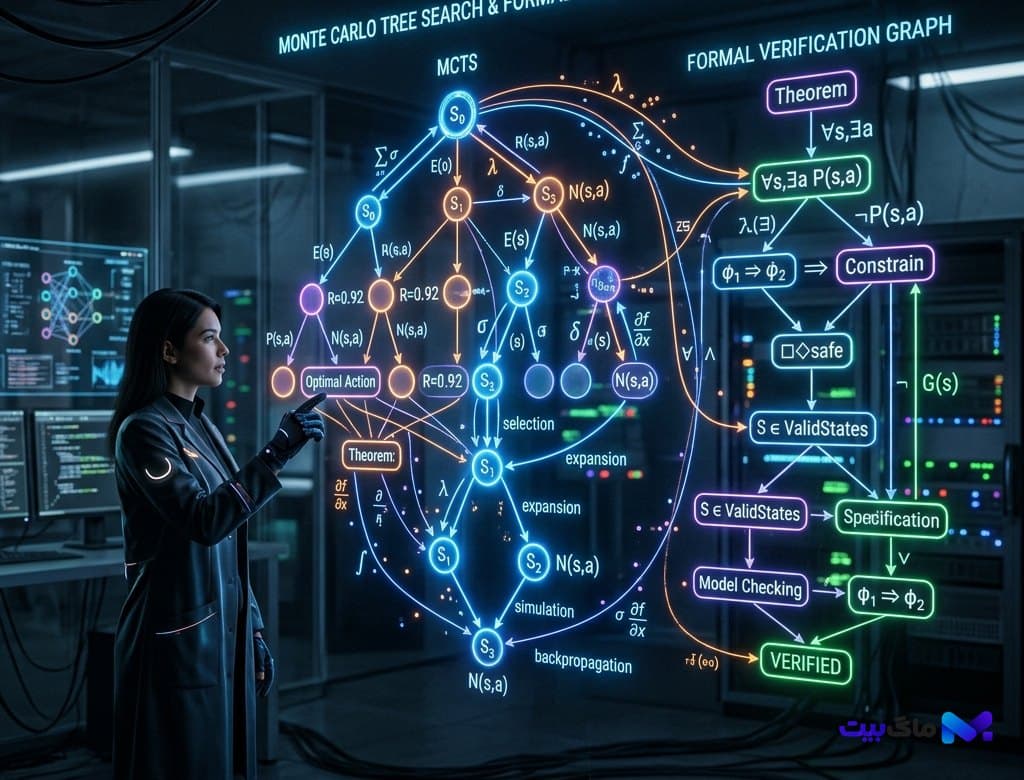
- تحلیل عمیق دگرگونی پارادایم هوش مصنوعی از مقیاسپذیری پیشآموزش به محاسبات زمان آزمون (Test-Time Compute) امروزه واکاوی الگوریتمهای جستجوی درخت مونتکارلو (MCTS)، مدلهای پاداش فرآیند (Process Reward Models)، ادغام موتورهای اثبات صوری Lean 4 و Mathlib، و یادگیری تقویتی با پاداشهای تأییدپذیر (RLVR) برای حل بدون توهم مسائل ریاضی، الگوریتمها و کشف قوانین علمی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران اتکای محض به پیشآموزش؛ تولد قانون مقیاسپذیری استنتاج
در سالهای نخستین تکامل مدلهای زبانی بزرگ، قاعده طلایی این صنعت در یک اصل خلاصه میشد: افزودن بر تعداد پارامترهای شبکه، گسترش حجم دادههای متنی وب و مصرف گیگاواتساعتها انرژی الکتریکی برای فاز پیشآموزش (Pre-training). با این حال، با آغاز دوران معاصر این رویکرد به مرزهای سخت قانون بازده نزولی (Diminishing Returns) و کمبود دادههای باکیفیت انسانی برخورد کرد. مدلها با وجود تسلط خیرهکننده بر تولید نثر ادبی و ترجمه، در حل مسائل مستلزم استدلال زنجیرهای طولانی، مانند اثبات قضایای ریاضیات پیشرفته، سنتز الگوریتمهای پیچیده و طراحی مدارهای منطقی، همچنان دچار توهمهای فاجعهبار میشدند.
تحول بنیادین دوران کنونی کشف و اثبات تجربی «قانون مقیاسپذیری محاسبات زمان آزمون» (Test-Time Compute Scaling) است. در این پارادایم، به جای اتلاف منابع برای ساخت مدلهای یک تریلیون پارامتری سنگین، از یک مدل استدلال پایه چهل تا هفتاد میلیارد پارامتری استفاده میشود؛ اما به مدل اجازه داده میشود هنگام مواجهه با یک پرامپت چالشبرانگیز، به جای تولید ناگهانی اولین توکنهای محتمل، ثانیهها یا حتی دقایق متوالی «فکر کند». در این فرآیند، فلوچارتهای فکری متعدد بسط داده میشوند، مسیرهای به بنبست رسیده هرس (Prune) گشته و گامهای درست به شکل بازگشتی بازبینی میشوند.
همانطور که در واکاوی مدلهای ترنسفورمر انتشار زمان واقعی DiT و شبیهسازی جهان مشاهده کردیم که درک پیوستگی فیزیکی به پردازش متوالی نیازمند است، در دنیای منطق و نمادها نیز استنتاج عمیق نیازمند تخصیص پویای ژولهای انرژی در لحظه پاسخدهی است تا ساختار تصمیمگیری از حدسهای آماری به حل مسأله ساختاریافته ارتقا یابد.
همافزایی عصب و نماد؛ مدلهای پاداش فرآیند (PRM) و هدایت جستجوی MCTS
قلب تپنده موتورهای استدلال دوران کنونی تلفیق ابتکاری شبکههای عصبی عمیق با الگوریتمهای جستجوی درخت مونتکارلو (Monte Carlo Tree Search یا MCTS) است؛ روشی که یادآور پیروزی درخشان آلفاگو در شطرنج و گو است، اما این بار در اقیانوس بیکران زبان طبیعی و منطق صوری به کار گرفته شده است. در سیستمهای سنتی تفکر زنجیرهای (CoT)، مدل صرفاً با پاداش نهایی خروجی (Outcome Reward Model) آموزش میدید؛ بنابراین اگر در گام پنجم یک اثبات ۱۰ مرحلهای خطایی ریز رخ میداد اما نتیجه نهایی برحسب تصادف درست میبود، مدل مسیر فکری اشتباه را تقویت میکرد.
اما در معماریهای نسل کنونی، «مدلهای پاداش فرآیند» (Process Reward Models یا PRM) جایگزین شدهاند. PRM به ازای تکتک جملات یا مراحل محاسباتی تولیدشده توسط مدل، یک امتیاز صحت و اطمینان گرادیانی صادر میکند. الگوریتم MCTS از این امتیازها برای هدایت سیاست جستجو در درخت احتمالات بهره میگیرد. هنگامی که یک شاخه فکری به بنبست منطقی یا امتیاز اعتماد زیر ۷۰ درصد میرسد، الگوریتم بلافاصله فرآیند بازگشت به عقب (Backtracking) را فعال کرده و شاخههای فرضیه دیگر را کاوش مینماید.
این ساختار چندمرحلهای برای سامانههای خودران و عاملی، یک دگرگونی بنیادین به همراه دارد. به عنوان مثال، در پیادهسازی سیستمهای چندعاملی خودران در مهندسی نرمافزار SWE-Bench، استفاده از PRM سبب شده تا عاملهای کدنویس پیش از دستکاری مخزن نرمافزاری، اثرات جانبی هر تغییر را در یک درخت شبیهسازی منطقی تحلیل کنند و از ایجاد باگهای رگرسیونی به طور قطعی پیشگیری نمایند.
اثبات صوری با Lean 4؛ خط بطلان بر توهم با گرهزدن به کامپایلرهای ریاضی
بزرگترین نوآوری فنی دوران معاصر در مهار توهمات، اتصال مستقیم شبکههای عصبی به محیطهای اثبات قضیه صوری (Interactive Theorem Provers)، به ویژه زبان Lean 4 و کتابخانه غنی ریاضیات صوری Mathlib است. در زبان طبیعی همواره امکان مغالطه یا زبانبازی متقاعدکننده وجود دارد؛ اما در Lean 4، یک عبارت ریاضی یا ساختار الگوریتمی تنها زمانی معتبر است که سیستم تایپ پیشرفته و هسته محاسباتی کامپایلر (Calculus of Inductive Constructions)، صحت استنتاج را بپذیرد.
در این خط لوله نوین، مدل زبانی با دریافت یک مسأله هندسی، فیزیکی یا نظریه اعداد، ابتدا صورت مسأله را به زبان صوری Lean ترجمه میکند. سپس با کمک موتور استدلال MCTS، مجموعهای از تاکتیکهای اثباتی (Proof Tactics) را پیشنهاد میدهد. پس از تولید هر تاکتیک، کرنل Lean 4 بلافاصله کالیبره میشود؛ اگر تاکتیک منجر به خطای تایپ شود، بازخورد خطای کامپایلر به عنوان یک سیگنال منفی قطعی به شبکه بازمیگردد. این تکنیک که «یادگیری تقویتی با پاداشهای تأییدپذیر» (Reinforcement Learning with Verifiable Rewards یا RLVR) نامیده میشود، فضای آموزشی را کاملاً از وابستگی به قضاوت سلیقهای داوران انسانی بینیاز میسازد.
نتیجه این جهش امروزه حل بیش از ۸۵ درصد از مسائل المپیاد بینالمللی ریاضی (IMO) و کشف اولین لمهای ناشناخته در نظریه گرافها و توپولوژی جبری توسط سیستمهای هوش مصنوعی بوده است؛ دستاوردی که اثبات میکند هوش مصنوعی وارد دوران درک حقیقی سازوکارهای انتزاعی شده است.
جعبهابزار مهندسان هوش مصنوعی امروزه فریمورکهای مرجع استدلال
برای توسعهدهندگان، پژوهشگران دانشگاهی و استارتاپهایی که مایلند تواناییهای استدلال زمان آزمون و اثبات صوری را در سامانههای خود پیادهسازی کنند، مجموعهای از ابزارهای استاندارد مدرن امروزه عرضه شده است:
۱. فریمورک LeanGym & FormalMath API: بستر ارتباطی ناهمگام و فوقسریع مبتنی بر سوکتهای IPC که مدلهای هوش مصنوعی را به محیط اجرای محلی Lean 4 متصل کرده و بازخورد کامپایل را در کمتر از ۳ میلیثانیه تحویل میدهد.
۲. موتور MCTS-Serve: سرور استنتاج بهینهسازیشده برای کلاسترهای شتابدهنده که الگوریتمهای جستجوی پرتو (Beam Search) و جستجوی درخت مونتکارلو را به صورت دستهای و با موازیسازی شاخهها بر روی پردازندههای گرافیکی اجرا میکند.
۳. بسته نرمافزاری PRM-Aligner Suite: جعبهابزار متنباز برای آموزش و تقطیر مدلهای پاداش گامبهگام با بهرهگیری از تکنیکهای DPO مرحلهای و اعتبارسنجی خودکار بدون ناظر.
استقرار بهینه این ابزارها بر بستر ساختارهای مدرن مهندسی نرمافزار، نظیر موتورهای تحلیلی نهفته با Apache DataFusion و Rust، به تیمها امکان میدهد ترافیک برداری و گرافهای دانش استنتاجی را با حداقل تأخیر حافظه و بالاترین بهرهوری سختافزاری هدایت نمایند.
چشمانداز آینده و چالشهای پردازشی؛ فراتر از منطق دودویی
با وجود درخشش خیرهکننده استدلال زمان آزمون، صنعت هوش مصنوعی با چالشهای عملیاتی نوینی دست به گریبان است. نخستین مسأله، مقیاسپذیری تأخیر زمانی است؛ مسائلی که نیازمند چندین هزار گام جستجوی MCTS هستند ممکن است بین ۳۰ ثانیه تا ۱۰ دقیقه زمان ببرند که این امر برای کاربردهای تعاملی زمان واقعی نامناسب است. تیمهای پژوهشی در حال توسعه متدهایی برای پیشبینی پیچیدگی مسأله پیش از آغاز جستجو هستند تا بودجه پردازشی را متناسب با سختی سوال تخصیص دهند.
چالش دوم، گسترش این رویکرد به حوزههای غیرقابل اثبات صوری مانند علوم اجتماعی، قضاوتهای حقوقی و ادبیات است، جایی که کامپایلری مانند Lean 4 برای اعتبارسنجی قطعی وجود ندارد. با این حال، دانشمندان در تلاشند تا از طریق مدلسازی چندعاملی و تالارهای مناظره هوش مصنوعی، خطاهای حوزههای انسانی را نیز کنترل کنند.
همانگونه که در بررسی هدبندهای رابط مغز و رایانه و نوروفیدبک حلقه-بسته تحلیل خواهد شد، همگرایی میان مدلهای شناختی ماشینی و سامانههای پایش مغز انسان میتواند به زودی همافزایی بینظیری در ارتقای حل مسأله جمعی میان ذهن انسان و هوش مصنوعی بیافریند.
⚠️ سلب مسئولیت پزشکی
اطلاعات و دادههای ارائهشده در این مقاله صرفاً با هدف افزایش آگاهی در زمینه فناوریهای سلامت منتشر شده است و نباید به عنوان توصیه، تشخیص یا پروتکل درمانی پزشکی تلقی گردد. پیش از هرگونه تصمیمگیری یا تغییر در برنامههای سلامت فردی، با پزشک متخصص مشورت نمایید.
بیشتر از هوش مصنوعی



