
پردازش فوقسریع کلانداده با زبان برنامهنویسی Rust و DataFusion
امروزه مهندسی داده با پشت سر گذاشتن خوشههای سنگین و حافظهخوار JVM، به سوی موتورهای بومی Rust و پردازش بدون کپی با Apache DataFusion حرکت کرده است که کوئریهای چند ترابایتی را روی یک سرور واحد با سرعت نور اجرا میکنند.
- تحلیل معماری تحول مهندسی داده امروزه بررسی چگونگی جایگزینی خوشههای پرهزینه Spark و فرآیندهای JVM با موتورهای تحلیلی نهفته (Embedded OLAP) نظیر Apache DataFusion، DuckDB و Polars مبتنی بر حافظه اشتراکی Apache Arrow، پردازش موازی خطوط لوله برداری با دستورالعملهای AVX-512 و ARM Neon، و کاهش ۹۰ درصدی هزینههای سرورهای ابری.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
فرسودگی کلاسترهای سنتی؛ هزینه سرسامآور انتزاع و حافظه در ماشین مجازی جاوا
در بیش از یک دهه گذشته، چشمانداز پردازش کلانداده در تسخیر بلامنازع فریمورکهای مبتنی بر ماشین مجازی جاوا (JVM) نظیر Hadoop و Apache Spark بود. این معماریها اگرچه در عصر هارددیسکهای مکانیکی و شبکههای محلی یک گیگابیت دستاوردی شگرف به شمار میرفتند، اما با ظهور دیسکهای فوقسریع NVMe با پهنای باند ده گیگابایت بر ثانیه و سرورهای چندصد هستهای مدرن، خود به گلوگاه اصلی کارایی تبدیل شدند.
مشکلات بنیادین کلاسترهای جاوا در سه پدیده خلاصه میشود: نخست، سربار چشمگیر حافظه به دلیل ساختار شیءگرای JVM و پدیده توقف دنیا (Stop-the-World) در جمعآوری زباله (Garbage Collection) که کلاسترهای ترابایتی را در میانه کوئریهای سنگین ناگهان فریز میکرد. دوم، هزینههای انتقال و سریالسازی داده میان گرهها، و سوم، ناتوانی در بهرهبرداری کامل از دستورالعملهای برداری مدرن پردازندهها. این در حالی است که با گسترش معماری مؤلفهای وباسمبلی و استقرار سرورلس لبه با WASI 0.3، جامعه مهندسی نرمافزار به شدت به سوی کدهای فشرده و باینریهای مستقل تمایل پیدا کرده است.
امروزه شرکتهای فناوری به این نتیجه رسیدهاند که بیش از ۹۵ درصد از وظایف تحلیلی آنها که قبلاً روی کلاسترهای گرانقیمت ۵۰ گرهی اسپارک اجرا میشد، امروزه روی یک سرور منفرد مدرن ۶۴ هستهای با حافظه رم بالا و موتورهای زبان Rust بسیار سریعتر و با یکدهم هزینه به سرانجام میرسد.
معماری رادیکال Apache DataFusion؛ پردازش ستونی بدون کپی (Zero-Copy)
در مرکز این انقلاب زیرساختی امروزه پروژه قدرتمند Apache DataFusion قرار دارد؛ یک موتور کوئری فوقسریع و ماژولار که از پایه به زبان Rust بازنویسی شده است. هسته اصلی معماری دیتافیوژن بر استاندارد حافظه ستونی Apache Arrow بنا شده است. برخلاف سیستمهای سنتی که برای پردازش ردیفها نیازمند کپی کردن مکرر بایتها از دیسک به بافر و سپس به اشیاء کلاسی بودند، استاندارد Arrow یک آرایش حافظه یکپارچه در سطح باینری تعریف میکند.
این قالب ستونی به موتور DataFusion اجازه میدهد عملیات فیلتر، گروهبندی (Aggregation) و ادغام جداول (Join) را با منطق «پردازش بدون کپی» (Zero-Copy) اجرا کند. دادههای خواندهشده از فایلهای فشرده Parquet مستقیماً در بافرهای حافظه نگاشت میشوند و خط لوله پردازشی بدون کوچکترین سربار سریالسازی یا بار اضافی سربار کپی، روی دادهها جریان مییابد.
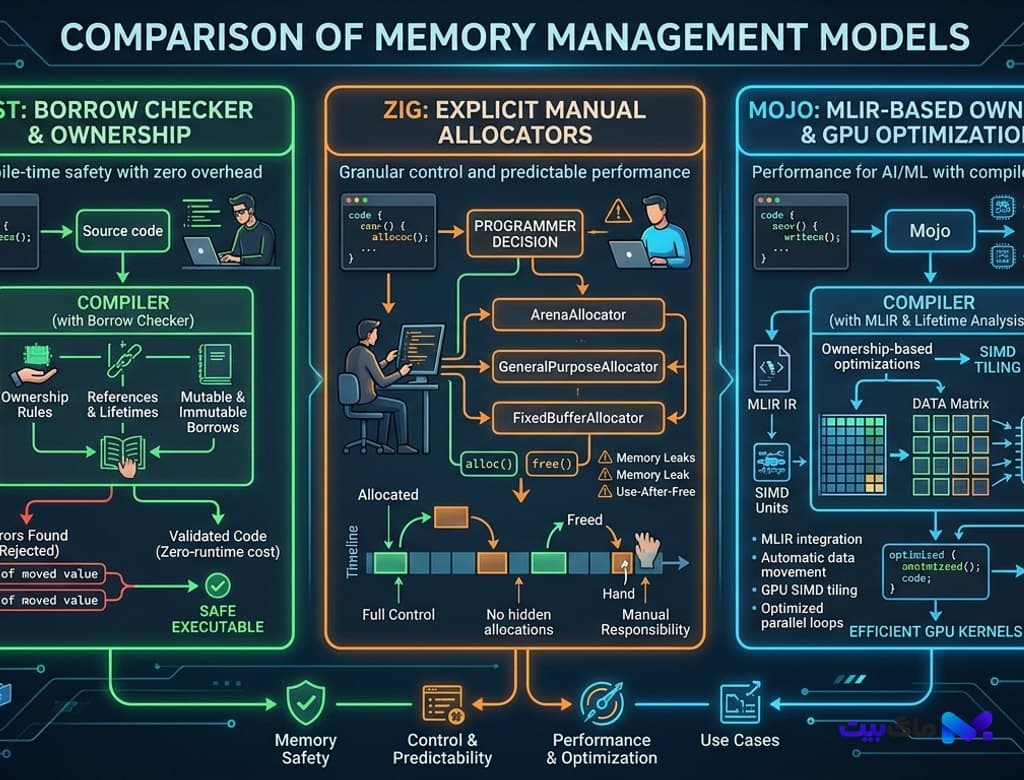
علاوه بر این، زبان Rust به دلیل تضمین ایمنی حافظه در زمان کامپایل (Borrow Checker) و حذف کامل لایه Garbage Collection، رفتاری کاملاً قابل پیشبینی با کمترین نوسان در تأخیر کوئریها (P99 Latency) به نمایش میگذارد؛ خصیصهای حیاتی که مستقیماً در دیتابیسهای برداری چندوجهی شتابیافته با GPU برای اجرای بلادرنگ جستجوهای معنایی میلیارد توکنی مورد بهرهبرداری قرار گرفته است.
شتابدهی سختافزاری برداری؛ رام کردن هستههای پردازنده با SIMD و AVX-512
توان واقعی DataFusion هنگامی آشکار میشود که با دستورالعملهای برداری مدرن پردازنده نظیر AVX-512 در اینتل و AMD یا واحدهای NEON و SVE در پردازندههای مبتنی بر ARM همگام میگردد. در پردازش سنتی اسکالر، برای جمع زدن یک ستون شامل یک میلیارد عدد، پردازنده باید یک میلیارد بار چرخه واکشی و دستورالعمل جمع را تکرار میکرد.
اما موتورهای برداری مدرن دوران کنونی از قابلیت SIMD (Single Instruction, Multiple Data) بهره میبرند؛ بدین معنی که یک ثبات ۵۱۲ بیتی در هر چرخه ساعت پردازنده میتواند به طور همزمان ۱۶ عدد اعشاری ۳۲ بیتی را پردازش کند. کامپایلر Rust با تولید کدهای باینری بهینهسازیشده برای هر معماری سختافزاری، خط لوله اجرای کوئری را به گونهای سازماندهی میکند که تمامی حلقههای محاسباتی به صورت خودکار به شکل برداری (Auto-Vectorization) کامپایل شوند.
همچنین، ادغام این معماری با متدهای پیشرفته مانیتورینگ کرنل نظیر سامانههای نظارتپذیری کرنل ابری با eBPF بدون سربار، به مدیران زیرساخت اجازه میدهد رفتار کشهای L1/L2/L3 پردازنده و مراجعات به حافظه NUMA را در سطح میکروثانیه رصد کرده و گلوگاههای گلوگاهی را رفع نمایند.
اکوسیستم ابزارهای توسعه داده امروزه تثبیت امپراتوری Rust
امروزه جعبهابزار مهندسان داده برای ساخت زیرساختهای تحلیلی نوین حول محور سه بازیگر کلیدی بازطراحی شده است:
۱. فریمورک Apache DataFusion Core & Ballista: کتابخانه نهفته Rust برای سفارشیسازی موتورهای SQL و Ballista برای توزیع کوئریها روی چندین گره بدون افت بازدهی.
۲. موتور تحلیلی DuckDB: دیتابیس تحلیلی تکفایلی که به SQLite دنیای OLAP شهرت یافته و امروزه با ادغام در خطوط لوله وب و پایتون، تحلیل دادههای چند گیگابایتی را مستقیماً در حافظه رم مرورگر یا سرورهای لبه محقق میسازد.
۳. کتابخانه Polars 2.0: جایگزین بومی Rust برای کتابخانه کند پانداس در پایتون، که با موتور اجرایی Lazy Execution و بهینهسازی نقشه کوئری، اسکریپتهای تحلیلی را تا صد برابر سریعتر از رقبا اجرا مینماید.
جالب اینجاست که همگرایی این موتورهای تحلیلی با مقیاسپذیری محاسبات زمان آزمون و استدلال عصب-نمادین، پایهای قدرتمند برای نگهداری گرافهای فکری و ماتریسهای پاداش در سامانههای هوش مصنوعی خلق کرده است.
پیامدهای اقتصادی، ردپای کربن و چشمانداز آینده مهندسی داده
گذار از کلاسترهای کلاود سنگین به موتورهای نهفته Rust تنها یک دستاورد فنی نیست؛ بلکه صرفهجویی اقتصادی عظیمی به بار آورده است. گزارشهای مالی شرکتهای پیشرو امروزه حاکی از کاهش ۶۵ تا ۹۰ درصدی صورتحسابهای ابری AWS و GCP پس از مهاجرت از کلاسترهای سنگین EMR/Databricks به معماریهای DataFusion-Native است.
این کاهش شدید در مصرف پردازنده و حافظه، نقشی اساسی در کاهش مصرف برق مراکز داده و ردپای کربن شرکتها ایفا میکند. در دورانی که مصرف انرژی مراکز داده به دلیل گسترش مدلهای یادگیری عمیق به بحرانی جهانی بدل شده، بهینهسازی بومی زیرساختهای پایگاهداده ضرورتی انکارناپذیر است.
در افق ۲۰۲۷، انتظار میرود DataFusion با پشتیبانی عمیقتر از شتابدهندههای سختافزاری اختصاصی (FPGA و TPU) و یکپارچگی عمیقتر با زبانهای سیستمی مدرن، مفهوم «کلانداده» را از کلاسترهای غولپیکر به پردازشهای آنی روی سرورهای متراکم بازتعریف کند.
بیشتر از فناوری



