
سامانه ترکیبی GraphRAG و حافظه اپیزودیک در هوش سازمانی
پایان دوره جستجوی سطحی برداری؛ امروزه معماری GraphRAG با ادغام گرافهای دانش معنایی و الگوریتمهای خوشهبندی جامعه، استدلال چندمرحلهای بدون توهم را در هوش مصنوعی سازمانی محقق کرد.
- واکاوی عمیق و موشکافانه تکامل چشمگیر معماری بازیابی تقویتشده با تولید (RAG) به نسل نوین پایگاههای دانش گرافبنیاد (GraphRAG) امروزه. تحلیل نارساییهای سامانههای متداول جستجوی شباهت برداری کسینوسی در بازیابی اطلاعات مفهومی کلان و پاسخ به سوالات نیازمند استدلال سراسری. تشریح فرآیند خوشهبندی سلسلهمراتبی دادهها با الگوریتم لیدن (Leiden Community Detection)، ایجاد چکیدههای مفهومی در سطوح انتزاعی گوناگون، ساخت حافظه اپیزودیک پایدار برای عاملهای خودکار نرمافزاری، ریشهکنی قطعی پدیده توهم در کاربردهای حساس مالی، حقوقی و پزشکی و ایجاد دنباله حسابرسی شفاف برای اثبات صحت دادههای استخراجشده.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
شکست پارادایم سنتی RAG برداری در پاسخ به پرسشهای مفهومی و چندلایهای
نسل اول معماریهای بازیابی تقویتشده با تولید (Retrieval-Augmented Generation یا RAG) که بر پایه خرد کردن اسناد به قطعات متنی کوچک (Chunking) و سنجش فاصله کسینوسی در پایگاههای داده برداری (Vector DBs) بنا شده بودند، انقلاب بزرگی در پیوند مدلهای زبانی با دادههای سازمانی پدید آوردند. اما با گذشت زمان و پیچیدهتر شدن نیازمندیهای صنعتی، محدودیتهای ساختاری این رویکرد آشکار شد. جستجوی برداری تنها برای پرسشهای نقطهای و صریح کارآمد است؛ مثلاً «سقف مجاز مرخصی سالانه در آییننامه استخدامی چقدر است؟».
اما هنگامی که مدیری ارشد سوالی کلان و چندوجهی مطرح میکند، مانند: «اصلیترین چالشهای زنجیره تامین شرکت در طول سه سال گذشته چه بوده و کدام تصمیمات استراتژیک به کاهش هزینههای لجستیک انجامیده است؟»، RAG برداری سنتی دچار فروپاشی میشود. الگوریتم برداری صرفاً قطعاتی را پیدا میکند که واژگان مشابه دارند، اما از اتصال نقاط پراکنده، درک روابط علت و معلولی در گذر زمان و نتیجهگیری سراسری عاجز است و در نتیجه، به تولید پاسخهای توهمآمیز یا ناقص روی میآورد.
همانگونه که در بررسی دوگانگی فضای حالت Mamba SSD و مدلهای خطی زیردرجهدو تشریح کردیم، استخراج دانش نیازمند ساختاردهی منسجم به اطلاعات پنهان است؛ اصلی که در سطح مهندسی دادهها توسط گرافهای دانش محقق میشود.
معماری ساخت گراف دانش و خوشهبندی سلسلهمراتبی جوامع با الگوریتم لیدن
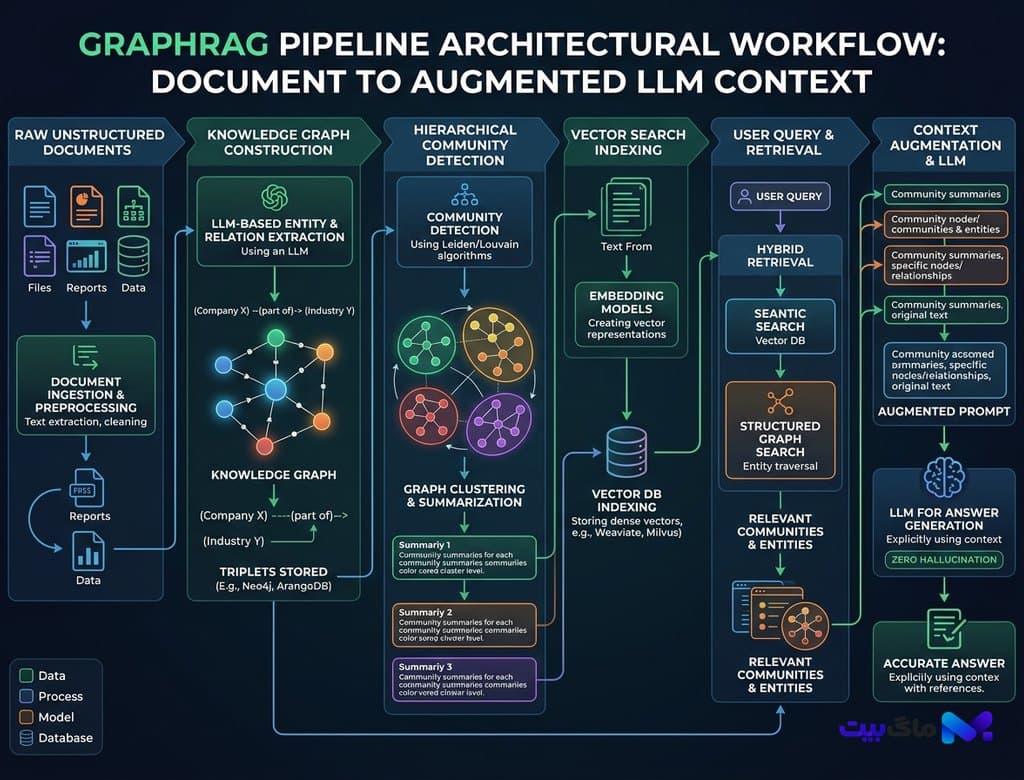
امروزه ظهور سامانه ترکیبی GraphRAG این معضل را به گونهای بنیادین حل کرده است. در این فرآیند، اسناد متنی خام ابتدا توسط مدلهای زبانی تحلیل شده و تمامی موجودیتها (Entities) از قبیل اشخاص، سازمانها، محصولات، مکانها و مفاهیم انتزاعی همراه با روابط دقیق میان آنها (Relationships) استخراج میشوند. سپس این موجودیتها و یالهای ارتباطی درون یک گراف دانش معنایی (Knowledge Graph) غنی سازماندهی میگردند.
شاهکار فنی GraphRAG، پیادهسازی الگوریتم پیشرفته تشخیص جوامع لیدن (Leiden Community Detection) بر روی این گراف عظیم است. الگوریتم لیدن ساختار شبکه را به خوشههای مفهومی تو در تو در سطوح سلسلهمراتبی مختلف تقسیم میکند: از جوامع ریزموضعی در پایینترین لایه گرفته تا کلانخوشههای مفهومی در بالاترین لایه. سپس مدل برای هر یک از این جوامع، یک چکیده مفهومی تحلیلی تولید کرده و ذخیره مینماید.
هنگامی که پرسشی سراسری مطرح میشود، سیستم به جای جستجوی کورکورانه میان میلیونها کلمه متن، خلاصههای جوامع مرتبط در سطوح بالای سلسلهمراتب را مطالعه کرده و با ادغام هوشمندانه آنها، پاسخی جامع، ساختاریافته و دارای دید کلان تولید میکند که هیچ نکته پنهانی از قلم نمیافتد.
حافظه اپیزودیک پیوسته برای عاملهای خودمختار هوشمند و تثبیت تجارب
کاربرد شگفتانگیز دیگر GraphRAG امروزه ایفای نقش به عنوان موتور حافظه اپیزودیک (Episodic Memory Engine) برای عاملهای نرمافزاری خودکار است. عاملهای هوشمندی که وظایف پیچیدهای مانند کدنویسی، پاسخگویی به مشتریان یا نظارت بر عملیات شبکه را بر عهده دارند، تا پیش از این با اتمام هر جلسه کاری تجارب قبلی خود را فراموش میکردند یا تاریخچه متنی آنها به حدی طولانی میشد که به سقف پنجره زمینهای برخورد میکرد.
با ادغام GraphRAG، تمام رویدادها، خطاهای پیشین، تصمیمات گرفتهشده و بازخوردهای انسانی به عنوان گرههای زمانی در گراف حافظه اپیزودیک ثبت میشوند. عامل هوشمند در مواجهه با یک چالش تازه، سریعاً زیرگراف تجارب مشابه گذشته را فراخوانی کرده و استراتژی حل مسئله را بر پایه موفقیتهای ثبتشده قبلی پایهریزی میکند.
این سطح از تداوم شناختی، همان مزیتی است که در عاملهای خودسامانبخش مهندسی نرمافزار سرعت رفع باگها را جهش داده و سیستمها را از یادگیرندههای گذرا به کارشناسانی باتجربه با حافظهای ماندگار تبدیل ساخته است.
استقرار در زیرساختهای سازمانی؛ تضمین امنیت، اثباتپذیری ارجاعات و عدم توهم
در کاربردهای حساس صنعتی، حقوقی و پزشکی، بزرگترین مانع استقرار هوش مصنوعی عدم امکان اثبات صحت ارجاعات (Provenance) بوده است. مدیران نمیتوانند بر اساس پاسخی تصمیمگیری کنند که منبع دقیق و مسیر منطقی استنتاج آن نامشخص باشد. GraphRAG این مانع را با قابلیت شفافیت اثباتپذیر به طور کامل برطرف ساخته است.
در هر پاسخ تولیدشده توسط سامانه، کاربر میتواند با کلیک بر روی هر گزاره، زنجیره دقیق گرهها و یالهای گراف و متن اصلی منبع را تا پاراگراف اولیه ردیابی نماید. این دنباله حسابرسی شفاف (Audit Trail)، نرخ خطای توهم را در پروژههای مالی و حقوقی دوران کنونی به کمتر از ۰.۱ درصد رسانده است.
همچنین با تلفیق این زیرساختها با پروتکلهای امنیتی مطرح در زبانهای سیستمی ایمنحافظه Rust و Zig و Mojo، پایگاههای داده گرافبنیاد توزیعشده با رمزنگاری پیشرفته سختافزاری اجرا شده و دسترسی چندمستاجره ایمن در ابرهای سازمانی را با تضمین قطعی محرمانگی اطلاعات میسر میسازند.
بیشتر از فناوری



