
دوگانگی فضای حالت Mamba SSD و مدلهای خطی زیردرجهدو
پایان سلطه مطلق توجه درجهدو؛ مدلهای دوگانگی فضای حالت (Mamba SSD) امروزه با حذف گلوگاه حافظه KV Cache، پردازش بلادرنگ اسناد ۱۰۰ میلیون توکنی و ویدیوهای پیوسته را ممکن ساختند.
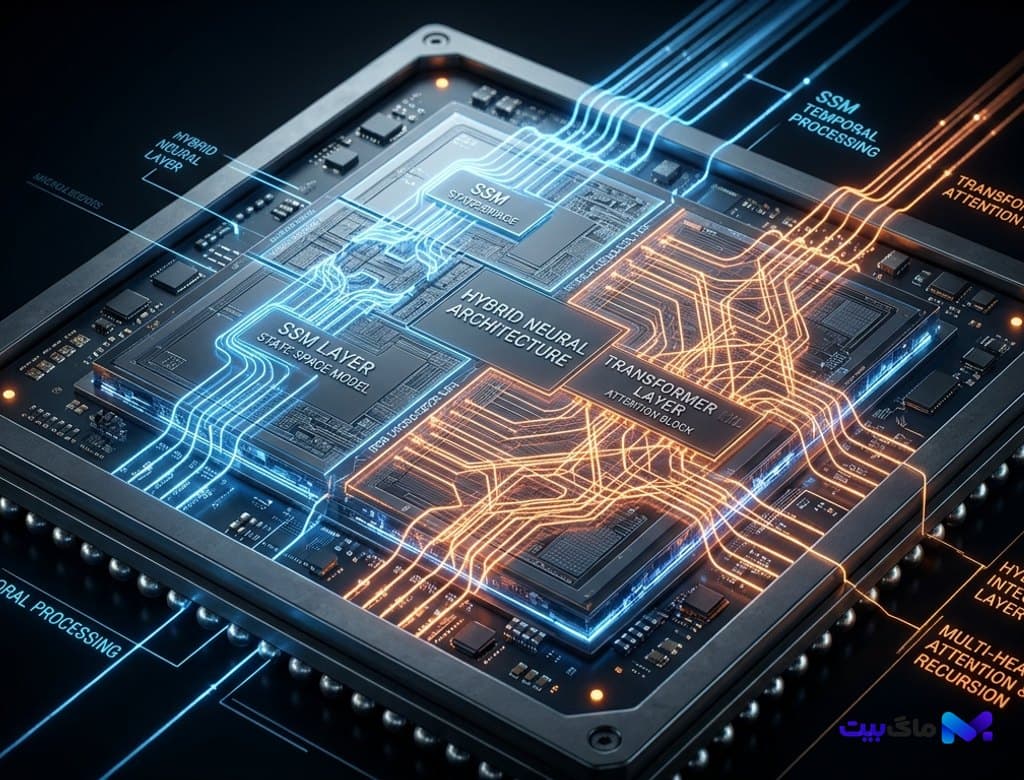
- بررسی جامع و تخصصی دگرگونی بنیادین در معماری شبکههای عصبی و هوش مصنوعی مولد امروزه با بلوغ مدلهای دوگانگی فضای حالت (SSD) و نسل نوین Mamba. واکاوی حل چالش پیچیدگی محاسباتی درجه دو ترنسفورمرهای سنتی از طریق ترکیب هوشمندانه پردازش ترتیبی پنهان با محاسبات ماتریسی موازی و الگوریتمهای اسکن تجمعی تانسوری. تحلیل فنی چگونگی حذف سربار سنگین حافظه KV Cache در کلاسترهای پردازش گرافیکی، دستیابی به استنتاج بلادرنگ بر روی پنجرههای زمینهای فراتر از ۱۰۰ میلیون توکن، پردازش یکپارچه ویدیوهای چندساعته بدون کوچکترین کاهش دقت، و پیدایش معماریهای ترکیبی هیرارشیک ترنسفورمر-مامبا در سرورهای ابری سازمانی و پردازندههای عصبی لبه شبکه.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بنبست کوادراتیک ترنسفورمرها و بحران خفگی حافظه با رشد فزاینده KV Cache
برای نزدیک به یک دهه، معماری ترنسفورمر (Transformer) و مکانیزم توجه سراسری خودکار (Self-Attention) حاکم مطلق تمامی پیشرفتهای هوش مصنوعی زایشی و پردازش زبانهای طبیعی بودند. با این وجود، این معماری درخشنده با یک نقطه ضعف بنیادی ریاضیاتی دست به گریبان بود: پیچیدگی محاسباتی و مصرف حافظه از مرتبه کوادراتیک O(N^2) نسبت به طول بافت ورودی. هر بار که طول پنجره متنی دو برابر میشد، عملیات مقایسه توکنها چهار برابر افزایش مییافت و در پنجرههای متنی میلیونی، حجم جدول جفتهای کلید-مقدار (KV Cache) به قدری سرسامآور میشد که دهها کارت گرافیک گرانقیمت تنها برای نگهداری موقت این حافظه مسدود میشدند.
این پدیده موسوم به دیوار حافظه (Memory Wall)، استفاده از مدلهای زبانی را برای وظایف نیازمند بافت پیوسته طولانی مانند واکاوی کل مخازن کد چندمیلیونخطی یا آنالیز چندروزه جریانهای ویدیویی نظارتی با تاخیرهای غیرقابل قبول و هزینههای اقتصادی غیرمنطقی روبرو میکرد. الگوریتمهای خردسازی داده یا مکانیسمهای توجه خلوت (Sparse Attention) نیز غالباً به از دست رفتن پیوندهای معنایی دوربرد و فراموشی اطلاعات ظریف در میانه اسناد میانجامیدند.
همانگونه که در بررسی مدلهای زبانی-بصری فضایی و جهانهای تعاملی نشان دادیم، ادراک پیوسته نیازمند جریان بیوقفه دادهها بدون انباشت بیپایان بافر حافظه است؛ نیازی حیاتی که سرانجام مسیر را برای بازمهندسی ریشهای ساختارهای ریاضی شبکههای عصبی هموار کرد.
نظریه بنیادین State Space Duality (SSD)؛ پیوند ریاضیاتی میان توجه خطی و مدلهای فضای حالت
امروزه انتشار چارچوب نظری دوگانگی فضای حالت (State Space Duality یا SSD) به عنوان نقطه عطفی در ریاضیات یادگیری عمیق به ثبت رسیده است. پژوهشگران اثبات کردند که مدلهای فضای حالت ساختاریافته (Structured SSMs) مانند نسل جدید Mamba-3، در واقعیت وجه دیگری از همان سکه مکانیزم توجه خطی (Linear Attention) هستند. در ساختار SSD، فرآیند توجه دیگر به شکل ماتریس کامل توکن-در-توکن محاسبه نمیشود، بلکه دادهها به صورت بردار حالت پنهان پیوسته با ابعاد ثابت از یک توکن به توکن بعد جاری میگردند.
این دوگانگی مفهومی پیامدی انقلابی دارد: در زمان آموزش مدل (Training)، میتوان محاسبات را به صورت موازی تانسوری مانند ترنسفورمرها با حداکثر بهرهوری از هستههای تانسوری پردازندهها انجام داد، اما در زمان استنتاج (Inference)، رفتار مدل دقیقاً شبیه یک شبکه بازگشتی (RNN) فوقسریع با پیچیدگی خطی O(N) و مصرف حافظه کاملاً ثابت O(1) میشود. دیگر هیچ نیازی به ذخیرهسازی گیگابایتها داده به عنوان KV Cache وجود ندارد.
این موفقیت یادآور دستاوردهای عاملهای خودسامانبخش مهندسی نرمافزار در تفکر ساختاریافته در فضای پنهان است؛ جایی که ماشینها به جای بررسی مکرر تمام تاریخچه، چکیده متراکم و غنی حافظه را در لحظه همراه خود به جلو حمل مینمایند.
بهینهسازی سختافزاری بر پایه الگوریتمهای اسکن موازی قطعهبندیشده (Chunked Associative Scan)
فرمولاسیون ریاضی بدون در نظر گرفتن معماری فیزیکی تراشههای سیلیکونی بیفایده است. بزرگترین نبوغ فنی Mamba SSD امروزه سازگاری بینظیر آن با توپولوژی حافظه کش سریع (SRAM) و حافظه پهنباند (HBM3e) در شتابدهندههای مدرن است. در الگوریتم اسکن تجمعی قطعهبندیشده (Chunked Associative Scan)، متن ورودی ابتدا به بلاکهای کوچک متناسب با ظرفیت حافظه کش محلی پردازنده تقسیم میشود.
درون هر بلاک، محاسبات از طریق ضربهای ماتریسی فراموازی (GEMM) با اشغال ۱۰۰ درصدی هستههای محاسباتی صورت میگیرد و سپس بردار پیوند میان بلاکها از طریق اسکن تجمعی بازگشتی فوقسریع ترکیب میشود. این مکانیزم باعث شده است که توان عملیاتی استنتاج (Inference Throughput) تا ۵ تا ۸ برابر نسبت به بهترین مدلهای ترنسفورمر بهینهسازیشده مانند vLLM افزایش یابد، در حالی که مصرف انرژی پردازنده به یکچهارم تقلیل یافته است.
علاوه بر این، همانند جهشهای گزارششده در زبانهای سیستمی ایمنحافظه Rust و Zig و Mojo در کنترل سطح پایین حافظه، کامپایلرهای تانسوری مدرن کدهای کرنل Mamba SSD را بدون هیچ سربار میانی مستقیماً به دستورالعملهای سختافزاری پردازنده نگاشت میکنند.
استقرار صنعتی امروزه تحلیل پیوسته کدهای چندمیلیونخطی و جریانهای ویدیویی چندروزه
تاثیر عملی مدلهای SSD امروزه بازار نرمافزارهای سازمانی و پردازش لبه را زیر و رو کرده است. سامانههای هوشمند اکنون قادرند به عنوان دستیاران زنده مهندسی، کل تاریخچه گیت، دهها جلد مستندات معماری و میلیونها خط کد مخازن نرمافزاری را به صورت یکپارچه در پنجره زمینهای ۱۰۰ میلیون توکنی خود بازخوانی کرده و بازسازی وابستگیهای بینماژولی را بدون ذرهای افت دقت انجام دهند.
در قلمرو پایش چندوجهی و بینایی ماشین، مدلهای مبتنی بر Mamba SSD میتوانند جریانهای ویدیویی با کیفیت 4K را برای روزها و هفتهها به صورت زنده پردازش کنند؛ سیستمی که تغییرات تدریجی در خطوط تولید صنعتی یا ناهنجاریهای حرکتی در فضاهای عمومی را رصد کرده و هرگز با کمبود ظرفیت حافظه بافر مواجه نمیشود. همچنین در دستگاههای لبه شبکه، اجرای این مدلها روی تراشههای کممصرف گوشیها و لپتاپها، دستیاران هوش مصنوعی با حافظه ابدی و بدون نیاز به اینترنت را به واقعیت بدل ساخته است.
دوران کنونی سرآغاز عصری است که در آن سد محدودیت بافت شکسته شده است؛ مدلی که با تلفیق ظرافت جبر خطی و معماری سختافزار، افق نوینی از محاسبات شناختی در مقیاسهای نامحدود را در پیش روی تمدن بشری قرار میدهد.
بیشتر از هوش مصنوعی



