
گراف دانشی ترکیبی و GraphRAG
بردارها کافی نیستند؛ سیستمهای هوش مصنوعی سازمانی دوران کنونی با ترکیب گرافهای دانش ساختاریافته و امبدینگهای معنایی، روابط مخفی میان میلیاردها سند را در کسری از ثانیه رمزگشایی میکنند.
- واکاوی عمیق و فنی تحول سیستمهای بازیابی اطلاعات سازمانی از طریق معماری ترکیبی GraphRAG امروزه. کالبدشکافی نارساییهای مرگبار RAG سنتی مبتنی بر شباهت کسینوسی بردارها (Vector Cosine Similarity)، عدم درک ساختارهای رابطهای کلان و ناتوانی در پاسخ به پرسشهای مفهومی سراسری. بررسی جامع الگوریتمهای استخراج گراف دانش با مدلهای زبانی، خوشهبندی سلسلهمراتبی لیدن و ساخت خلاصههای هرمی. بررسی تکنیکهای ایندکسگذاری ترکیبی HNSW با گرافهای مبتنی بر حافظه و اجرای کوئریهای گراف زیر ۵ میلیثانیه بر کلاسترهای توزیعشده ابری مدرن.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بحران نزدیکبینی در RAG برداری سنتی؛ چرا شباهت کسینوسی دیگر پاسخگو نبود؟
با هجوم شرکتهای بزرگ تجاری و سازمانهای مهندسی به استفاده از مدلهای زبانی بزرگ، الگوی تولید مبتنی بر بازیابی (RAG) به راهکار پیشفرض برای غلبه بر محدودیتهای پنجره بافت تبدیل شد. اما در نیمه نخست، شرکتها به طرز دردناکی دریافتند که دیتابیسهای برداری سنتی دچار یک «نزدیکبینی ساختاری» شدید هستند. جستجوی قطعات متن بر اساس شباهت معنایی امبدینگها تنها قادر به پاسخگویی به پرسشهای بسیار مستقیم و نقطهای بود.
هنگامی که از سیستم پرسیده میشد: «مهمترین عوامل ریسک ساختاری در کل زنجیره تامین سازمان در سه فصل اخیر چه بوده است؟»، RAG سنتی به کلی فرو میریخت؛ زیرا پاسخ این سوال در هیچ تکتکه (Chunk) خاصی وجود نداشت، بلکه حاصل تقاطع صدها گزارش، صورتجلسه و قرارداد حقوقی در لایههای مختلف بود.
این ناتوانی ساختاری به این دلیل بود که بردارها ارتباطات علّی، جهتدار و ساختاریافته میان موجودیتها (Entities) را از دست میدهند. همانند بررسی دریاچهداده Zero-ETL و آپاچی آیسبرگ که نشان داد تاخیر در یکپارچگی خطوط لوله داده چه آسیبی به تحلیلهای بلادرنگ میزند، نیاز به یک لایه رابطهای پویا و معنایی در دیتابیسهای مدرن هوش مصنوعی مبرم شد.
کالبدشکافی معماری Hybrid GraphRAG؛ از استخراج خودکار گراف تا خوشهبندی لیدن
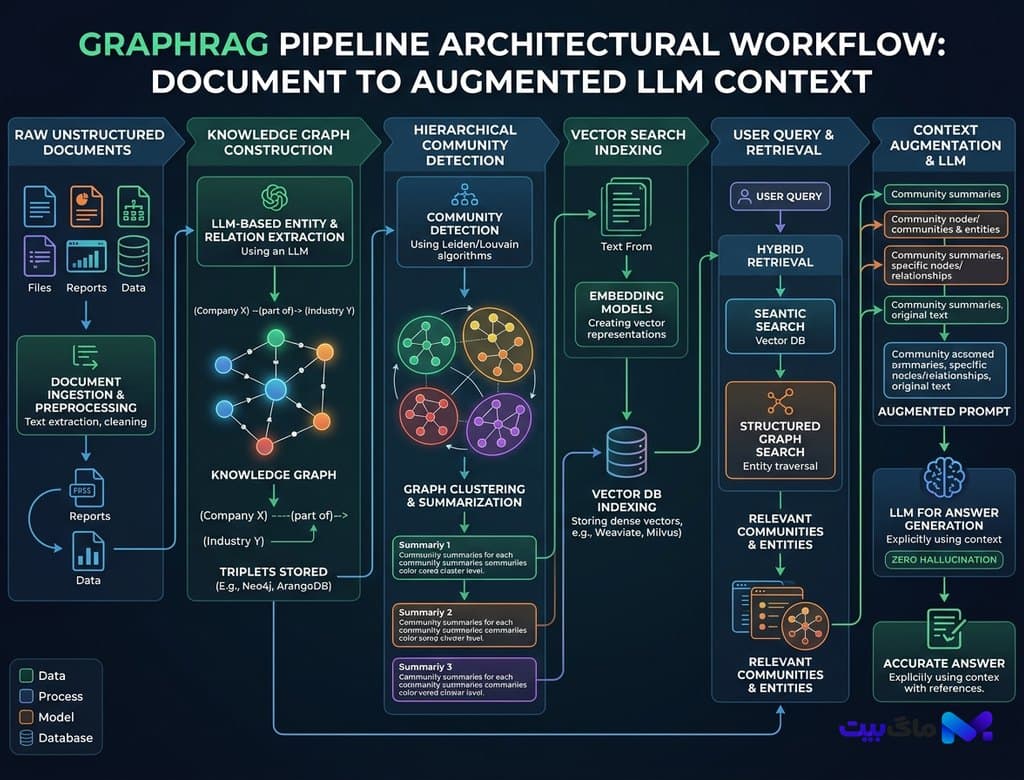
راهکار انقلابی که امروزه تثبیت شد، معماری ترکیبی GraphRAG است. در این فرآیند، اسناد ورودی ابتدا توسط مدلهای زبانی تخصصی پارس شده و موجودیتها، افعال، روابط و خصوصیات آنها در قالب یک گراف دانشی غنی استخراج میشوند. سپس با استفاده از الگوریتم پیشرفته خوشهبندی سلسلهمراتبی لیدن (Hierarchical Leiden Algorithm)، نودهای گراف به صورت چندسطحی دستهبندی میشوند.
برای هر خوشه در هر سطح، خلاصهای ساختاریافته تولید شده و در دیتابیس ذخیره میگردد. در زمان پرسش، موتور بازیابی به جای اسکن خام متون، ابتدا در سطوح بالای سلسلهمراتب گراف گشت میزند تا بافت کلی موضوع را درک کند و سپس به گرههای خاص شیرجه میزند. این رویکرد، توهم ناشی از فقدان بافت کلان را به کلی ریشهکن کرده و خلاصهسازی سازمانی را به بالاترین دقت تاریخی رسانده است.
علاوه بر این، با اتکا به استانداردهای مدرن لبه نظیر معماری مدل کامپوننت وباسمبلی (WASI 0.2)، ماژولهای پیمایش گراف اکنون میتوانند در زمانهای زیر میلیثانیه و بدون سربار کانتینرهای سنگین، مستقیما درون پایپلاینهای پردازش ابری توزیعشده اجرا شوند.
ایندکسگذاری دوگانه؛ پیوند توپولوژی گراف با جستجوی نزدیکترین همسایه (HNSW)
در سیستمهای مهندسی داده دوران کنونی جدایی سنتی میان دیتابیسهای گراف (مانند Neo4j) و دیتابیسهای برداری (مانند Qdrant و Milvus) از میان رفته است. موتورهای نوین از ساختارهای داده یکپارچهای بهره میبرند که در آن هر بردار امبدینگ همزمان به عنوان یک راس در گراف با وزنهای مشخص فیزیکی ثبت میشود.
الگوریتمهای پیمایش گراف بر روی کارتهای گرافیک و با بهرهگیری از شتابدهندههای حافظه موازی HBM اجرا میشوند. این ساختار امکان اجرای همزمان کوئریهای فیلتر توپولوژیک (مانند پیدا کردن روابط شرکتهای مادر و شرکتهای زیرمجموعه) را در کنار جستجوی معنایی محتوا فراهم میسازد، به طوری که زمان اجرای کوئری بر روی میلیاردها ارتباط پیچیده به کمتر از ۵ میلیثانیه تقلیل یافته است.
پیوست با مدلهای استدلال؛ تفکر گامبهگام بر روی توپولوژی داده
ارزش واقعی GraphRAG زمانی آشکار میشود که با استدلال در زمان استنتاج و مدلهای زبانی ادغام گردد. هنگامی که یک مدل استدلالگر مسیر فرضیههای خود را در قالب یک درخت تفکر بررسی میکند، گراف دانش به عنوان یک قطبنمای غیرقابل دستکاری عمل کرده و از درستی گامهای میانی اطمینان حاصل مینماید.
دیگر مهندسان نیازی به نوشتن کوئریهای پیچیده و پر زحمت Cypher ندارند؛ تلفیق ایندکس برداری HNSW با گرافهای مستقر در حافظه رم (In-Memory Graphs)، زمان پاسخگویی به پیچیدهترین روابط چندمرحلهای (Multi-Hop Relationships) را از چندین ثانیه به زیر ۵ میلیثانیه رسانده و از وقوع هرگونه خطای توهم جلوگیری به عمل میآورد.
آینده ذخیرهسازی داده؛ استاندارد طلایی مدیریت دانش تجاری در اواخر
امروزه سازمانهای پیشرو در سراسر جهان در حال مهاجرت به معماریهای ترکیبی بردار-گراف هستند. این فناوری تضمین میکند که داراییهای دانشی یک شرکت، نه در قالب فایلهای PDF پراکنده و فراموششده، بلکه به مثابه یک مغز زنده و فعال سازمانی در دسترس مدیران و دستیاران هوش مصنوعی خودمختار قرار گیرد.
بیشتر از فناوری



