
استدلال در زمان استنتاج
پایان دوران پاسخهای شهودی شتابزده؛ هوش مصنوعی دوران کنونی با صرف زمان برای تفکر پویا و جستجو در فضای فرضیهها، توانایی حل پیچیدهترین معماهای علمی و مهندسی بشر را به دست آورده است.
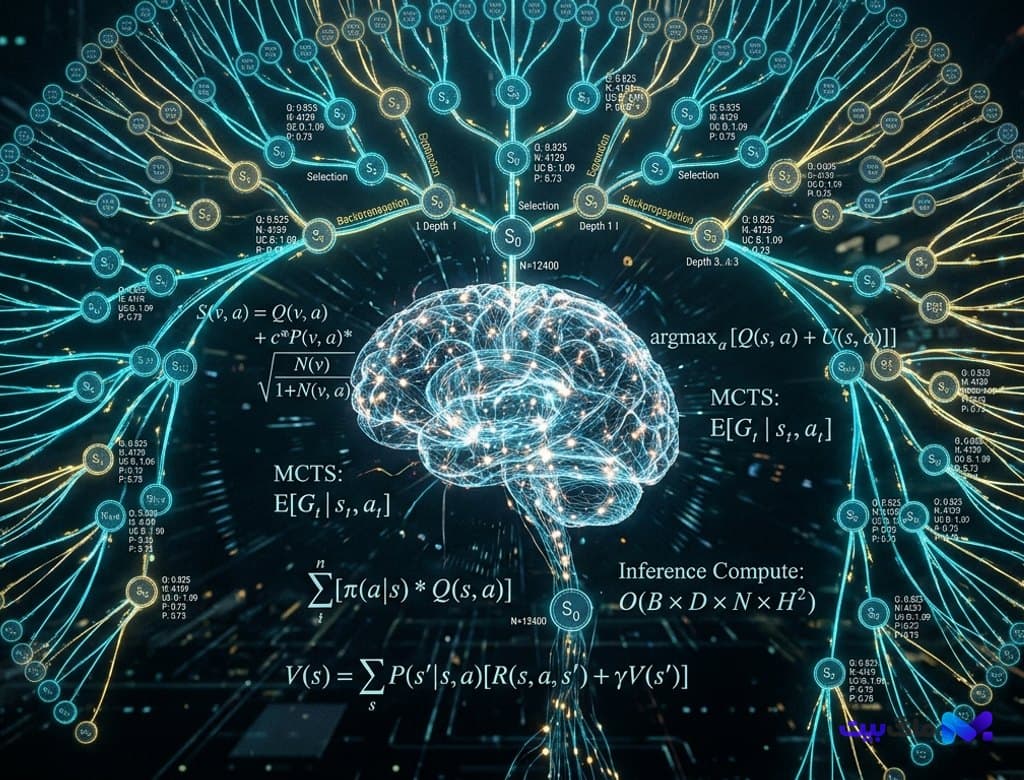
- تحلیل جامع و بنیادین تحول شگرف مدلهای هوش مصنوعی استدلالگر امروزه. کالبدشکافی اشباع قوانین سنتی مقیاسپذیری پیشآموزش (Pre-training Scaling Laws) و جابهجایی پارادایم به سمت تخصیص پویای محاسبات در مرحله استنتاج (Test-Time Compute). واکاوی سازوکار جستجوی درختی مونتکارلو (MCTS)، مدلهای پاداش فرآیندمحور (Process-based Reward Models) و توانایی بازگشت به عقب (Backtracking) در شاخههای اشتباه محاسباتی. بررسی پیامدهای این جهش در حذف توهم، اثبات فرمال قضایای ریاضی، کشف داروها و کدنویسی خوداصلاحگر، همراه با ارزیابی هزینههای پردازشی و ضرورت ادغام با سختافزارهای شتابدهنده نوین.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
دیوار مقیاسپذیری پیشآموزش؛ چرا هوش مصنوعی به تفکر در زمان پاسخگویی نیاز داشت؟
برای بیش از یک دهه، فرمول طلایی توسعه هوش مصنوعی مولد بر یک اصل ساده استوار بود: تزریق دادههای متنی عظیمتر و افزایش تصاعدی ترانزیستورهای کلاسترهای آموزشی. اما تا نیمه نخست دوران معاصر این رویکرد به اصطلاح قانون مقیاسپذیری چنچیلا (Chinchilla Scaling) با بازده نزولی و پایان ذخایر دادههای باکیفیت انسانی برخورد کرد. مدلها متون روانتری مینوشتند، اما در مواجهه با استدلالهای چندلایه ریاضی، کشف آسیبپذیریهای پیچیده نرمافزاری و تفکر استنتاجی، کماکان با خطاهای مهلک و پدیده توهم دستبهگریبان بودند.
دلیل ریشهای این محدودیت در معماری اتورگرسیو نهفته بود: مدل برای تولید هر توکن بعدی تنها چند میلیثانیه پردازش ثابت صرف میکرد؛ چه در پاسخ به پرسش سادهای مثل پایتخت فرانسه و چه هنگام اثبات حدسهای اثباتنشده هندسه ریمانی! همانطور که در واکاوی شتابدهندههای هوش مصنوعی تمامنوری و فوتونیک شرح دادیم، افزایش توان پردازش فیزیکی تنها یک روی سکه است و بدون اصلاح الگوریتمهای شناختی، بهرهوری محاسباتی حاصل نخواهد شد.
دوران کنونی نقطه عطف ظهور پارادایم «مقیاسپذیری در زمان استنتاج» (Inference-Time Scaling) است. در این شیوه انقلابی، به جای متمرکز کردن ۹۹ درصد بودجه پردازش در فاز آموزش، به مدل اجازه داده میشود بر اساس دشواری مسئله، از چند ثانیه تا چندین دقیقه زمان صرف «فکر کردن»، سنجش سناریوهای مختلف و هرس مسیرهای بنبست کند.
کالبدشکافی درخت تفکر؛ تلفیق جستجوی مونتکارلو با مدلهای پاداش فرآیندمحور (PRM)
سازوکار مرکزی این تفکر عمیق بر دو ستون ریاضی استوار است: جستجوی درختی هدایتشده شبیه به الگوریتمهای شطرنج و ارزیابی گامبهگام منطق. در مدلهای سنتی، پاداش تنها بر اساس درستی یا نادرستی نتیجه نهایی (Outcome-based Reward) اعطا میشد؛ رویکردی که نمیتوانست خطاهای مخفی در گامهای میانی استدلال را شناسایی کند.
در سیستمهای استدلالپایه دوران کنونی از مدلهای پاداش فرآیندمحور (Process-based Reward Models یا PRM) استفاده میشود. مدل در مواجهه با یک مسئله، فضای احتمالات را به صورت یک درخت تصمیمگیری مونتکارلو (MCTS) گسترش میدهد. در هر گره، موتور PRM به هر جمله یا فرمول یک امتیاز اطمینان میدهد؛ اگر امتیازی کمتر از آستانه اطمینان باشد، سیستم فورا مکانیزم بازگشت به عقب (Backtracking) را فعال کرده و شاخه دیگری از درخت تفکر را بررسی میکند.
این فرآیند بازگشتی خوداصلاحگر (Self-Correction Loop) باعث میشود که نرخ خطای سیستم در آزمونهای دشوار المپیاد ریاضی، مهندسی مکانیک کوانتومی و رمزنگاری به شکل چشمگیری به صفر میل کند؛ قابلیتی که پیش از این برای هیچ سیستم یادگیری عمیقی متصور نبود.
همگرایی با گراف دانشی؛ تضمین حقایق و استدلال بدون توهم
یکی از چالشهای بنیادین استدلال طولانیمدت، خطر انحراف در عمق تفکر و پدید آمدن حلقههای باطل منطقی است. برای مهار این مسئله امروزه مدلهای استدلالگر به طور مستقیم با پایگاهدادههای گراف دانشی و برداری GraphRAG یکپارچه شدهاند. در طول جستجوی درختی، هر فرضیه تولیدشده با گرههای دانشی واقعیتسنجی شده و صحت ارتباطات معنایی آن به طور قطعی ارزیابی میشود.
این همافزایی هوشمند، امکان مدلسازی جهان واقعی را فراهم میکند؛ دستاوردی که مکمل مستقیم مدلهای جهانی فیزیکمحور و شبیهسازی Spatial AI در روباتیک خودمختار است. به عنوان مثال، یک ایجنت نرمافزاری اکنون میتواند پیش از نوشتن حتی یک خط کد در محیط عملیاتی، هزاران شاخه از اثرات متقابل تغییرات را شبیهسازی و اعتبارسنجی کند.
علاوه بر این، تکنیکهای جستجوی پرتو (Beam Search) با ارزیابی چندگانه مسیرها (Best-of-N Sampling) در ترکیب با مدلهای تایید اعتبار صوری (Formal Verifiers)، راه را برای خلق سیستمهای نرمافزاری کاملاً اثباتشده و عاری از هرگونه رخنه امنیتی گشوده است.
اقتصاد محاسبات شناختی و چشمانداز هوش مصنوعی فراگیر در اواخر
تغییر تمرکز از آموزش به استنتاج، ساختار تجاری صنعت فناوری را نیز دستخوش دگرگونی کرده است. هزینه استعلامهای ساده به دلیل کوچکتر شدن مدلهای پایه (Base Models) به شدت افت کرده، در حالی که تقاضا برای پردازشهای سنگین و طولانی در پروژههای حیاتی پزشکی و فضایی افزایش یافته است.
در نهایت، پارادایم Test-Time Compute اثبات کرد که هوش مصنوعی نیازی به شبیهسازی یکپارچه مغز انسان با تریلیونها پارامتر ساکن ندارد؛ بلکه کلید دستیابی به هوش جامع مصنوعی (AGI)، شبیهسازی فرآیند تفکر تاملبرانگیز، خودانتقادی و تلاش برای کشف بهترین مسیر تصمیمگیری در دنیای واقعیات است.
بیشتر از هوش مصنوعی



