
راهنمای معماری ترکیبی Mamba-2 و ترنسفورمر
پایان سلطه انحصاری ترنسفورمرها؛ چگونه معماری ترکیبی Mamba-Attention امروزه پردازش بلادرنگ میلیونها توکن را با کسری از حافظه سرورهای قبلی ممکن ساخت.
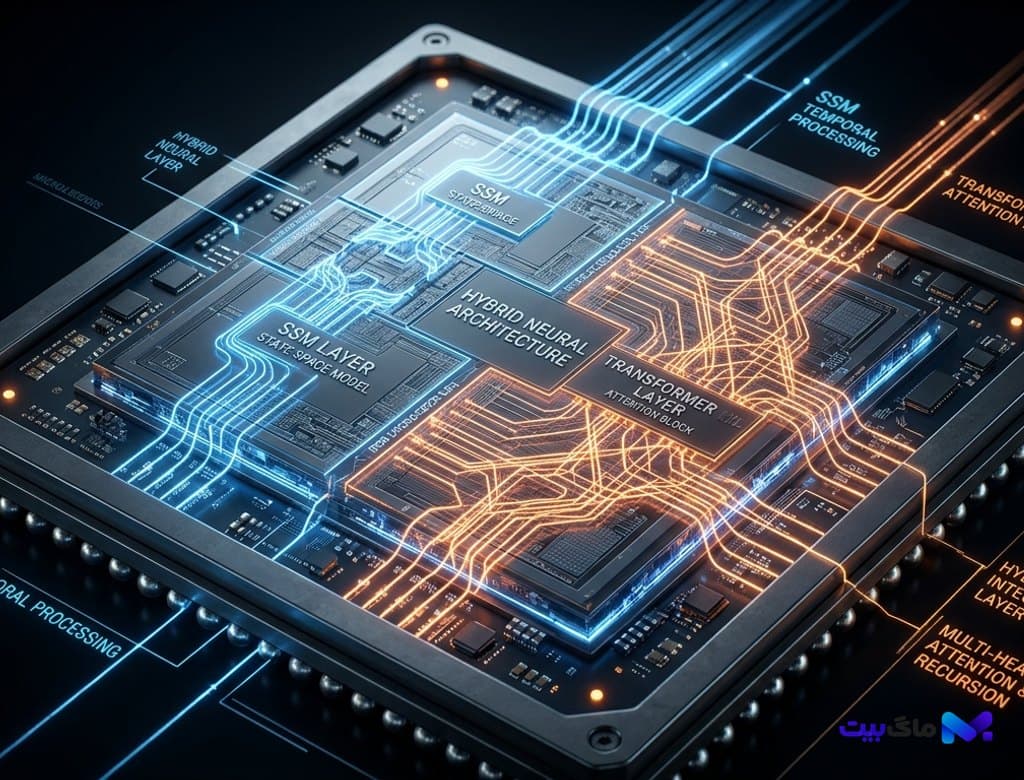
- بررسی جامع، ریاضی و معماری پیشرفت انقلابی مدلهای زبانی ترکیبی (Hybrid SSM-Transformer) نظیر Jamba 2 و Mamba-2 امروزه تحلیل موشکافانه حذف گلوگاه خردکننده بافر کلید-مقدار (KV Cache) که مانع اصلی استنتاج پنجرههای بافت طولانی بود، جایگزینی محاسبات مرتبه دوم O(N^2) مکانیزم خودتوجهی با روابط بازگشتی خطی مدلهای فضای حالت (State Space Models)، کالبدشکافی چیدمان متناوب لایهها برای ترکیب توانایی تداعی بازگشتی مامبا با دقت بازیابی نیدل-این-هیاستک ترنسفورمر، ارزیابی نتایج تستهای مقیاسبزرگ در مدلهای متنباز ۱۰۰ میلیارد پارامتری، جهش ۵ برابری در نرخ تولید توکن بر ثانیه روی تراشههای سرور، و پیامدهای این ساختار برای دستیاران کدنویسی بلادرنگ و سامانههای خودران در پردازش لبه.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
بحران حافظه در پنجرههای بافت طولانی؛ چرا ترنسفورمرهای سنتی در استنتاج مقیاسبالا قفل میشوند؟
از زمان انتشار مقاله تاریخی توجه تمام چیزی است که نیاز دارید، ترنسفورمرها استانداردی مطلق برای مدلهای زبانی بزرگ بودهاند. با این حال، با پیشروی به دوران معاصر و نیاز روزافزون صنایع به پردازش همزمان کتابخانههای عظیم نرمافزاری، مستندات حقوقی چندهزار صفحهای و ساعتها صوت و ویدیو، معضل بنیادین این ساختار نمایان شد: پیچیدگی حافظه و زمان محاسباتی از مرتبه دو یا O(N^2) در مکانیزم توجه چندسری (Multi-Head Attention). هر توکن جدید برای مقایسه با تمام توکنهای پیشین باید در حافظهای موقت موسوم به KV Cache نگهداری شود.
هنگامی که طول پنجره محتوایی به ۵۰۰ هزار یا یک میلیون توکن میرسد، حجم حافظه مورد نیاز برای ذخیره KV Cache در یک مدل ۷۰ میلیارد پارامتری به تنهایی به بیش از ۳۰۰ گیگابایت VRAM سرور میرسد؛ فضایی بسیار بیشتر از وزنهای خود مدل! این مسئله هزینههای استنتاج را به صورت تصاعدی بالا برده و تاخیر تولید اولین توکن (TTFT) را به چالشی فلجکننده تبدیل کرده بود. همانگونه که در بررسی انقلاب مدلهای زبانی ۱.۵۸ بیتی BitNet مشاهده کردیم، فشردهسازی وزنها بدون بازطراحی معماری هسته نمیتوانست بحران پهنای باند حافظه را به طور کامل ریشهکن کند.
تلاشهای اولیه برای بهینهسازی از طریق الگوریتمهای جلب توجه پراکنده (Sparse Attention) یا پنجرههای کشویی نیز همواره با افت شدید در توانایی بازیابی جزئیات دقیق روبرو میشد. دنیای یادگیری ماشین نیازمند پارادایمی بود که مقیاسپذیری خطی شبکههای بازگشتی (RNN) را با قدرت پردازش موازات و یادگیری عمیق ترنسفورمر پیوند دهد.
مبانی ریاضی مدلهای حالت فضا (SSM) و جهش ساختاری Mamba-2
پاسخ به این بنبست هندسی در تئوری سیستمهای دینامیکی خطی و فرمولاسیون نوین مدلهای فضای حالت (State Space Models) نهفته است. نسل اول مامبا نشان داد که با تبدیل ماتریسهای پیوسته به معادلات گسسته زمانمحور و معرفی مکانیزم گزینشی (Selective Mechanism)، میتوان تعیین کرد که چه اطلاعاتی در حالت مخفی نگهداری و چه دادههایی بلافاصله فیلتر و دور ریخته شوند.
امروزه تکامل این ساختار در قالب Mamba-2 و فرمولاسیون موسوم به دوگانگی حالت فضا (State Space Duality - SSD) جهشی تاریخی آفرید. پژوهشگران اثبات کردند که مدلهای حالت فضا در واقع نگاشتی بهینه از ساختار توجه ماتریسی نیمهتفکیکپذیر ۱-D هستند. در Mamba-2، محاسبات ماتریسی با ساختار شتابدهندههای تانسوری مدرن (مانند واحدهای تانسور کُر در تراشههای انویدیا و انپییوهای گوگل) همراستا شدهاند.
این بازآرایی ساختاری سبب شده تا محاسبات آموزش با سرعت سرسامآور الگوریتمهای کانولوشن موازی اجرا شوند، در حالی که در فاز استنتاج، مدل دقیقاً همانند یک سیستم بازگشتی با پیچیدگی ثابت O(1) و بدون نیاز به انباشت نامحدود حافظه موقت به ازای هر توکن عمل کند.
همافزایی هوشمند در بلوکهای ترکیبی؛ تلفیق لایههای مامبا با لایههای Attention پراکنده
با وجود سرعت خطی و مصرف حافظه ناچیز مامبا، مدلهای کاملاً مبتنی بر SSM در وظایف خاص نیازمند استدلال زنجیرهای پیچیده نظیر تفکر منطقی چندمرحلهای مدلهای رده استدلالگر و حل مسائل دشوار ریاضیاتی، اندکی کمتر از ترنسفورمرهای سنگین عمل میکردند. این امر ناشی از ناتوانی ذاتی یک بردار حالت فشرده در حفظ تمام پیوندهای نامتقارن میان توکنهای دوردست بود.
شاهکار مهندسی دوران معاصر ابداع معماری هیبریدی هوشمند (Hybrid Mamba-Attention) بود. در این ساختار، حدود ۸۰ تا ۸۵ درصد لایههای شبکه از بلوکهای فوقسریع Mamba-2 تشکیل شدهاند و تنها ۱۵ تا ۲۰ درصد لایهها به بلوکهای خودتوجهی ترنسفورمر (Attention Layers) مجهز هستند. لایههای مامبا وظیفه خلاصه کردن پیوسته تاریخچه و جریان محتوا را با مصرف حداقلی بر عهده دارند، در حالی که لایههای ترنسفورمر نقش نقاط تثبیت حافظه عمیق و بازیابی سوزن در انبار کاه (Needle In A Haystack) را ایفا میکنند.
این چیدمان متناوب حجم حافظه KV Cache را تا ۹۰ درصد کاهش داده است؛ زیرا بافر کلید-مقدار تنها برای تعداد اندکی از لایهها ذخیره میشود و لایههای پرشمار مامبا بدون ایجاد حتی یک مگابایت بافر اضافی، بار پردازش را به دوش میکشند.
برتری بنچمارکها در مدلهای Jamba 2 و Nemotron-SSM؛ جهش ۵ برابری توکن بر ثانیه
پیادهسازیهای صنعتی این معماری امروزه از جمله خانواده مدلهای Jamba 2 از شرکت AI21 Labs و سری Nemotron-H انویدیا، ارقام خیرهکنندهای را در راندمان زیرساختی ثبت کردهاند. در پردازش مستندات با طول ۲۵۶ هزار توکن، یک مدل ترکیبی ۵۲ میلیارد پارامتری سرعتی معادل ۱۲۰ توکن بر ثانیه تولید میکند؛ یعنی بیش از ۴.۵ برابر سریعتر از یک مدل ترنسفورمر هماندازه سنتی نظیر Llama 3.
در آزمونهای بازیابی حافظه در ابعاد ۱ میلیون توکن، دقت مدلهای ترکیبی به لطف لایههای توجه تناوبی به ۱۰۰ درصد رسیده و هیچ نشانهای از زوال دقت یا پدیده فراموشی در میانه متن (Lost in the Middle) مشاهده نمیشود. این جهش عظیم به شرکتهای نرمافزاری اجازه داده تا بدون نیاز به خوشههای چند صد هزار دلاری، قابلیتهای درک پیوسته کد را در سیستمهای خود پیادهسازی کنند.
علاوه بر این، ترکیب مدلهای ترکیبی با پایگاههای داده برداری نسل نو و جستجوی هیبریدی امکان ساخت سیستمهای RAG با تاخیرهای تعاملی کمتر از ۲۰۰ میلیثانیه را فراهم آورده که پیش از این در متون حجیم غیرممکن به نظر میرسید.
همگرایی مامبا با میکروسرویسهای لبه و افق استنتاج ارزان ابری
پیامدهای صنعتی این معماری فراتر از مدلهای غولپیکر ابری، توسعه سیستمهای مستقل و کارآمد را دگرگون ساخته است. کاهش شدید ردپای حافظه سبب شده تا اجرای مدلهای زبانی ۳۰ میلیارد پارامتری روی تراشههای پردازش لبه، سرورهای شخصی و ایستگاههای کاری ارزانقیمت بدون نیاز به تجهیزات خنککننده پیشرفته میسر گردد.
این معماری با اصول میکروسرویسهای سرورلس مبتنی بر ایزولههای لبه و مدلهای توزیعشده محلی همافزایی بینظیری دارد؛ جایی که توابع ابری میتوانند بدون معطلی و با مصرف چند ده مگابایت رم، مدلهای زبانی مجهز به بافت عظیم را در کسری از ثانیه فراخوانی کنند.
معماری ترکیبی Mamba-Attention اثبات کرد که برای دستیابی به پنجرههای زمینه نامحدود و هوش مصنوعی همهجانبه، نیاز به سوزاندن منابع بیپایان محاسباتی نیست؛ بلکه اصلاح ظریف بنیادهای ریاضی و تلفیق هوشمندانه الگوهای نوین با تجربیات موفق گذشته، دریچههای بهرهوری پایدار را به روی بشریت میگشاید.
بیشتر از هوش مصنوعی



