
بازطراحی زیرساختهای کلانداده با استاندارد جهانی ISO GQL
انقلابی همتراز با پیدایش SQL در دهه ۸۰؛ استاندارد رسمی ISO GQL و پردازندههای DPU امروزه پایگاههای داده گراف را به سرعتی مافوق صوت در پیمایش میلیاردها ارتباط رساندهاند.
- تحلیل تخصصی عمیق تحول دیتابیسهای مدرن امروزه اجرایی شدن گسترده نخستین استاندارد رسمی بینالمللی زبان کوئرینویسی گراف ISO GQL (ISO/IEC 39075) و عبور از زبانهای متفرق مانند Cypher و Gremlin. بررسی مهندسی موتورهای ذخیرهسازی بومی گراف (Native Graph Storage Engines) با ساختار بدون شاخص Index-Free Adjacency، ترکیب فرمت حافظهای ستونی Apache Arrow Flight SQL برای جریان دادههای پرسرعت، و بهکارگیری تراشههای پردازش داده (DPU) با شتابدهندههای سختافزاری پیمایش پوینترها جهت مهار گلوگاه پهنای باند حافظه در کشف تقلبهای بانکی و گرافهای دانش هوش مصنوعی سازمانی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پیدایش استاندارد ISO GQL؛ عبور از مجمعالجزایر زبانهای ناسازگار گراف
از زمان تولد مدل رابطهای تا سالها، زبان SQL به عنوان ستون فقرات یکپارچه مدیریت داده در سراسر صنعت نرمافزار حکمرانی میکرد. اما هنگامی که نیاز به مدلسازی شبکههای پیچیده با میلیاردها یال ارتباطی (نظیر تحلیل کلاهبرداریهای چندمرحلهای، زنجیرههای تأمین و گرافهای دانش هوش مصنوعی) به وجود آمد، پایگاههای داده گراف ظهور کردند؛ اما این حوزه سالها از فقدان یک استاندارد واحد رنج میبرد. توسعهدهندگان ناچار بودند میان زبانهای اختصاصی ناسازگار مانند Cypher، Gremlin و PGQL دست به انتخاب بزنند که منجر به قفل شدن شدید در یک ارائهدهنده خاص (Vendor Lock-in) و عدم امکان بازنویسی بهینه کوئریها میشد.
امروزه تصویب و استقرار نهایی استاندارد ISO/IEC 39075 تحت عنوان رسمی ISO GQL (Graph Query Language)، نقطه عطفی تاریخی در مهندسی داده ثبت کرد؛ این نخستین بار پس از استانداردسازی SQL در سال ۱۹۸۷ است که یک زبان کامل مدیریت داده به تصویب نهاد بینالمللی ISO میرسد. استاندارد GQL ترکیب کمنظیری از قابلیت تطبیق الگوهای تو در تو (Nested Pattern Matching)، عبارات فیلترینگ مسیر انعطافپذیر (Quantified Path Patterns) و مدیریت گرافهای نوعدار قوی (Strictly Typed Property Graphs) را با هم ادغام کرده است. این قابلیت مستقیماً از دستاوردهای تشریحشده در مدلهای جهانی فضایی و 4D Gaussian Splatting پشتیبانی میکند؛ جایی که روابط علت و معلولی میان اشیا در قالب گرافهای توزیعشده با GQL مدلسازی میشوند.
موتورهای کامپایلر GQL با درک ساختار جبری پرسوجوها، میتوانند پلنهای اجرایی را پیش از اجرا بهینهسازی کرده و الگوهای پرهزینه تقاطعی را با کمترین میزان مصرف حافظه و حداقل پیمایشهای تکراری پردازش کنند.
معماری ذخیرهسازی گراف بومی (Native Storage) و شاخصزدایی پوینترها
پایگاههای داده غیربومی (Non-Native) که گراف را روی جداول رابطهای یا موتورهای سندمحور شبیهسازی میکردند، در پیمایشهای چندگامی (Multi-Hop Traversals) با افت شدید عملکرد مواجه میشدند؛ زیرا هر گام نیازمند جستجوی سنگین در شاخصهای B-Tree و جوینهای حافظهبر بود. امروزه موتورهای بومی مدرن بر پایه ساختار همجواری بدون شاخص (Index-Free Adjacency) بازطراحی شدهاند. در این ساختار، هر گره مستقیماً حاوی آدرس حافظهای یالهای خروجی و ورودی خود است.
پیمایش یک مسیر در این موتورها، به جای جستجوی شاخص، صرفاً به معنای دیرفرنس کردن پوینترهای حافظه با پیچیدگی زمانی O(1) در ازای هر یال است. برای تضمین همروندی در شرایط تراکنشهای سنگین، ساختارهای بدون قفل مبتنی بر کنترل همروندی چندنسخهای (MVCC) در حافظه اعمال شده که امکان پردازش همزمان هزاران درخواست نوشتن و خواندن را بدون ایجاد گلوگاه تضمین میکند. این پیشرفت پیوندی تنگاتنگ با معماریهای معرفیشده در پایگاهدادههای برداری توزیعشده با حافظه CXL 3.1 دارد؛ جایی که لایهبندی حافظه با تاخیر نانوثانیهای مهار ایندکسهای صد میلیارد برداری را ممکن ساخته است.
همچنین تلفیق فشردهسازی دودویی در سطح بایتها، مصرف حافظه رم برای نگهداری گرافهای بزرگ با بیش از ۵۰ میلیارد یال را به کمتر از یکچهارم کاهش داده و مانع از سرریز حافظه در سرورهای ابری میشود.
تسریع سختافزاری با تراشههای پردازش داده DPU و انتقال برداری با Arrow Flight
حتی با وجود ذخیرهسازی بومی، پیمایش مسیرهای طولانی گراف در پردازندههای مرکزی همهمنظوره (x86 CPU) با مانع فیزیکی افت کش (Cache Miss) و گلوگاه پهنای باند حافظه مواجه میشد؛ زیرا پرشهای تصادفی پوینترها در حافظه خطوط کش پردازنده را بیاثر میکرد. امروزه کارتهای شتابدهنده DPU (Data Processing Units) با هستههای تخصصی پیمایش موازی حافظه (Pointer-Chasing Accelerators) این گلوگاه را از میان برداشتهاند.
تراشههای DPU وظیفه پیمایش گراف را از پردازنده اصلی تحویل گرفته و با بهرهگیری از خطوط موازی دسترسی مستقیم به حافظه دوردست (RDMA)، میلیونها یال را در هر میکروثانیه دنبال میکنند. از سوی دیگر، جریان نتایج استخراجشده بدون نیاز به سریالسازیهای کند متنی JSON، مستقیماً با پروتکل پرسرعت Apache Arrow Flight SQL بر بستر حافظه ستونی استریم میشود. این فناوری تاخیر شبکه در واکشی نتایج به سرورهای هوش مصنوعی را تا بیش از ۹۰ درصد کاهش داده است؛ امری حیاتی که سیستمهای حسگری سیستمهای هدایت تمام الکترونیکی Steer-by-Wire برای تحلیل لحظهای گرافهای موقعیتی به آن اتکا دارند.
ترکیب سختافزار DPU و پایپلاین Arrow به شرکتهای خدمات مالی این توانایی را بخشیده که الگوهای مشکوک پولشویی در حلقههای ۶ لایه تراکنشی را در کمتر از ۱۰ میلیثانیه کشف کرده و پیش از نهایی شدن حواله، دستور توقف صادر نمایند.
نقش حیاتی در Graph-RAG و نسل آینده هوش مصنوعی معنایی سازمانی
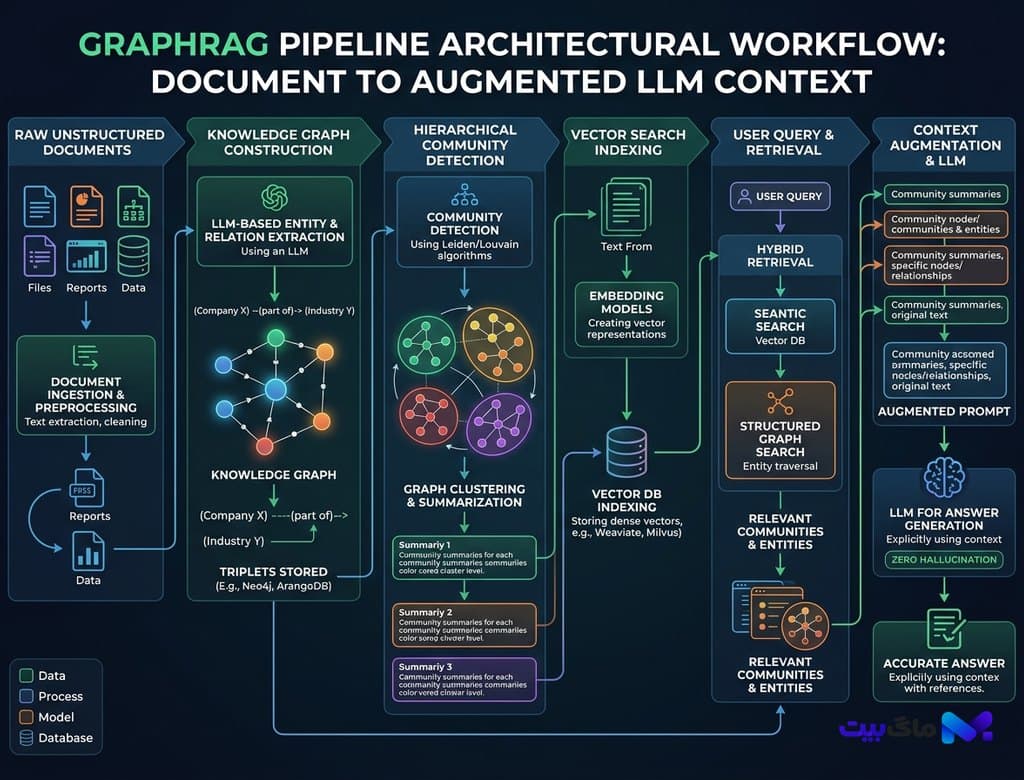
با گسترش سامانههای تولید با بازیابی افزوده بر پایه گراف (Graph-RAG)، نیاز به پایگاههای گراف با استاندارد GQL به بالاترین سطح در تاریخ مهندسی نرمافزار رسیده است. در گذشته، چتباتهای سازمانی به دلیل اتکای صِرف به تشابه برداری متن، از درک روابط عمیق ساختاری ناتوان بودند و پاسخهایی متناقض با اسناد حقوقی و مالی ارائه میکردند. با استقرار گرافهای سازگار با GQL، عاملهای هوشمند میتوانند کوئریهای صریح ساختاریافته تولید کرده و زنجیره استنادها را با قطعیت صددرصدی اعتبارسنجی نمایند.
سازمانهای بزرگ صنعتی اکنون کل مستندات مهندسی، کدهای نرمافزاری و تاریخچه تصمیمات مدیریتی خود را در قالب یک پایگاه گراف یکپارچه با چندین هزار میلیارد یال نگهداری میکنند و هر کارمند میتواند با زبان طبیعی، پیچیدهترین پرسشهای تحلیلی را در کسری از ثانیه با دقت علمی دریافت نماید.
دوران کنونی گواهی است بر بلوغ کامل فناوری گراف؛ استانداردی که نه تنها دادهها را ذخیره میکند، بلکه معنا، ارتباط و بافتار دنیای دیجیتال را در ساختاری شفاف، سریع و استاندارد برای نسلهای آینده مهندسی نرمافزار حفظ مینماید.
بیشتر از فناوری



