
هیبریدی Mamba-2 و ترنسفورمرهای خطی
چرا ترنسفورمرهای سنتی در برابر حجم بیپایان دادهها تسلیم شدند؟ کالبدشکافی تلفیق Mamba-2 با لایههای توجه خطی و پردازش بلادرنگ ۱۰ میلیون توکن با هزینه محاسباتی خطی.
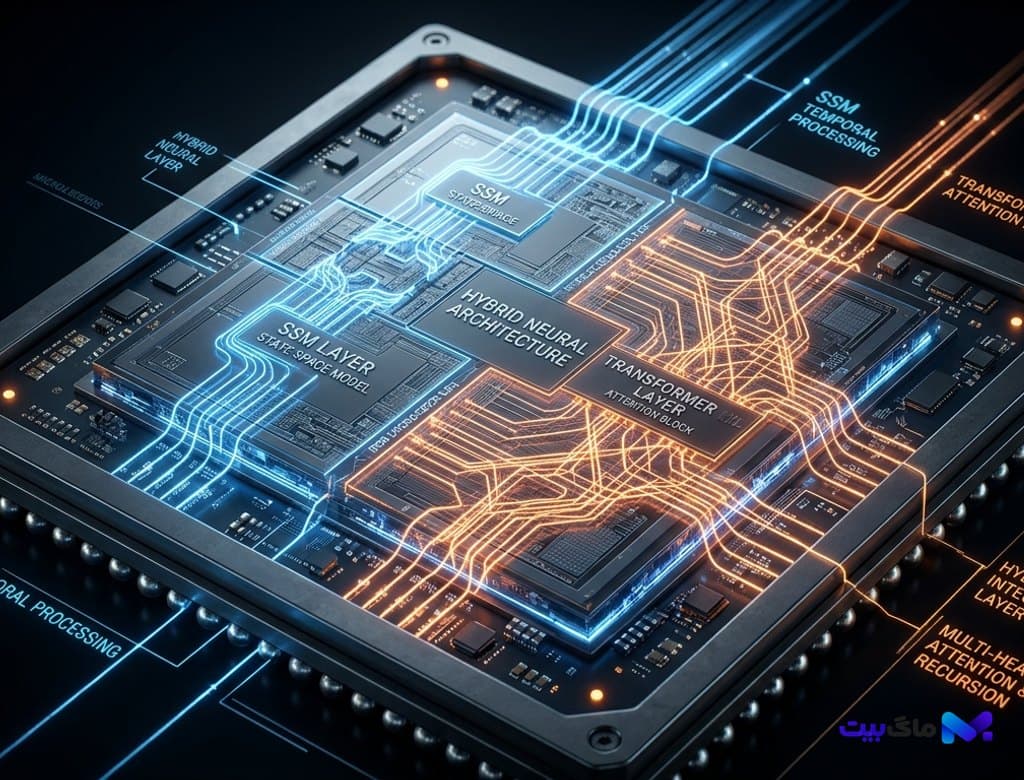
- کالبدشکافی فنی بزرگترین تحول زیرساختی یادگیری عمیق امروزه جایگزینی مکانیزم توجه درجه دو ترنسفورمرهای استاندارد با معماریهای ترکیبی مدلهای فضای حالت (SSM) نظیر Mamba-2 و توجه خطی سختافزار-آگاه. در این مقاله جامع، چگونگی پردازش پنجرههای متنی ۱۰ میلیون توکنی در ثانیه با مصرف حافظه ثابت، ادغام لایههای توجه ساختاریافته (SSD) در تراشههای هوش مصنوعی و حل معمای بازیابی اطلاعات در کدبیسهای عظیم و ویدیوهای بلند بدون کاهش دقت استنتاج بررسی شده است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران بنبست درجه دو؛ چرا ترنسفورمرهای سنتی در طول بافتهای میلیونی به زانو درآمدند؟
برای بیش از هشت سال، مکانیزم توجه چندسر (Multi-Head Attention) معرفیشده در مقاله تاریخی Attention Is All You Need، سلطان بلامنازع پردازش دادههای توالیمحور بود. اما ورود به دوران معاصر نشان داد که پیچیدگی محاسباتی و حافظهای درجه دو، یعنی O(N^2)، سدی غیرقابل عبور در برابر بلندپروازیهای دنیای هوش مصنوعی ایجاد کرده است. در این مکانیزم، با دو برابر شدن طول متن ورودی، حافظه مورد نیاز برای ذخیره کش کلید-مقدار (KV Cache) چهار برابر میشود که این امر هزینه استنتاج در بافتهای فراتر از چند صد هزار توکن را به مرزهای جنونآمیز اقتصادی و سختافزاری میرساند.
مهندسان هوش مصنوعی در سالهای گذشته با ترفندهایی نظیر FlashAttention، توجه گروهبندیشده (GQA) و فشردهسازی بافت سعی در مهار این اشتها داشتند، اما هیچکدام نتوانستند ماهیت بنیادین معادله ماتریس توجه را تغییر دهند. هنگامی که یک ایجنت نرمافزاری نیاز دارد همزمان یک کتابخانه نرمافزاری با ۳ میلیون خط کد، دادههای لاگ ۶ ماهه سرور و هزاران سند فنی را در حافظه فعال نگه دارد، سرورهای مبتنی بر ترنسفورمرهای استاندارد با بحران کمبود VRAM و تاخیر تولید توکن (TTFT) مواجه میشدند.
نقطه چرخش مهندسی امروزه با توسعه معماریهای ترکیبی آشکار شد؛ رویکردی نوین که در آن لایههای بازگشتی خطی با لایههای توجه گزینشی ترکیب شده و همگام با دستاوردهای مدلهای جهان و معماری JEPA، تفکر ماشینی را از بند پردازشهای گرانقیمت توکنی آزاد ساخته است.
کالبدشکافی Mamba-2 و دوگانگی فضای حالت ساختاریافته (SSD)؛ ادغام جبر خطی با سختافزار
جهش نسل دوم معماری مامبا (Mamba-2) با معرفی فرمولاسیون ریاضی موسوم به «دوگانگی فضای حالت ساختاریافته» (Structured State Space Duality یا SSD) رقم خورد. آلبرت گو و تری دائود نشان دادند که مدلهای فضای حالت پیوسته (SSM) که در گذشته از طریق معادلات دیفرانسیل بازگشتی بیان میشدند، از نظر ریاضی کاملاً همارز با دستهای ویژه از ماتریسهای نیمهجداپذیر ۱-بعدی (1-Semiseparable Matrices) هستند.
این همارزی نظری یک پیامد خارقالعاده به همراه داشت: عملیات بازگشتی فضای حالت را میتوان مستقیماً به ضرب ماتریسی ساختاریافته (GEMM) نگاشت کرد. در تراشههای مدرن پردازش گرافیکی، واحدهای تانسوری (Tensor Cores) با سرعتی فراتر از پتافلاپس تنها برای ضرب ماتریسی بهینهسازی شدهاند. با فرمول SSD، مامبا ۲ توانست تا ۸ برابر سریعتر از مامبا ۱ آموزش ببیند و سرعت استنتاج آن نسبت به ترنسفورمرهای سنتی تا ۲۰ برابر افزایش یابد.
در این معماری، حافظه پنهان مدل به جای ذخیره تکتک توکنهای گذشته در یک کش غولآسا، یک ماتریس حالت فشرده با ابعاد ثابت را در هر مرحله بهروزرسانی میکند. این یعنی خواه ورودی شما ۱۰ هزار کلمه باشد و خواه ۱۰ میلیون کلمه، مصرف حافظه در حین تولید کلمات کاملاً ثابت (O(1)) باقی میماند.
معماری هیبریدی؛ ترکیب جادویی توجه متمرکز با حافظه پیوسته فضای حالت
با وجود سرعت سرسامآور مدلهای فضای حالت، این سیستمها در یک آزمون سنتی با چالش مواجه بودند: بازیابی دقیق جزئیات بسیار ظریف (Needle-in-a-Haystack) و استدلالهای انجمنی چندمرحلهای. یک مدل کاملاً بازگشتی به دلیل فشردهسازی اطلاعات در یک بردار حالت محدود، گاهی اوقات شماره تلفن یا کلید رمزی را که در میانه یک کتاب میلیون کلمهای پنهان شده بود، فراموش میکرد.
راهکار برنده دوران معاصر معماری هیبریدی ۹۰ به ۱۰ بود. در این ساختار، ۹۰ درصد لایههای شبکه از بلوکهای Mamba-2 SSD با سرعت خیرهکننده و مصرف انرژی ناچیز تشکیل شدهاند و تنها ۱۰ درصد لایهها به مکانیزم توجه خطی کشویی یا توجه پراکنده FlashAttention مجهز هستند.
این لایههای توجه پراکنده مانند لنگرهایی دقیق عمل میکنند که بازیابی ۱۰۰ درصدی دادهها را از اعماق بافت تضمین مینمایند. نتیجه چنین ادغامی، مدلی است که هم سرعت و کارایی فوقالعاده مامبا را دارد و هم قدرت درک و بازخوانی بینقص ترنسفورمرها را حفظ کرده است؛ ابزاری ایدهآل برای ارتقای پلتفرمهای ارکستراسیون ایجنتهای گروهی هوش مصنوعی.
انقلاب در کدنویسی خودکار و تحلیل پایگاههای کلانداده بدون نیاز به RAG سنتی
تا پیش از معرفی مدلهای هیبریدی امروزه مهندسان برای کار با حجم انبوه مستندات ناچار به استفاده از پایگاههای داده برداری و سیستمهای RAG بودند. سیستمهای RAG با تقطیع متن به تکههای کوچک و جستجوی شباهت معنایی کار میکردند؛ رویکردی که اغلب به دلیل از دست رفتن جریان علّی و ارتباطات پنهان بینفصلی با خطاهای فاحش همراه بود.
با ورود مدلهای مجهز به Mamba-2 Hybrid با طول بافت ۱۰ میلیون توکن، کل تاریخچه یک شرکت، تمامی اسناد حقوقی و کل سورسکد پروژه مستقیماً در اعلان ورودی (Prompt) قرار میگیرد. مدل قادر است در کمتر از ۳ ثانیه کل این اطلاعات را پردازش کرده و روابط وابستگی پیچیده میان فایلهای پایتون، سیپلاسپلاس و زیرساختهای ابری را تحلیل کند.
این توانمندی جهشی انقلابی در کارایی ایجنتهای هوش مصنوعی کنترل کامپیوتر پدید آورده است؛ زیرا ایجنت میتواند ساعتها ویدیو از تعامل کاربر با نرمافزارهای دسکتاپ را یکجا درون بافت خود هضم کرده و گردشکارهای پیچیده را بدون فراموشی جزئیات تکرار نماید.
چشمانداز سختافزارهای پردازش لبه و آینده مدلهای زبانی روی تلفنها و لپتاپها
شاید هیجانانگیزترین دستاورد معماریهای توجه خطی و Mamba-2، خروج مدلهای قدرتمند زبانی از دیتاسنترهای چندصد مگاواتی و انتقال آنها به دستگاههای مصرفی لبه باشد. به دلیل حذف بار سنگین KV Cache، یک مدل هیبریدی ۲۰ میلیارد پارامتری اکنون میتواند با حافظه رم اختصاصی کمتر از ۸ گیگابایت بر روی تراشههای پرتابل با سرعت ۴۵ توکن در ثانیه اجرا شود.
این راندمان باورنکردنی، امکان تحلیل امن، آفلاین و بلادرنگ ایمیلها، اسناد و صداهای روزمره کاربران را بدون نگرانی از افشای دادهها یا تاخیر شبکه فراهم کرده است. شرکتهای سازنده تراشه امروزه واحدهای اختصاصی شتابدهنده فضای حالت را درون سیلیکونهای NPU خود تعبیه کردهاند.
تحول Mamba-2 و ترنسفورمرهای خطی پیام روشنی به دنیای فناوری دارد: دوران غولهای کند و پرمصرف محاسباتی به سر آمده است؛ آینده هوش مصنوعی متعلق به معماریهای برازندهای است که قدرت بینهایت محاسباتی را در کالبد الگوریتمهای خطی هوشمندانه به جریان درمیآورند.
بیشتر از هوش مصنوعی



