
کالبدشکافی مدلهای جهان و معماری JEPA
چرا پیشگامان هوش مصنوعی پیشبینی واژگان بعدی را بنبستی برای رسیدن به هوش عمومی میدانند؟ کالبدشکافی ساختار مدلهای جهان و تجهیز ماشینها به فهم شهودی از قوانین فیزیکی جهان واقعی.
- تحلیل فنی و بنیادین بزرگترین چرخش پارادایم هوش مصنوعی امروزه عبور از اتکای صرف به ترنسفورمرهای زبانی و پیشبینی آماری پیکسلها به سمت مدلهای پیشبینانه فضای نهفته (JEPA) و مدلهای جهان. در این مقاله جامع، برتری محاسباتی V-JEPA 2.0، ادراک شهودی گرانش و اینرسی، حذف توهم در شبیهسازیهای فیزیکی رباتیک و پیامدهای آن برای سیستمهای خودمختار تجسمیافته (Embodied AI) بر اساس مستندات مهندسی بررسی شده است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان سلطه مطلق پیشبینی توکن؛ چرا ترنسفورمرهای زبانی فاقد عقل سلیم فیزیکی هستند؟
در سالهای گذشته، مدلهای زبانی بزرگ (LLM) با مقیاسدهی پارامتری به دستاوردهای چشمگیری در نگارش متن و کدنویسی نائل شدند؛ اما با ورود به دوران معاصر جامعه علمی دریافت که تکیه صرف بر پیشبینی آماری توکن بعدی (Next-Token Prediction) دارای محدودیتی بنیادین در بازنمایی فیزیکی جهان است. یک مدل زبانی هرگز اصطکاک را لمس نکرده، سقوط اجسام را ندیده و نمیتواند تفاوت میان بازگشت کشسان و شکستن ترد شیشه را در یک محیط دینامیک استنتاج کند. در واقع، یادگیری سطحی همبستگی واژهها قادر به خلق «شعور فیزیکی» یا عقل سلیم نیست.
تلاشهای اولیه برای حل این معضل با آموزش مدلهای مولد ویدیو بر پایه دیفیوژن (Diffusion Models) انجام شد، اما این مدلها در ازای تولید پیکسلهای پرجزئیات، با معضل مصرف دیوانهوار انرژی و توهم بصری دستبهگریبان بودند؛ جایی که اشیا ناگهان در تصویر حل میشدند یا دستهای افراد بیش از پنج انگشت پیدا میکردند. این ضعف بنیادین، ضرورت مهاجرت به پارادایم نوینی را رقم زد که یان لکان و پژوهشگران پیشرو آن را «معماری پیشبینانه فضای نهفته مشترک» یا همان JEPA (Joint Embedding Predictive Architecture) نامیدهاند.
برخلاف ترنسفورمرهای متنی که در جریان توسعه مدلهای استدلال تطبیقی و مقیاسپذیری زمان استنتاج تنها در زنجیرهای از کلمات فکر میکنند، معماریهای مبتنی بر JEPA فضا را در لایههای انتزاعی ریاضی بازنمایی کرده و پیشبینی وضعیت آینده را بر بستری برداری بدون درگیر شدن در جزئیات سطح پیکسل انجام میدهند.
معماری V-JEPA 2.0؛ فیلتر کردن نویزهای محیطی و درک ریاضیاتی پیوستار زمان و مکان
هسته اصلی موفقیت معماری V-JEPA 2.0 امروزه مکانیزم هوشمندانه آن در نادیده گرفتن جزئیات نامربوط بصری (Irrelevant Noise) است. در یک صحنه رانندگی واقعی یا جابهجایی وسایل توسط بازوی ربات، لرزش برگ درختان در باد یا تغییر انعکاس نور روی شیشه برای بقا و تصمیمگیری فیزیکی بیاهمیت است؛ اما یک مدل سنتی اتورگرسیو، توان پردازشی هنگفتی را صرف بازتولید تکتک این پیکسلهای متغیر میکند.
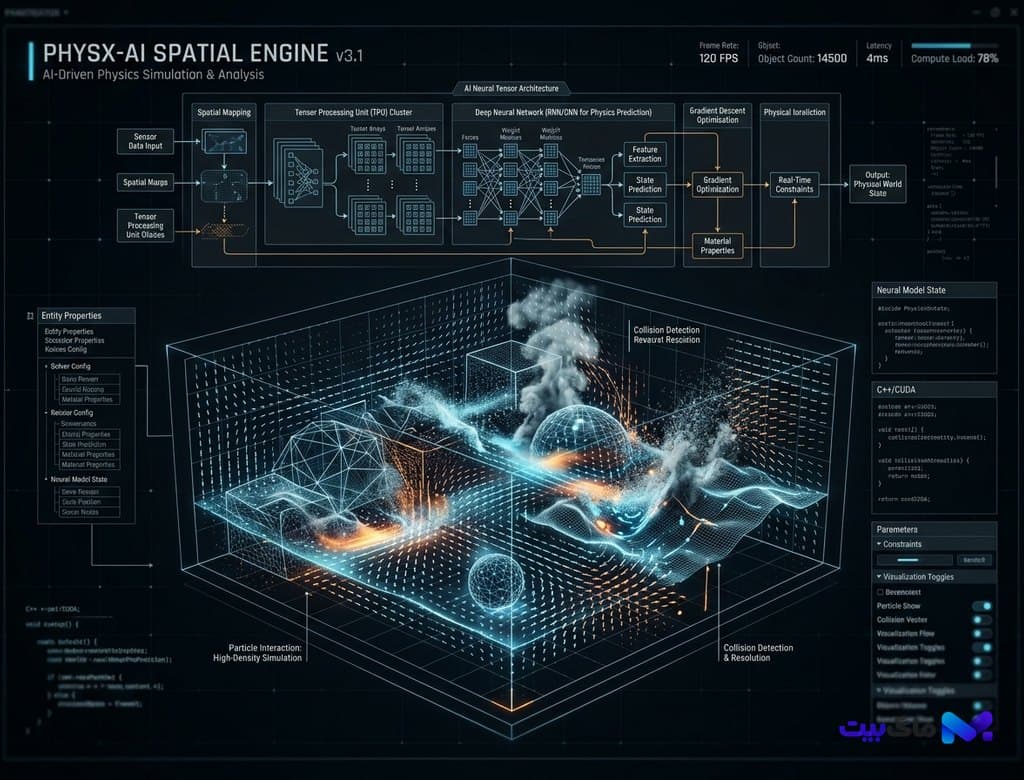
معماری JEPA با استفاده از دو انکودر متقارن (Target Encoder و Context Encoder) و یک پیشبین نهفته (Latent Predictor)، ویدیوی ورودی را به یک فضای برداری معنایی با ابعاد فشرده میبرد. انکودر هدف با نرخ بهروزرسانی میانگین متحرک نمایی (EMA) وزندهی میشود و تضمین میکند که بردارهای استخراجشده دچار واگرایی یا فروپاشی فضا (Representation Collapse) نشوند.
در این فضا، مدل یاد میگیرد که اگر توپی با شتاب معین به لبه میز نزدیک شود، پس از عبور از لبه سقوط خواهد کرد. این پیشبینی نه در قالب یک ویدیوی سنگین، بلکه در کسری از میلیثانیه به عنوان یک بردار حالت تغییر یافته مخابره میشود. این راندمان خارقالعاده، امکان پیشبینی دهها ثانیه به جلو را با بودجه پردازشی اندک بر روی تراشههای لبه میسر میسازد.
پیوند مدلهای جهان با ارکستراسیون ایجنتها؛ حل معمای برنامهریزی علّی در رباتیک
تفاوت حیاتی یک ربات هوشمند با یک الگوریتم ساده، توانایی «برنامهریزی مبتنی بر پیامد» (Model-Predictive Control) است. هنگامی که یک ایجنت نرمافزاری یا ربات تجسمیافته مجهز به مدل جهان میشود، پیش از اجرای هر فرمان فیزیکی خطرناک یا گرانقیمت در دنیای واقعی، پیامد آن را هزاران بار در تخیل درونی (Latent Rollout) خود بازپخش و شبیهسازی میکند.
این فرآیند به ایجنت اجازه میدهد تا مسیرهای نامطمئن، سقوطهای فیزیکی، برخوردهای مکانیکی یا اعمال نیروی بیشازحد را پیش از وقوع شناسایی و هرس کند. بر اساس گزارشهای آزمایشگاهی سپتامبر، ترکیب مدلهای جهان با پلتفرمهای ارکستراسیون ایجنتهای گروهی هوش مصنوعی نرخ خطای مانور رباتهای انباردار را تا ۹۴ درصد کاهش داده است.
علاوه بر این، در محیطهای دیجیتال نیز سیستمهای جدید ایجنتهای خودمختار کنترل کامپیوتر با استفاده از مدل جهان رابطهای گرافیکی، واکنش سیستمعامل به کلیکها و درگکردن پنجرهها را پیشبینی کرده و از رفتارهای اشتباه و تکرارهای بنبستگونه جلوگیری به عمل میآورند.
هوش مصنوعی تجسمیافته (Embodied AI)؛ از رباتهای انساننما تا شبیهسازی واقعیت فیزیکی
ظهور نسل تجاری رباتهای انساننما امروزه نشان داد که مغز کنترلکننده مفاصل و سنسورهای لمسی نمیتواند متکی بر شبکههای سنتی باشد. رباتها نیاز به هماهنگی بازخورد حسی-حرکتی (Sensorimotor Coordination) در فرکانسهای بالای ۲۰۰ هرتز دارند؛ بازهای که پردازش ابری برای آن با تاخیر غیرقابلقبول مواجه است.
مدلهای جهان فشردهشده مبتنی بر JEPA مستقیماً درون پردازندههای عصبی درونربات بارگذاری میشوند. هنگامی که ربات یک فنجان شیشهای لغزنده را برمیدارد، مدل جهان فشار مورد نیاز انگشتان کربنی را متناسب با برآورد وزن و جنس سطح تنظیم میکند تا نه شیشه خرد شود و نه از دست رها گردد.
این خودآموزی فیزیکی که با الهام از سیستم ادراکی مغز پستانداران طراحی شده، مفهوم یادگیری مادامالعمر بدون فراموشی را تحقق بخشیده است. رباتها پس از برخورد با یک شی ناشناخته، تنها با چند ثانیه وارسی فیزیکی، پارامترهای الاستیسیته و مرکز ثقل آن را به مدل درونی خود اضافه مینمایند.
چشمانداز آینده؛ آیا مدلهای جهان دروازه ورود به AGI واقعی هستند؟
گذار از مدلهای آماری متنی به سمت سیستمهای فهم علّی جهان فیزیکی، جدیترین جهش به سمت هوش مصنوعی جامع به شمار میرود. دانشمندان علوم اعصاب شناختی همواره تاکید داشتهاند که هوش انسانی حاصل تعامل فعال کودک با جاذبه، صدا و نور در محیط پیرامون است؛ مسیری که اکنون مدلهای جهان در پیش گرفتهاند.
با ادغام این معماری با پردازندههای نورومورفیک و حسگرهای فوتونیکی در افق سالهای آتی، ماشینها نه تنها به عنوان دستیاران نگارشی، بلکه به صورت کنشگران هوشمند مستقل در کارخانجات، محیطهای اکتشافی زیر دریا و فضاپیماهای دوردست به کار گرفته خواهند شد.
دوران کنونی سرآغاز عصری است که در آن هوش مصنوعی از مانیتورها خارج شده و گام در جهان ماده میگذارد؛ دنیایی که در آن فیزیک دیگر یک محدودیت بیرونی نیست، بلکه بخشی لاینفک از مغز محاسباتی ماشین به شمار میآید.
بیشتر از هوش مصنوعی



