
راهنمای استدلال تطبیقی و محاسبات زمان استنتاج
پایان دوره پاسخهای شتابزده هوش مصنوعی؛ چگونه سیستمهای استدلالگر با تخصیص زمان بیشتر برای اندیشیدن و جستجوی شاخههای مختلف پیش از پاسخ، مسائل غیرممکن محاسباتی را حل میکنند.
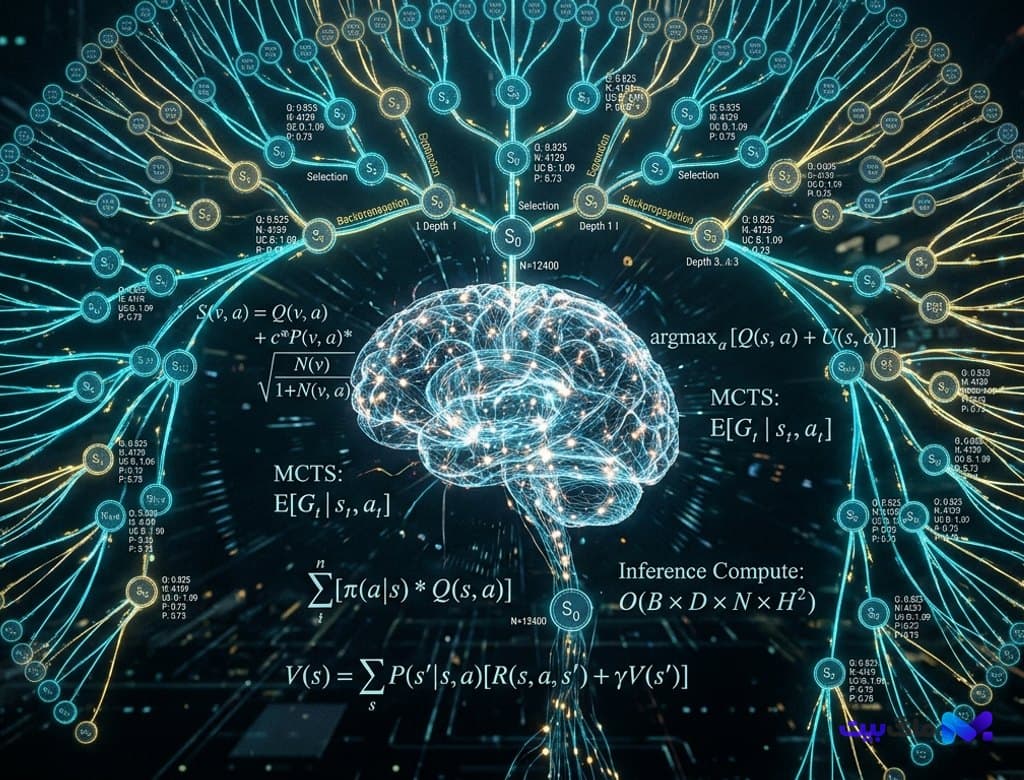
- تحلیل عمیق و تخصصی تحول پارادایم هوش مصنوعی امروزه عبور از قانون مقیاس پیشآموزش (Pre-training Scaling Law) و ظهور قانون مقیاس استنتاج (Test-Time Scaling Law). در این مقاله جامع، نحوه تخصیص پویای بودجه محاسباتی (Dynamic Compute Budget)، تفکر زنجیرهای تطبیقی، الگوریتمهای جستجوی درخت مونتکارلو (Monte Carlo Tree Search) در مدلهای استدلالگر، مدلهای ارزیاب فرآیند (Process Reward Models - PRM) و نحوه حل مسائل پیچیده در المپیادها و مهندسی سیستمها مورد واکاوی قرار گرفته است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
اشباع پیشآموزش و طلوع عصر مقیاسپذیری زمان استنتاج (Test-Time Scaling Laws)
تا نیمه نخست دهه جاری، قانون چیتچیلا و فرضیه مقیاسپذیری پیشآموزش حاکم مطلق صنعت هوش مصنوعی بود: هرچه پارامترهای مدل بزرگتر و حجم دادههای متنی وب وسیعتر میشد، عملکرد مدلها نیز به شکل لگاریتمی بهبود مییافت. با این حال، امروزه جامعه مهندسی با دو مانع فیزیکی سهمگین مواجه شد: ته کشیدن دادههای باکیفیت متنی دستنخورده بشری در اینترنت و هزینههای نجومی خوشههای دههزار پردازندهای که برای تمرین مدلهای نسل جدید نیاز به نیروگاههای اختصاصی داشتند.
این بنبست تاریخی نقطه آغاز پارادایم نوین «قانون مقیاس زمان استنتاج» (Test-Time Compute Scaling Law) شد. به جای آنکه تمامی هوش و دانش سیستم در وزنهای یخزده دوران پیشآموزش منجمد گردد، بخشی حیاتی از منابع پردازشی به لحظه دریافت سوال اختصاص مییابد. همانطور که در بررسی تخصصی کالبدشکافی تفکر زنجیرهای در مدلهای استدلالگر تشریح کردیم، سیستمهای مبتنی بر این رویکرد قادرند برای یک سوال دشوار ریاضی یا یک باگ امنیتی پیچیده، به جای تولید فوری کلمات، تا چندین دقیقه به کاوش و شبیهسازی سناریوهای گوناگون بپردازند.
نتیجه این تغییر مسیر بنیادین، دستیابی مدلهای سبکتر ۳۰ تا ۷۰ میلیارد پارامتری به نتایجی فراتر از غولهای ۶۰۰ میلیارد پارامتری سنتی در بنچمارکهای استدلالی سنگین بوده است.
کالبدشکافی تفکر زنجیرهای تطبیقی و بودجهبندی پویا (Dynamic Thinking Budgets)
یکی از نوآوریهای تعیینکننده امروزه توسعه مکانیزمهای «بودجهبندی پویای تفکر» (Dynamic Thinking Budgets) است. در نسلهای ابتدایی مدلهای استدلالگر، سیستم برای یک احوالپرسی ساده یا یک سوال تاریخی کوتاه نیز همانند حل مسائل هندسه تحلیلی، زنجیرهای طولانی از توکنهای پنهان تفکر تولید میکرد که به اتلاف شدید توان محاسباتی و تاخیر ناخوشایند میانجامید.
مدلهای نوین با بهرهگیری از یک شبکه ارزیاب دشواری مسئله (Complexity Estimator)، پیش از ورود به فاز تولید توکن، برآورد میکنند که پاسخ نیازمند چند ثانیه پردازش و چه عمقی از کاوش منطقی است. برای نمونه، در حالی که یک سوال متداول با بودجه ۱۰۰ توکنی تفکر حل میشود، تحلیل یک سناریوی تجاری پیچیده در نسل نوین GraphRAG و گرافهای دانش سازمانی میتواند تا ۱۰ هزار توکن استدلال درونی را فعال سازد.
این تطبیقپذیری هوشمندانه نه تنها مصرف انرژی دیتاسنترها را تا ۶۰ درصد بهینهسازی کرده، بلکه تجربه تعامل کاربر انسانی را از حالت کند و یکنواخت به یک ارتباط زنده و انعطافپذیر بدل ساخته است.
مهندسی جستجوی چندمسیره؛ ترکیب مونتکارلو (MCTS) و مدلهای پاداش فرآیندمحور (PRM)
راز پیروزی سیستمهای مدرن در المپیادهای ریاضی و رقابتهای الگوریتمی بینالمللی، مهاجرت از رمزگشایی خطی چپبهراست (Beam Search) به الگوریتمهای پیشرفته جستجوی درخت مونتکارلو (Monte Carlo Tree Search) در فضای مفهومی است. مدل استدلالگر هنگام مواجهه با یک گره منطقی دشوار، مسیرهای متعددی را در قالب شاخههای درختی ایجاد میکند.
اینجاست که نقش حیاتی «مدلهای پاداش فرآیندمحور» (Process Reward Models - PRM) نمایان میشود. برخلاف مدلهای قدیمی Outcome Reward که تنها درست یا غلط بودن پاسخ نهایی را بررسی میکردند، PRM صحت تکتک گامهای منطقی، فرضها و محاسبات میانی را ارزیابی میکند. در صورتی که یک گام فرعی به تناقض یا بنبست برسد، الگوریتم بلافاصله آن شاخه را هرس کرده و وزن پردازشی را به شاخههای با پتانسیل بالاتر هدایت مینماید.
این فرآیند شباهت خیرهکنندهای به بازی شطرنج در سطح استادان بزرگ دارد؛ جایی که مغز محاسباتی مدل، دهها حرکت جلوتر را در کسری از ثانیه شبیهسازی کرده و پس از غربال کامل مسیرهای اشتباه، مطمئنترین استراتژی را در قالب متن خروجی ارائه میدهد.
خوداصلاحی بازگشتی (Self-Correction) و حذف خطاهای توهم در مهندسی نرمافزار
بزرگترین آفت هوش مصنوعی در سالهای گذشته، پدیده توهم (Hallucination) و اطمینان کاذب مدلها در ارائه پاسخهای کاملاً نادرست بود. محاسبات زمان استنتاج با مسلح کردن مدلها به حلقه بازخورد و خوداصلاحی بازگشتی (Reflective Self-Correction)، این معضل کهنه را ریشهکن کرده است.
هنگامی که مدل کدی برای یک معماری توزیعشده یا یک قرارداد هوشمند مالی تولید میکند، در محیط سندباکس درونی خود اقدام به نوشتن تستهای مرزی (Edge Cases) و ارزیابی رفتار کد مینماید. همانطور که در واکاوی انقلاب ایجنتهای هوش مصنوعی کنترل کامپیوتر شاهد بودیم، عامل خودمختار تا زمانی که خطای اجرایی دریافت کند، استدلال خود را بازنویسی کرده و اصلاحیه منتشر میکند.
این چرخه خودارزیابی باعث شده است تا نرخ خطاهای منطقی در کدهای تولیدشده توسط مدلهای استدلالگر دوران کنونی از ۲۸ درصد در مدلهای سالهای گذشته به کمتر از ۱.۲ درصد سقوط کند.
افقهای پیش رو؛ تکامل چیپهای شتابدهنده و هوش مصنوعی استنتاجمحور
انتقال ثقل محاسبات از پیشآموزش به زمان استنتاج، ساختار سختافزاری ابررایانهها را نیز متحول ساخته است. تقاضا برای پهنای باند حافظه (HBM3e و HBM4) و معماریهای نوین تبادل داده نظیر معماری حافظههای اشتراکی CXL و شتابدهندههای دیتاسنتر چند برابر شده است؛ چرا که نگهداری هزاران درخت جستجو نیازمند حافظههای به شدت متراکم و کمتاخیر است.
با ادغام این استدلال عمیق با دانشمندان هوش مصنوعی خودمختار و آزمایشگاههای خودران، ما شاهد عصری هستیم که هوش مصنوعی نه تنها متون را خلاصه میکند، بلکه در نقش یک فیزیکدان نظری یا ریاضیدان تراز اول، فرضیههای چندماهه را در عرض چند ساعت استدلال ریاضی تحلیل و اثبات مینماید.
دوران معاصر نقطه عطف بلوغ تفکر ماشینی است؛ سالی که در آن هوش مصنوعی از یک طوطی سخنگوی آماری، به موجودیتی با درک منطقی، توان بازنگری در افکار و مهارت حل عمیقترین چالشهای تمدن بشری ارتقا یافته است.
بیشتر از هوش مصنوعی



