
راهنمای معماری GraphRAG و گرافهای دانش سازمانی
چرا جستجوی برداری ساده دیگر پاسخگوی هوش مصنوعی سازمانی نیست؟ چگونه GraphRAG با درک روابط و بافتار چندگانه اسناد، توهم مدلهای زبانی را به صفر نزدیک میکند.
- کالبدشکافی فنی نسل جدید سامانههای بازیابی تقویتشده با گراف (Graph-Augmented Generation) امروزه عبور از محدودیتهای سیستمهای سنتی برداری (Vector RAG) از طریق پیوند زدن امبدینگهای معنایی با نمودارهای دانش ساختاریافته (Knowledge Graphs). این مقاله معماری استخراج خودکار موجودیتها و روابط، ساخت گرافهای دانش پویا، خوشهبندی سلسلهمراتبی لیدن (Leiden) و بازیابی چندمرحلهای برای سامانههای پیچیده مالی، حقوقی و پزشکی را به تصویر میکشد.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
تنگناهای بنیادین RAG برداری سنتی و شکست در درک کلیت اسناد سازمانی
در سالهای اولیه پیادهسازی سیستمهای Retrieval-Augmented Generation (RAG)، شرکتها به راهکاری ساده متکی بودند: تقسیم متون اسناد به قطعات کوچک چندصد کلمهای (Chunking)، تبدیل آنها به بردار با مدلهای امبدینگ و جستجوی نزدیکترین همسایهها بر اساس شباهت کسینوسی در یک پایگاه داده برداری. اگرچه این رویکرد برای پاسخ به پرسشهای موضعی نظیر «ماده ۵ قرارداد فلان چیست؟» کارآمد بود، اما هنگام مواجهه با سوالات انتزاعی یا تحلیلی کلان با شکست فاجعهبار مواجه میشد.
پرسشهایی مانند «مهمترین عوامل ریسک مالی شرکت در سه سال گذشته چه روندی داشته است؟» یا «روابط غیرمستقیم میان شرکتهای تابعه و مشتریان چیست؟» را نمیتوان با پیدا کردن ۵ قطعه متن جداگانه پاسخ داد؛ چرا که این تحلیلها نیازمند درک روابط فرامتنی، ارتباط میان چندین سند نامتجانس و استنتاج بر پایه ساختار کلی دادهها هستند.
این ناتوانی ساختاری سبب شد تا سیستمهای سنتی در درک بافتار کلان اسناد دچار توهم شوند یا بخشهای حیاتی اطلاعات را در فرآیند رتبهبندی برداری نادیده بگیرند.
کالبدشکافی خط لوله GraphRAG؛ از استخراج خودکار موجودیتها تا خوشهبندی سلسلهمراتبی لیدن
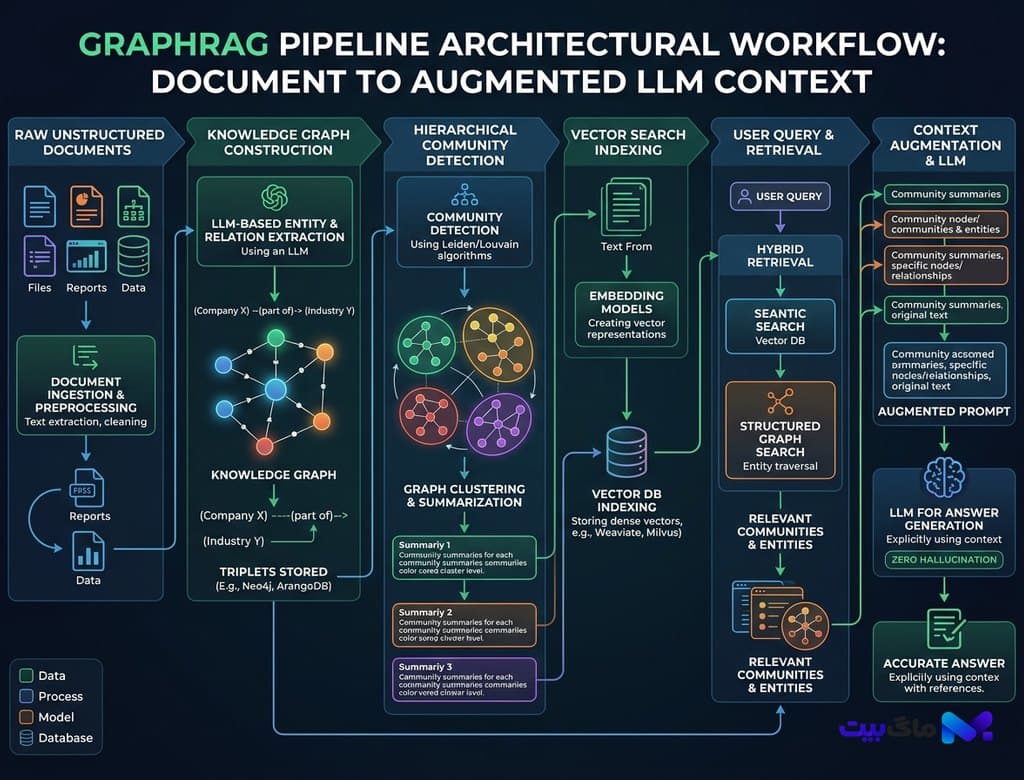
راهکار انقلابی GraphRAG با تلفیق مدلهای زبانی بزرگ و تئوری گراف، این نقص ذاتی را برطرف ساخته است. در فاز نمایهسازی (Indexing)، مدل زبانی تمامی اسناد را اسکن کرده و به صورت خودکار موجودیتها (افراد، سازمانها، قوانین، محصولات و داراییها) و روابط میان آنها را همراه با توضیحات زمینهای استخراج میکند و یک گراف دانش (Knowledge Graph) غنی از فکتهای اثباتشده میسازد.
در گام بعدی، با استفاده از الگوریتم پیشرفته خوشهبندی لیدن (Leiden Community Detection)، گراف بزرگ به جوامع و زیرشاخههای موضوعی سلسلهمراتبی در سطوح مختلف انتزاع تقسیم میشود. مدل زبانی برای هر جامعه گرافی، یک گزارش تحلیلی جامع و ساختاریافته تولید میکند که خلاصه فشردهای از تمامی رویدادها و پیوندهای آن حوزه است.
هنگامی که کاربر سوالی جامع مطرح میکند، سیستم به جای جستجوی مستقیم در میان میلیونها قطعه متن خام، به سراغ خلاصههای این جوامع گرافی رفته و تصویری همهجانبه، معتبر و بدون تحریف از موضوع ترسیم مینماید.
همگرایی پایگاههای داده چندمدلی؛ پیوند یکپارچه وکتور استورها و موتورهای گرافی نوین
پشتیبانی از این حجم عظیم ارتباطات نیازمند زیرساختهای پایگاه داده نوین امروزه بوده است. دوران استقرار جداگانه یک دیتابیس برداری نظیر Milvus یا Qdrant در کنار یک پایگاه داده گرافی مستقل نظیر Neo4j رو به پایان است؛ زیرا جابجایی داده میان این دو موتور باعث تاخیر شبکه و پیچیدگیهای هماهنگسازی نگهداری (ACID) میشد.
پایگاههای داده هیبریدی نسل جدید با تلفیق ایندکسهای گرافی بومی و بردارهای فضایی در یک موتور ذخیرهسازی یکپارچه، امکان اجرای پرسوجوهای پیچیده ترکیبی را فراهم کردهاند. همانطور که در واکاوی مهاجرت تاریخی به زبان راست و سیستمهای با عملکرد بالا تشریح کردیم، این موتورها با تکیه بر مدیریت حافظه بدون بار اضافی، زمان پاسخدهی به پرسمانهای گرافی با عمق ۴ لایه پیوند را به کمتر از ۳۰ میلیثانیه رساندهاند.
این همگرایی به توسعهدهندگان اجازه میدهد تا با یک دستور واحد، هم بر اساس شباهت معنایی بردارها فیلتر کنند و هم محدودیتهای سلسلهمراتبی گرافی را به طور همزمان اعمال نمایند.
سناریوهای استقرار در محیطهای سازمانی؛ از تحلیلهای حقوقی تا داروسازی محاسباتی
کاربردهای عملیاتی GraphRAG امروزه مرزهای صنایع مختلف را دگرگون ساخته است. در نهادهای مالی و بازرسیهای قضایی، این سیستم قادر است شبکههای پنهان پولشویی، شرکتهای صوری و تراکنشهای ضربدری میان صدها نهاد حقوقی را که در میان دهها هزار صفحه گزارش حسابرسی پنهان مانده بود، با شفافیت مطلق شناسایی کند.
در صنایع بیودارویی، همانطور که در بررسی کشف داروها و آزمایشگاههای خودران بیوتکنولوژی مطرح شد، پیوند مقالات علمی با مسیرهای متابولیک و برهمکنشهای پروتئینی از طریق گرافهای دانش، به پژوهشگران اجازه میدهد تا اثرات جانبی پیشبینینشده ترکیبات دارویی جدید را ماهها پیش از ورود به فاز آزمایش بالینی کشف نمایند.
در محیطهای حقوقی نیز وکلا میتوانند تناقضات میان احکام قضایی صادرشده در دادگاههای گوناگون را با نقشهبرداری از استدلالهای حقوقی در کسری از ثانیه ردیابی و استناد کنند.
نقشه راه پیادهسازی و ابزارهای پیشرو؛ چگونه زیرساخت داده سازمان را برای GraphRAG آماده کنیم؟
برای پیادهسازی موفق یک اکوسیستم GraphRAG امروزه معماران سیستم باید کار را با استانداردسازی آنتولوژی (Ontology) دادههای سازمان آغاز کنند. استفاده از چارچوبهای متنباز پیشرفته مانند Microsoft GraphRAG 2.0، LlamaIndex Knowledge Graph و LangChain Graph Agents، مسیر استخراج خودکار و تزریق داده را تا حد زیادی هموار ساخته است.
مدیریت هزینههای توکن در هنگام ساخت اولیه گراف همچنان عاملی تعیینکننده است؛ بنابراین استفاده از مدلهای کوچکتر اختصاصی برای وظیفه استخراج موجودیتها و واگذاری فرآیند ترکیب نهایی به مدلهای استدلالگر پیشرفته نظیر آنچه در انقلاب استدلال تطبیقی و مقیاسپذیری محاسبات زمان استنتاج بررسی کردیم، استراتژی بهینهای است.
GraphRAG دیگر یک آزمایش تحقیقاتی نیست، بلکه ستون فقرات حاکمیت داده و هوش تجاری پایدار سازمانهای پیشرو امروزه به شمار میرود.
بیشتر از فناوری



