
معماری مامبا ۲ و مدلهای ترکیبی SSM
پایان سلطه انحصاری مکانیزم توجه درجه دو؛ معماری مامبا ۲ با استنتاج زمانی خطی و حافظه وضعیت ثابت، پردازش اسناد میلیون توکنی را با یکپنجم حافظه ممکن کرده است.
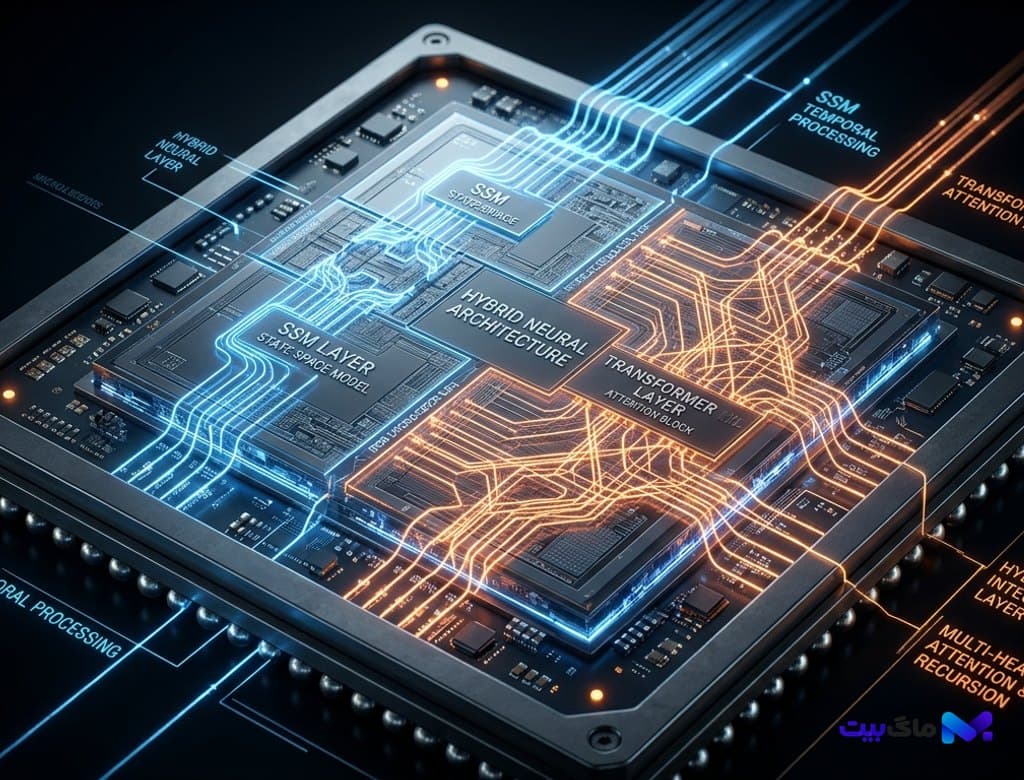
- واکاوی جامع و فنی جهش معماری Mamba-2 و مدلهای ترکیبی فضای حالت (SSM-Transformer) امروزه و چگونگی حل بحران گلوگاه حافظه کش KV در هوش مصنوعی. بررسی ریاضیات دوگانگی فضای حالت (SSD)، پردازش متون در مقیاس میلیون توکن با استنتاج خطی O(N)، کاهش ۸۰ درصدی مصرف حافظه ویدیویی VRAM در مراکز داده، و ادغام لایههای توجه گزینشی در مدلهای هیبریدی نوین نظیر Jamba و Nemotron. تحلیل کاربرد این دستاورد در استقرار مدلهای قدرتمند روی دستگاههای محلی، تحلیل طولانی اسناد حقوقی و کدنویسی خودکار در پروژههای عظیم نرمافزاری.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
مقدمه و بررسی اولیه
بحران مقیاسپذیری ترنسفورمرها؛ انفجار حافظه KV-Cache در متون طولانی
از زمان معرفی معماری ترنسفورمر در سال ۲۰۱۷، مکانیزم خودتوجهی (Self-Attention) پادشاه بلامنازع پردازش زبان طبیعی و مدلهای زبانی بزرگ بوده است. با این حال، ترنسفورمرها با یک محدودیت فیزیکی بنیادین دستبهگریبان هستند: پیچیدگی محاسباتی و مصرف حافظه این مکانیزم با افزایش طول متن به صورت درجه دو (O(N^2)) رشد میکند. در حین استنتاج، مدل ناچار است مقادیر کلید و مقدار (KV-Cache) تمامی توکنهای پیشین را در حافظه فوقسریع VRAM پردازندههای گرافیکی ذخیره کند. این گلوگاه سبب میشود که پردازش یک زمینه یک میلیون توکنی به دهها گیگابایت حافظه مستقل از وزنهای مدل نیاز داشته باشد و هزینههای ابری را به سطوحی سرسامآور برساند.
همانگونه که در کالبدشکافی انقلاب هوش مصنوعی نوروسیمبولیک و اثبات صوری Lean 4 اشاره شد، سیستمهای هوشمند امروزی برای استدلال دقیق نیازمند مرور کل تاریخچه تعاملات، اسناد تحلیلی چندصد صفحهای و تمامی مخازن کد هستند. امروزه اتکا به ترنسفورمرهای خالص برای پردازش چنین ابعادی از داده از نظر اقتصادی و حرارتی توجیهناپذیر شده است. این بنبست تاریخی، مسیر را برای شکوفایی نسل دوم مدلهای فضای حالت هموار ساخت.
مدلهای فضای حالت ساختاریافته (Structured State Space Models) با الهام از سیستمهای کنترل کلاسیک، امکان فشردهسازی جریان بیپایان داده به یک وضعیت پنهان با ابعاد ثابت را فراهم میآورند. در این چارچوب، استنتاج به صورت بازگشتی با پیچیدگی خطی O(N) و زمان ثابت O(1) به ازای هر توکن جدید انجام میگیرد؛ پیشرفتی شگرف که امکان نگهداری نامحدود اطلاعات پیشین بدون نیاز به بزرگتر کردن حافظه سختافزاری را به ارمغان آورده است.
دوگانگی فضای حالت (SSD) و ریاضیات حاکم بر Mamba-2
پیشرفت شگفتانگیز دوران کنونی با رونمایی از چارچوب نظری «دوگانگی فضای حالت» (State Space Duality یا SSD) در معماری Mamba-2 رقم خورد. محققان برجسته ثابت کردند که مدلهای فضای حالت گزینشی و مکانیزمهای توجه خطی در واقع دو روی یک سکه ریاضیاتی هستند. این کشف نظری اجازه داد تا الگوریتمهای آموزش Mamba-2 به گونهای بازطراحی شوند که بتوانند به طور کامل از واحدهای ضرب ماتریسی تانسور (Tensor Cores) در مدرنترین شتابدهندههای هوش مصنوعی بهرهبرداری کنند.
برخلاف نسخه اولیه مامبا که به عملیات اسکن متوالی حساس بود، Mamba-2 ماتریسهای تبدیل وضعیت را به شکل بلوکهای نیمهجداشونده فرمولبندی میکند. این رویکرد سرعت آموزش مدل را تا ۸ برابر افزایش داده و امکان آموزش مدلهای بسیار بزرگ با بیش از ۷۰ میلیارد پارامتر را در کلاسترهای استاندارد فراهم کرده است. مدل بدون افت دقت در یادآوری اطلاعات دوردست (Needle In A Haystack)، وضعیت حافظه را به صورت پویا متناسب با اهمیت کلمات بازنشانی یا بازنویسی میکند.
مدلهای ترکیبی هیبریدی (SSM-Attention)؛ بهترینهای دو جهان
اگرچه مدلهای خالص SSM در استدلال پیوسته و پردازش متون طویل شاهکار میکنند، اما در مسائلی نظیر بازیابی دقیق کپی-پیست (Associative Recall) و مقایسه نقطهبهنقطه دو گزاره دور از هم، ترنسفورمرهای استاندارد همچنان نقاط قوت بیبدیلی دارند. به همین دلیل، امروزه صنعت هوش مصنوعی به سمت طراحیهای هیبریدی هوشمندانه همگرا شده است؛ الگوهایی پیشگام نظیر معماری Jamba و خانواده مدلهای هیبریدی متنباز.
در این معماریهای نوین، به ازای هر ۶ الی ۸ لایه سبک و سریع Mamba-2، تنها یک لایه توجه ترنسفورمر به کار گرفته میشود. لایههای مامبا ۹۰ درصد پردازش توکنها و فشردهسازی زمینههای متنی سنگین را با هزینه محاسباتی ناچیز بر دوش میکشند و لایههای گهگاهی توجه، ارتباطات دقیق بینمفاهیمی را قفل میکنند. این فرمولاسیون سبب شده حجم حافظه کش KV تا بیش از ۸۵ درصد کاهش یابد، در حالی که نمرات بنچمارک در استدلال منطقی و حل مسئله، ترنسفورمرهای غولپیکر سنتی را پشت سر گذاشته است.
شتابدهی استنتاج در لبه و خداحافظی با کلاسترهای گرانقیمت GPU
اثر ملموس این تحول معماری در کاهش هزینههای پردازش ابری و جهش پردازش محلی متجلی شده است. در حالی که میزبانی یک مدل ترنسفورمر با طول زمینه ۱۲۸ هزار توکن نیازمند سرورهای چندصدهزار دلاری با چندین کارت حافظه HBM3e بود، مدلهای هیبریدی Mamba-2 با همین طول زمینه به راحتی بر روی یک ایستگاه کاری منفرد یا مینیسرورهای پرچمدار اجرا میشوند. این امر مستقیماً استقرار سرورهای خانگی هوش مصنوعی و خودمیزبانی ابری را وارد عصر طلایی کرده است.
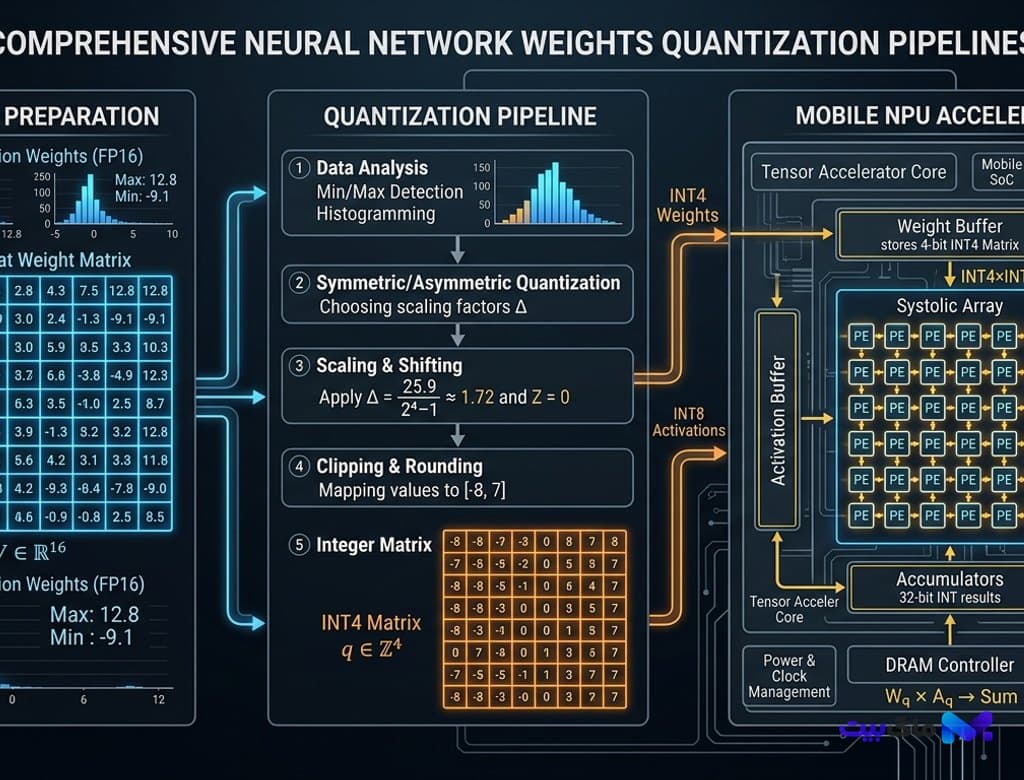
علاوه بر این، همانگونه که در بررسی مدلهای زبانی کوچک تخصصی (SLM) و کوانتیزاسیون زیر ۲ بیتی تشریح شد، ترکیب مامبا با کوانتیزاسیون مدرن، مصرف حافظه را به قدری بهینه کرده که مدلهای استدلالگر پیشرفته اکنون روی NPU لپتاپها و حتی گوشیهای هوشمند بدون افت محسوس سرعت تولید توکن اجرا میشوند. دیگر نیازی نیست برای هر کلمه تولیدی، کل حافظه پنهان گذشته دوباره از رم خوانده شود؛ مدل تنها وضعیت ثابت فعلی را بهروزرسانی میکند.
دگرگونی پنجرههای پردازش میلیونی و آینده مدلهای چندوجهی
با عبور از محدودیتهای درجه دو، امروزه شاهد ورود مدلهایی با پنجره زمینه فراتر از ۱۰ میلیون توکن هستیم؛ پدیدهای که پردازش یکپارچه یک کتابخانه کامل، ساعتها ویدیوی رزولوشن بالا و لاگهای یکساله سیستمهای سازمانی را در یک فراخوانی ممکن ساخته است. در پردازش ویدیو و صوت که دادهها ماهیتاً پیوسته و با نرخ نمونهبرداری بالا هستند، Mamba-2 به دلیل ماهیت بازگشتی ذاتی سیستمهای پیوسته، عملکردی شبیه به ادراک حسی طبیعی انسان ارائه میدهد.
دوران کنونی بدون تردید نقطه عطفی در تاریخ مهندسی هوش مصنوعی است. گذار از خودتوجهی پرهزینه به سمت سیستمهای دوگانه حالت، نشان داد که ارتقای هوش لزوماً در گرو سوزاندن مگاواتهای بیپایان برق و انباشت تراشههای حافظه نیست، بلکه نبوغ ریاضیاتی و معماری الگوریتمی میتواند مرزهای مقیاسپذیری محاسبات هوشمند را تا افقهایی بیکران گسترش دهد.
بیشتر از هوش مصنوعی



