
مدلهای زبانی کوچک تخصصی و NPUهای نسل ۴
پایان وابستگی به کلاسترهای ابری غولپیکر؛ مدلهای زبانی کوچک دوران کنونی با معماری کوانتیزاسیون ترنری و پردازندههای عصبی محلی، هوش استنتاجی سریع و خصوصی را مستقیماً به جیب شما میآورند.
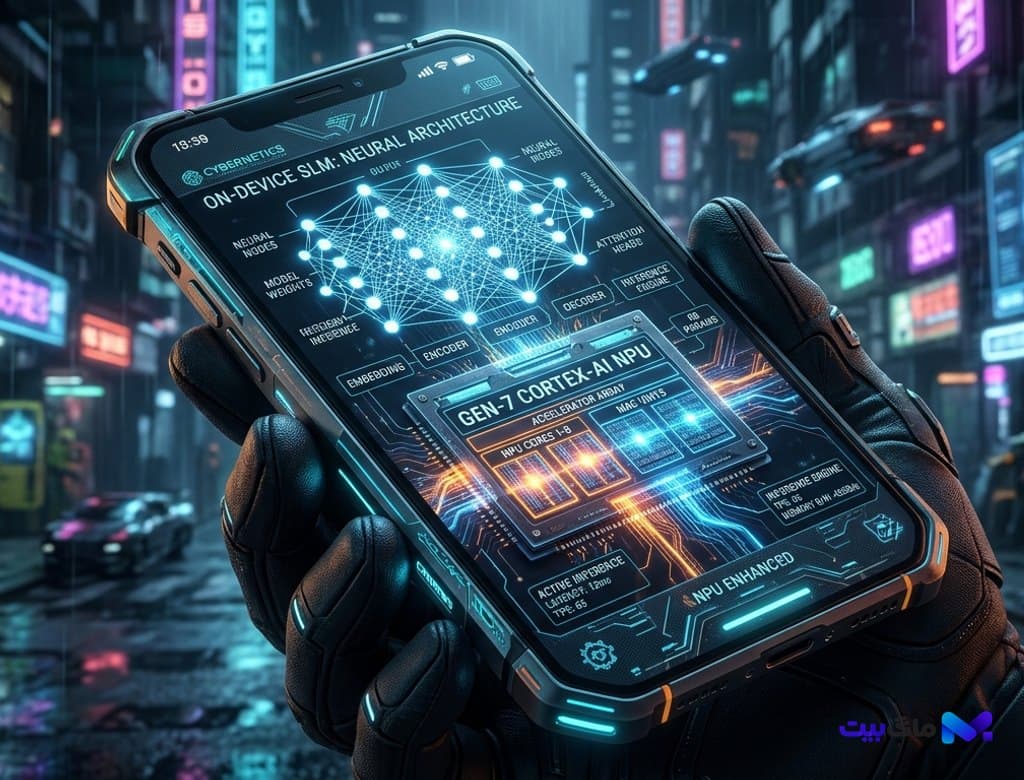
- تحلیل جامع و موشکافانه تکامل چشمگیر مدلهای زبانی کوچک تخصصی (SLM) و استقرار بومی آنها روی پردازندههای عصبی نسل چهارم (NPU) امروزه. کالبدشکافی تکنیکهای انقلابی فشردهسازی و کوانتیزاسیون زیر ۲ بیتی (Sub-2-bit و 1.58-bit Ternary LLMs)، کاهش ردپای حافظه مدلهای ۵ الی ۸ میلیارد پارامتری به کمتر از ۲ گیگابایت رم، دستیابی به سرعت پردازش بیش از ۶۰ توکن بر ثانیه روی تراشههای کممصرف ۵ واتی، استقلال مطلق از اینترنت و سرورهای ابری جهت تضمین حریم خصوصی دادههای محرمانه، و تحلیل بازتعریف تجربه کاربری در گوشیهای هوشمند، لپتاپهای هوش مصنوعی و رباتهای لبه.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
مقدمه و بررسی اولیه
افول انحصار ابر و صعود پارادایم هوش مصنوعی بومی آفلاین
برای چندین سال متوالی، رویکرد غالب غولهای فناوری ارسال بیقیدوشرط تمامی دادههای متنی، صوتی و تصویری کاربران به کلاسترهای ابری چندصدهزار دلاری بود. اما تا دوران معاصر این الگوی متمرکز با سه بحران راهبردی برخورد کرد: هزینههای سرسامآور پهنای باند و برق مراکز داده، تأخیر غیرقابل قبول شبکههای مخابراتی در پردازش تعاملات بلادرنگ، و هشدارهای فزاینده نهادهای امنیتی در خصوص نقض حریم خصوصی کاربران. کاربران و شرکتهای صنعتی دیگر تمایلی نداشتند اسناد مالی محرمانه یا کدهای منبع تجاری خود را به سرورهای ثالث ارسال کنند.
همانطور که در واکاوی انقلاب استدلال در زمان استنتاج (Test-Time Compute) تشریح کردیم، بهرهوری هوش مصنوعی دیگر لزوماً به معنای تزریق کورکورانه تریلیونها پارامتر به مدلهای غولپیکر نیست، بلکه به ظرافت معماری شناختی و تخصص در وظیفه خاص بستگی دارد. دوران کنونی نقطه عطف بلوغ مدلهای زبانی کوچک تخصصی (SLMs) با مقیاس ۲ الی ۷ میلیارد پارامتر است؛ مدلهایی که به لطف پالایش دادههای مصنوعی باکیفیت و تقطیر دانش (Knowledge Distillation)، در وظایفی چون ویرایش متن، استخراج مفاهیم، ترجمه تخصصی و کدنویسی ساختاریافته، پابهپای پرچمداران ابری رقابت میکنند.
این گذار بنیادین با ظهور پردازندههای عصبی یکپارچه نسل چهارم (NPU v4) با توان محاسباتی فراتر از ۵۰ تاپس (TOPS) در تراشههای استاندارد موبایل و رایانههای شخصی همراه شده است. اکنون یک کاربر در یک نقطه کور مخابراتی یا در حین پرواز بر فراز اقیانوس، میتواند مکالمات پیوسته، تحلیل دادهها و خلاصهسازی مدارک هزارصفحهای را با سرعت و کیفیتی خیرهکننده و با امنیت صددرصدی به سرانجام برساند.
معجزه کوانتیزاسیون ۱.۵۸ بیتی؛ ریاضیات ترنری و حذف ضربهای پرمصرف ممیز شناور
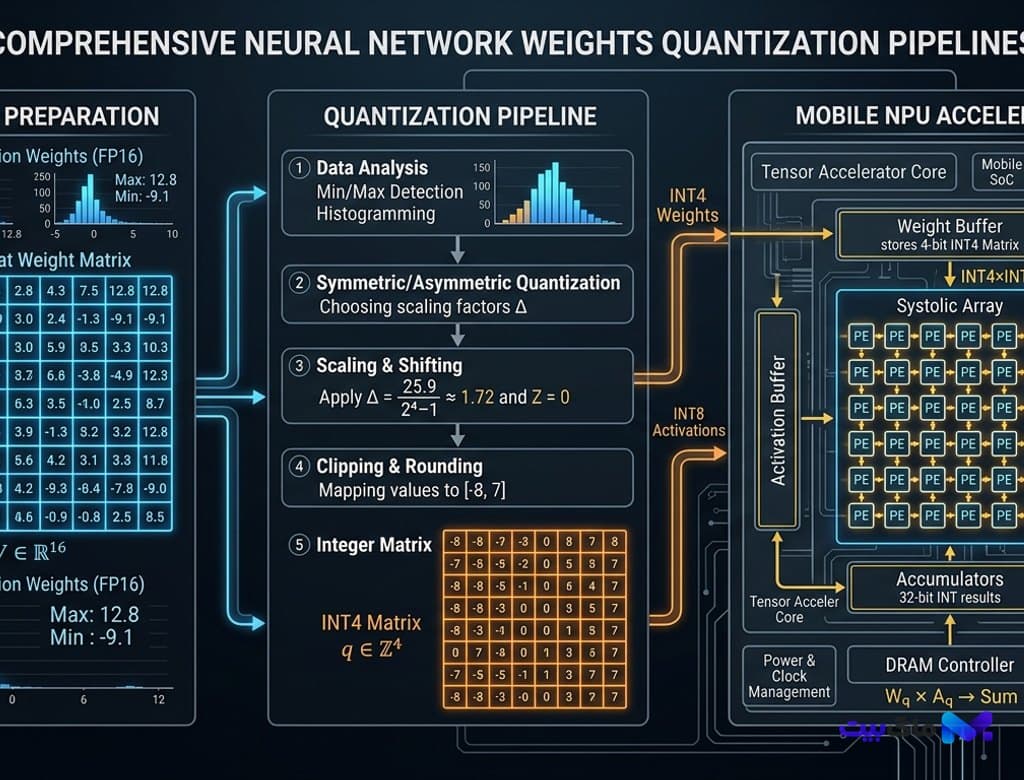
بزرگترین مانع پیشین در اجرای محلی مدلهای زبانی، محدودیت فیزیکی حافظه رم (DRAM Bandwidth) در گوشیها و تبلتها بود. یک مدل استاندارد ۷ میلیارد پارامتری در فرمت FP16 نیازمند حداقل ۱۴ گیگابایت حافظه اختصاصی بود که با احتساب بافر زمینه (KV Cache)، رم دستگاه را به طور کامل اشغال میکرد. اما پیشرفتهای انقلابی دوران معاصر در زمینه کوانتیزاسیون فوقپایین، این بنبست مهندسی را در هم شکست.
پیشگام این عرصه، معماری شبکههای ترنری موسوم به BitNet b1.58 است که امروزه به بلوغ تجاری رسیده است. در این شیوه شگفتانگیز، مقادیر اوزان شبکه به جای نگهداری در فرمتهای ۱۶ بیتی یا ۸ بیتی، تنها با سه مقدار مجاز {-۱, ۰, +۱} کدگذاری میشوند. از دیدگاه ریاضی، هنگامی که اوزان تنها این سه مقدار را بپذیرند، عمل سنگین ضرب تانسوری ماتریسی (Matrix Multiplication) به طور کامل حذف شده و جای خود را به جمع و تفریق ساده اعداد صحیح (Addition/Subtraction) میدهد.
این جهش نظری، مصرف انرژی محاسبات را تا ۹۰ درصد کاهش داده و حجم فایل مدل ۷ میلیارد پارامتری را از ۱۴ گیگابایت به کمتر از ۱.۸ گیگابایت تقلیل داده است. تراشههای NPU مدرن توانستهاند این ماتریسهای ترنری را مستقیماً درون حافظههای SRAM بسیار سریع داخل تراشه جا داده و نرخ توکنسازی را از مرز ۶۰ توکن در ثانیه عبور دهند؛ سرعتی دو برابر سریعتر از سرعت خواندن طبیعی چشم انسان.
همگرایی با معماریهای اسپایکینگ و مدلهای فضای حالت در پردازش لبه
تکامل SLMها در اواخر صرفاً به کاهش ابعاد مدل محدود نمانده است، بلکه ساختار ترنسفورمر سنتی نیز با دستاوردهای شبکههای عصبی مایع (LNN) و مدلهای فضای حالت بازمهندسی شده است. با جایگزینی مکانیسم توجه درجه دوم (Quadratic Attention) با توابع حالت خطی بازگشتی، حجم بافر حافظه دیگر با افزایش طول گفتگوها منفجر نمیشود.
علاوه بر این، در شتابدهندههای هیبریدی جدید، بخشهایی از مدل با الهام از اصول شتابدهندههای هوش مصنوعی فوتونیک و نورومورفیک طراحی شدهاند تا قطارهای پالس عصبی ناهمگام را با کمترین مصرف میلیواتی پردازش کنند. این قابلیت امکان «شنود هوشمند منفعل» را در گجتهای پوشیدنی فراهم آورده است؛ جایی که هوش مصنوعی بدون داغ شدن دستگاه یا خالی کردن باتری، پیوسته در پسزمینه آماده پاسخ به فرامین کاربر است.
تلفیق این ساختارها با پایگاههای داده برداری محلی (Local Vector Embeddings)، مفهوم «حافظه بلندمدت آفلاین» را برای نخستین بار ممکن ساخته است؛ دستیاری شخصی که تمام تجارب، ایمیلها و مستندات شما را بدون ارسال حتی یک بایت داده به خارج از دستگاه، تحلیل و دستهبندی میکند.
چشمانداز اکوسیستم سختافزار؛ استقلال فناورانه در دسترس همگان
تغییر جهت صنعت از مدلهای چندصدمیلیارد پارامتری ابری به سمت خوشههایی از SLMهای تخصصی همکار، زمین بازی غولهای تکنولوژی را دموکراتیزه کرده است. اکنون توسعهدهندگان مستقل میتوانند مدلهای اختصاصی بهینهشده برای رشتههای پزشکی، حقوقی، مهندسی مکانیک یا نویسندگی تخصصی را با بودجههای چند هزار دلاری آموزش داده و به صورت پکیجهای سبک آفلاین توزیع نمایند.
در پایان، دوران کنونی یادآور این حقیقت درخشان است که قدرت پردازش واقعی در تسخیر سرورهای غولپیکر دوردست نیست؛ بلکه در کوچکسازی نبوغآمیز محاسبات، بومیسازی ادراک ماشین و بازگرداندن مالکیت کامل دادهها و افکار به دستان خود کاربران تعریف میشود.
بیشتر از هوش مصنوعی



