
راهنمای معماری مدلهای زبانی صوتی بومی
پایان دوران تاخیر رباتیک؛ چگونه مدلهای زبانی صوتی-تصویری بومی امروزه مکالمه طبیعی انسان و هوش مصنوعی را با تاخیر زیر ۱۰۰ میلیثانیه ممکن ساختند.
- بررسی جامع، فنی و معماری انقلاب مدلهای زبانی تمامچندوجهی بومی (Native End-to-End Omnimodal Models) نظیر GPT-4o Advanced Voice و Gemini 2.5 Live امروزه تحلیل موشکافانه برچیده شدن خط لولههای سهمرحلهای سنتی تبدیل گفتار به متن (ASR)، پردازش متن توسط LLM و تبدیل مجدد متن به صوت (TTS) که با تاخیرهای خستهکننده چندثانیهای ارتباط انسانی را مختل میکردند، کالبدشکافی کدکهای صوتی عصبی پیشرفته و کوانتیزاسیون برداری پسماند (RVQ) جهت توکنایزیشن پیوسته فرکانسهای آکوستیک، دستیابی به تاخیر استنتاج تاریخی زیر ۱۰۰ میلیثانیه با پردازش استریمینگ تمامدوطرفه (Full-Duplex)، تحلیل درک لحن، خنده، لرزش صدا و وقفه همزمان در مکالمه، و ارزیابی پیوند این مدلها با ابزارهای بلادرنگ پردازش بینایی برای دستیاران شخصی و جراحی از راه دور.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
مرگ خط لولههای چندمرحلهای ASR-LLM-TTS؛ چرا دستیاران صوتی سنتی هرگز طبیعی به نظر نمیرسیدند؟
برای بیش از یک دهه، هر دستیار صوتی از سیری و الکسا تا نسخههای اولیه دستیارهای مبتنی بر مدلهای زبانی بزرگ، بر پایهای شکننده و غیرمستقیم استوار بودند: یک مدل شناسایی خودکار گفتار (ASR) صدای کاربر را به متن تایپشده تبدیل میکرد، سپس این متن به هسته مدل زبانی تزریق میشد تا پاسخی متنی تولید کند، و در نهایت یک موتور تبدیل متن به گفتار (TTS) آن خروجی را با صدایی مصنوعی بازخوانی میکرد.
این ساختار سه لایه با سه بنبست نابخشودنی مواجه بود: نخست، انباشت فاجعهبار تاخیر زمانی (Latency Accumulation) که زمان انتظار بین پایان سخن کاربر تا شنیدن نخستین واژه را به ۱.۵ تا ۳ ثانیه میرساند و مکالمه طبیعی را ناممکن میساخت. دوم، نابودی کامل دادههای پارازبانشناختی؛ متن تایپشده تفاوت میان طعنه، اندوه، تردید، تنفس عمیق، خشم یا نجوا را به کلی دور میریخت. سوم، ناتوانی در تعامل تمامدوطرفه (Full-Duplex) و قطع صحبت؛ اگر کاربر حین حرف زدن دستیار نکتهای میگفت، سیستم توانایی شنیدن همزمان و تنظیم خروجی را نداشت.
با عبور به دوران معاصر این معماریهای سرهمبندیشده جای خود را به مدلهای چندوجهی سرتاسری بومی (Native Speech-to-Speech LLMs) دادهاند؛ شبکههایی که در آنها امواج صوتی همانند توکنهای کلمات، بدون هیچ واسطهای در فضای برداری مشترک با متن و تصویر پردازش میشوند. همانطور که در بررسی معماری ترکیبی مامبا و ترنسفورمر اشاره کردیم، بهینهسازی محاسباتی استنتاج نقش کلیدی در کاهش تاخیرهای محاسباتی ایفا کرده است.
کدکهای صوتی عصبی و توکنایزیشن پیوسته امواج با کوانتیزاسیون برداری پسماند (RVQ)
شاهکار ریاضیاتی که این جهش را میسر ساخت، توسعه کدکهای صوتی عصبی با نرخ بیت بسیار پایین و بازسازی وفادارانه نظیر Mimi، SNAC و خانواده پیشرفته EnCodec نوین است. چالش بنیادین در پردازش صوت، ابعاد نجومی سیگنال آنالوگ است؛ یک ثانیه صوت با کیفیت معمولی حاوی حداقل ۲۴ هزار نمونه عددی خام است که بلعیدن مستقیم آن توسط پنجره بافت مدل زبانی غیرممکن مینمود.
کدکهای عصبی مدرن با استفاده از شبکههای کانولوشنی متقارن و لایههای کوانتیزاسیون برداری پسماند (Residual Vector Quantization - RVQ)، سیگنال صوتی پیوسته را به رشتهای فشرده از توکنهای گسسته در لایههای سلسلهمراتبی تبدیل میکنند. در لایه اول، کلیات آوایی و معنایی گفتار در قالب چند ده توکن بر ثانیه کدگذاری میشود، در حالی که لایههای پسماند بعدی به صورت موازی ریزترین جزئیات آکوستیک نظیر طنین محیطی، لحن حنجره و فرکانسهای زیر را پوشش میدهند.
این توکنهای صوتی دقیقاً در کنار توکنهای متنی و تکههای تصویر (Image Patches) وارد ماتریس توجه خودکار ترنسفورمر میشوند. به این ترتیب، مدل نه تنها کلمات گفتهشده را میفهمد، بلکه فرکانسهای احساسی گوینده را همزمان با ورودی بصری دوربین تحلیل مینماید.
شکستن سد ۱۰۰ میلیثانیه؛ جریانسازی تمامدوطرفه و پیشبینی بازگشتی اولین توکن
مکالمه انسانی بر طبق مطالعات نوروساینس، نیازمند پنجره پاسخدهی در محدوده ۱۵۰ الی ۲۵۰ میلیثانیه است؛ هر تاخیری بیش از ۳۰۰ میلیثانیه باعث قطع ارتباط ذهنی و القای حس عدم توجه طرف مقابل میشود. در مدلهای صوتی بومی دوران معاصر زمان تولید اولین توکن آکوستیک (Time-to-First-Audio-Token) به زیر ۸۵ میلیثانیه سقوط کرده است.
این پیروزی خارقالعاده از طریق استنتاج جریانمحور تکهتکه (Chunk-based Streaming Inference) و مکانیزمهای توجه پیشبینانه حاصل شده است. مدل برای پاسخ دادن، منتظر اتمام کامل جمله کاربر نمیماند؛ بلکه به موازات ورود جریان داده صوتی، احتمالات معنایی را محاسبه کرده و فریمهای صوتی را با هدایت مستقیم میکروسرویسهای سرورلس با ایزولههای لبه V8 با کمترین سربار پردازشی به سوی گوش کاربر گسیل میدارد.
علاوه بر این، مکانیزم مدیریت وقفه (Interruptibility Logic) به مدل اجازه میدهد تا سیگنال میکروفون را حتی در هنگام تولید خروجی با بالاترین نرخ نمونهبرداری زیر نظر بگیرد؛ به محض اینکه کاربر کلمهای بر زبان میآورد یا حتی سرفه میکند، استنتاج در میلیثانیه متوقف شده و سیستم با تغییر حالت به شنونده فعال تبدیل میگردد.
همگرایی صوت، تصویر و فیزیک سهبعدی؛ چشمانداز دستیاران بلادرنگ در اتاق عمل و کارخانهها
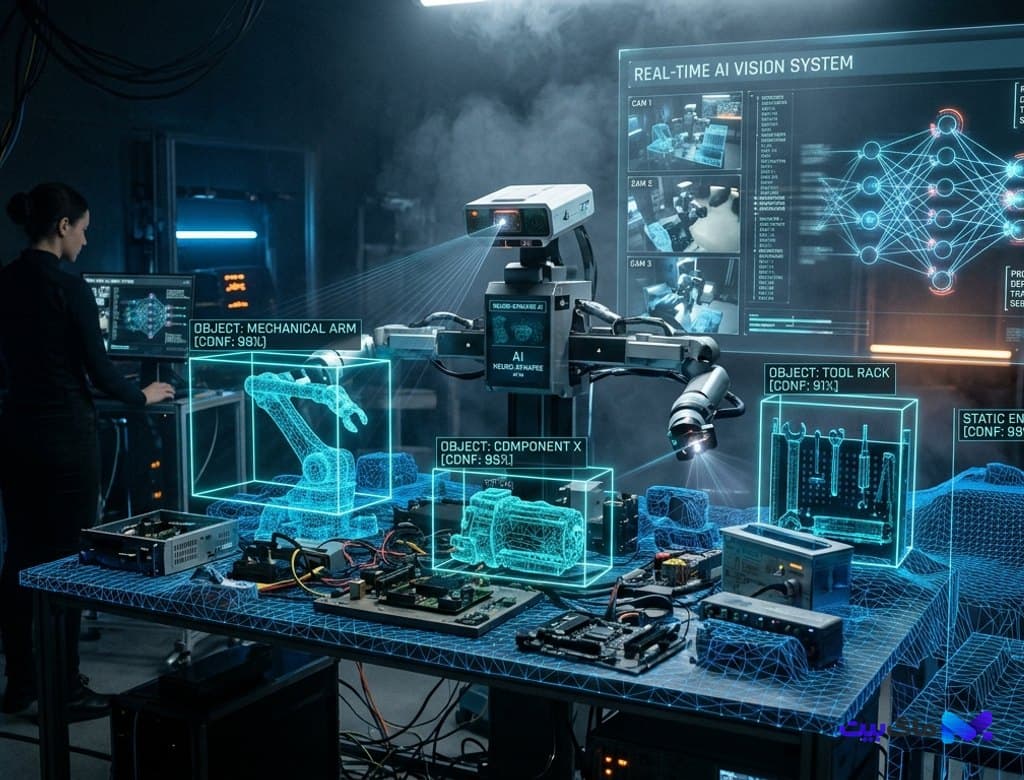
قدرت شگفتانگیز مدلهای صوتی بومی زمانی دوچندان میشود که با دادههای دوربینهای پوشیدنی و عینکهای هوشمند ترکیب میگردد. از آنجا که تصویر و صوت در یک بستر تنسوری مشترک همگامسازی شدهاند، مدل میتواند با مشاهده مسیر نگاه کاربر، به اشیای فیزیکی ارجاع دهد: «آن پیچ سوم از سمت راست را در جهت عقربههای ساعت بچرخانید.»
در کاربردهای پزشکی و جراحی لاپاراسکوپی، دستیار هوش مصنوعی بدون نیاز به نگاه کردن جراح به مانیتور، راهنماییهای آناتومیک را به صورت بلادرنگ در گوش پزشک زمزمه کرده و در صورت مشاهده خونریزی پنهان، با لحنی هشداردهنده اما آرام تذکر میدهد. این یکپارچگی رفتاری بسیار فراتر از مدلهای سنتی است و مستقیماً با دستاوردهای مدلهای استدلالگر و تفکر زنجیرهای در تحلیل مسائل پیچیده پیوند خورده است.
همچنین، ادغام این سامانهها با واسطهای عصبی مغز و رایانه BCI پنجرههای تازهای به روی افراد دارای معلولیتهای شدید گفتاری گشوده است؛ جایی که حتی انقباضات خفیف حنجره یا سیگنالهای مغزی میتوانند به گفتاری رسا و غنی با لحن واقعی خود فرد تبدیل شوند.
چالشهای ایمنی، شبیهسازی بیومتریک و افق بازسازی هویت صوتی دیجیتال
همانگونه که هر جهش بنیادین فناوری خطرات مختص به خود را به همراه دارد، مدلهای زبانی صوتی بومی نیز با چالشهای امنیتی و حقوقی پیچیدهای امروزه مواجهاند. توانایی این مدلها در شبیهسازی بلادرنگ ویژگیهای بیومتریک حنجره هر انسانی تنها با شنیدن ۳ ثانیه از صدای او، مرزهای تشخیص جعل هویت و حملات مهندسی اجتماعی را به کلی متزلزل کرده است.
برای مقابله با این تهدید، استانداردهای رمزنگاری محتوای صوتی با درج واترمارکهای طیفی غیرقابلشنیدن (Imperceptible Spectral Watermarking) در عمق کدهای RVQ اجباری شده است. این امضاهای کوانتومی به سرورها و سامانههای بانکی اجازه میدهند تا در کسری از میلیثانیه، صدای تولیدشده توسط شبکه عصبی را از گفتار طبیعی انسان تمیز دهند.
مدلهای زبانی صوتی-تصویری بومی دوران معاصر ثابت کردند که آینده تعامل انسان با فناوری، نه در تایپ کردن روی شیشههای سرد لمسی و نه در مکالمات مقطع با رباتهای بیاحساس، بلکه در گفتگویی زنده، پرشور و سرشار از ظرافتهای انسانی رقم میخورد؛ آغازی حقیقی برای هوش مصنوعی همهجانبه که کلمات را نه به عنوان زنجیرهای از حروف، بلکه به مثابه طنین روح و معنا ادراک میکند.
⚠️ سلب مسئولیت پزشکی
اطلاعات و دادههای ارائهشده در این مقاله صرفاً با هدف افزایش آگاهی در زمینه فناوریهای سلامت منتشر شده است و نباید به عنوان توصیه، تشخیص یا پروتکل درمانی پزشکی تلقی گردد. پیش از هرگونه تصمیمگیری یا تغییر در برنامههای سلامت فردی، با پزشک متخصص مشورت نمایید.
بیشتر از هوش مصنوعی



