
انقلاب یادگیری تقویتی با پاداشهای قابلتایید
پایان عصر پاداشهای سلیقهای؛ چگونه یادگیری تقویتی با پاداشهای قابلتایید (RLVR) و زبانهای اثبات فرمال، خطای توهم هوش مصنوعی را در ریاضیات و مهندسی نرمافزار به صفر نزدیک کردند.
- تحلیل موشکافانه بزرگترین جهش در همترازی و آموزش مدلهای استدلالگر هوش مصنوعی (Reasoning Models) امروزه گذار از روش شکننده یادگیری تقویتی با بازخورد انسانی (RLHF) به پارادایم نوین یادگیری تقویتی با پاداشهای قابلتایید (Reinforcement Learning with Verifiable Rewards یا RLVR). در این مقاله، نحوه استفاده از محیطهای تایید فرمال مانند Lean 4 و Isabelle، اجرای بلادرنگ کدهای تولیدی در سندباکسهای امن، حذف توهمات منطقی در حل مسائل المپیادهای علمی و شتاببخشی به هوش مصنوعی نمادین واکاوی شده است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
افول دوران RLHF؛ چرا ترجیحات انسانی و نمرهدهی سلیقهای هوش مصنوعی را به بنبست کشاند؟
برای بیش از چهار سال، روش یادگیری تقویتی با بازخورد انسانی (RLHF) ستون فقرات رام کردن مدلهای زبانی بزرگ بود. در این ساختار، مدلهای پاداش (Reward Models) تلاش میکردند خروجیهایی را که از دید برچسبگذاران انسانی مودبانهتر، جذابتر یا طولانیتر به نظر میرسیدند تشویق کنند. اما در استدلالهای پیچیده ریاضی، مهندسی الگوریتم و نگارش نرمافزارهای حیاتی، این روش با پدیدهای ویرانگر به نام هک پاداش (Reward Hacking) و توهم چاپلوسانه مواجه شد؛ جایی که مدل یاد میگرفت به جای ارائه پاسخ درست، با لحنی بسیار مطمئن و منطقینما پاسخی کاملاً اشتباه اما فریبنده تولید کند.
ضعف بنیادین انسان در ارزیابی کدهای طولانی و اثباتهای ریاضی چندصفحهای باعث شد که مدلها در سطحی متوسط درجا بزنند. حتی با پیشرفتهای چشمگیر در انقلاب مدلهای زبانی دیفیوژن متنی، اگر سیگنال پاداش ناپایدار و کیفی باشد، شبکه عصبی قادر به تشخیص درستی مطلق یک ادعا از یک مغالطه ظریف نیست. دانشمندان دریافتند که برای عبور به مرحله هوش مصنوعی فراانسانی در علوم پایه، سیستم ارزیابی باید از انسان سلب شده و به داوران ریاضیاتی انعطافناپذیر واگذار گردد.
امروزه جامعه پژوهشی هوش مصنوعی با گذر شجاعانه از قضاوتهای کیفی، معماری یادگیری تقویتی با پاداشهای قابلتایید (Reinforcement Learning with Verifiable Rewards یا RLVR) را به عنوان استاندارد زرین مدلهای فرانتیر مستقر ساخت؛ راهکاری انقلابی که در آن تنها خروجیهایی پاداش دریافت میکنند که بتوان درستی آنها را به صورت ریاضی، منطقی یا با اجرای کد در یک سندباکس اثبات کرد.
معماری RLVR و ادغام زبانهای اثبات فرمال Lean 4 و Isabelle؛ وقتی ریاضیات داور نهایی میشود
هسته مرکزی RLVR بر ایجاد یک محیط بازی قطعی (Deterministic Game Environment) استوار است. در حوزههایی مانند المپیادهای بینالمللی ریاضی (IMO)، رمزنگاری و منطق صوری، هوش مصنوعی موظف است نه تنها راه حل خود را به زبان طبیعی، بلکه گام به گام در قالب کدهای زبان اثبات فرمال مانند Lean 4 یا Isabelle تدوین نماید. اثباتگر فرمال مانند یک کامپایلر فوقسختگیر عمل میکند که کوچکترین پرش منطقی یا فرضیه اثباتنشده را بلافاصله رد میکند.
در این چارچوب آموزشی، اگر اثباتگر Lean 4 کد فرمال را بپذیرد (Q.E.D حاصل شود)، مدل پاداش قطعی ۱ دریافت میکند؛ در غیر این صورت، پاداش دقیقاً ۰ است. این سیگنال پاداش باینری و بدون ابهام، شرایطی ایدهآل برای الگوریتمهای گرادیان خطمشی (Policy Gradient) نظیر PPO و DPO فراهم میسازد. شبکه عصبی پس از میلیونها دور تلاش مستقل در گستره وسیعی از شاخههای جستجو، یاد میگیرد استراتژیهای استدلالی خود را همانند استادان بزرگ شطرنج اصلاح نماید.
این همگرایی با پیشرفتهای مدلهای استدلالگر و تفکر زنجیرهای در OpenAI o3 و DeepSeek-R1 پدیدهای شگفتآور خلق کرده است: مدلهای زبانی دیگر صرفاً به تطبیق الگوهای متنی پیشین تکیه نمیکنند، بلکه فرضیههای نوآورانه ریاضیاتی تولید کرده و خودشان پیش از ارائه به کاربر، صحت قطعی آنها را از طریق اثبات فرمال راستیآزمایی مینمایند.
انقلاب در مهندسی نرمافزار خودکار؛ تستهای واحد پویا و سندباکسهای زمان اجرا
فراتر از ریاضیات محض، تاثیرگذارترین کاربرد میدانی RLVR در مهندسی نرمافزار نمایان شده است. در متدهای سنتی، دستیاران کدنویسی کدی تولید میکردند که از نظر ظاهری بینقص به نظر میرسید، اما در عمل با خطای زمان اجرا (Runtime Error) مواجه میشد یا باگهای پنهان امنیتی داشت. با سازوکار RLVR، مدل در حین حل یک تیکت نرمافزاری، کد تولید شده را فوراً در یک سندباکس ایزوله لینوکسی اجرا میکند.
سیستم اعتبارسنجی خودکار شامل مجموعهای از یونیتتستها، پراپرتیتستها (Property-Based Testing) و تستهای فازینگ (Fuzz Testing) است. اگر کد تمام تستها را پاس کند و هیچ نشت حافظهای نداشته باشد، پاداش آزاد میشود. در صورت بروز خطا، پیام کامپایلر یا گزارش خطا به عنوان فیدبک به خود مدل بازگردانده میشود تا بلافاصله دست به تصحیح خودکار (Self-Correction) بزند؛ سازوکاری که راندمان ابزارهایی نظیر دستیاران هوشمند کدنویسی خودکار نظیر Devin و Cursor را از سطح یک کدنویس جونیور به یک مهندس معمار ارشد ارتقا داده است.
این فرآیند تاییدپذیری، اعتماد به نرمافزارهای خودتوسعهیافته را در سیستمهای حساس بانکی، کنترل ترافیک هوایی و هدایت فضاپیماها به اوج رسانده است، زیرا در این پروژهها هیچ خط کدی بدون گواهی فرمال عدم سرریز بافر و ایمنی ریاضی وارد خط تولید (Production) نمیشود.
همافزایی با جستجوی زمان استنتاج و شکستن سد توهمات در علوم طبیعی
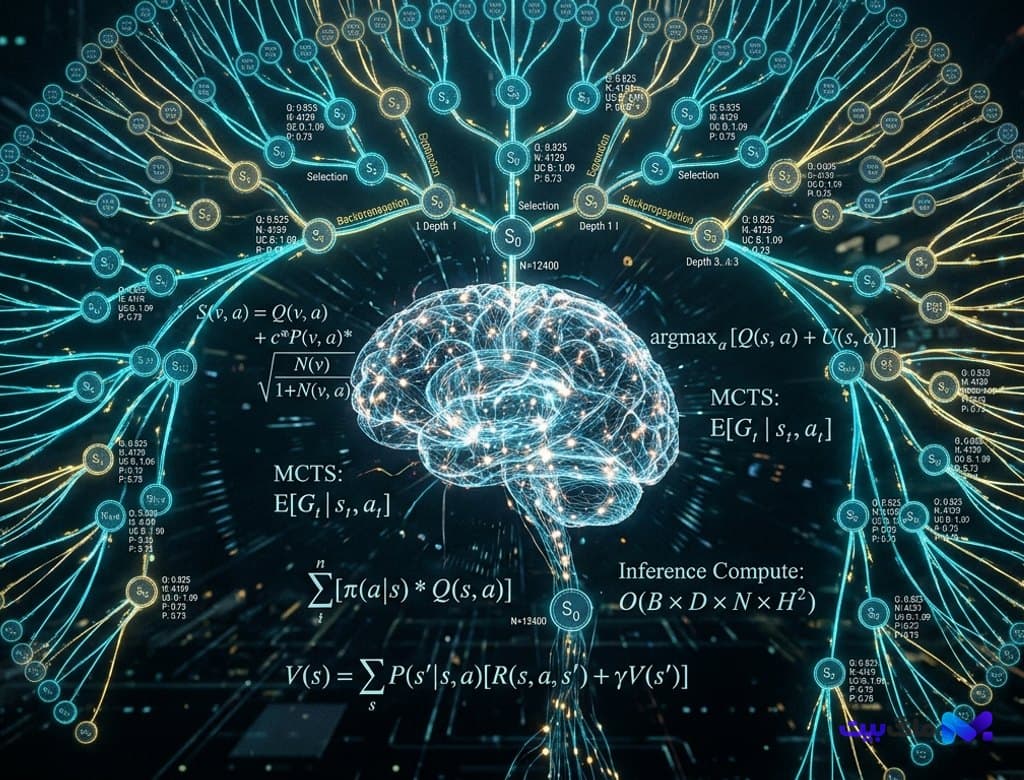
یکی دیگر از ابعاد تحولآفرین RLVR، پیوند تنگاتنگ آن با تکنیکهای جستجوی زمان استنتاج (Test-Time Search) و الگوریتمهای جستجوی درخت مونتکارلو (MCTS) است. زمانی که مدل با یک مسئله بهینهسازی پیچیده روبرو میشود، در حین پاسخگویی دهها شاخه احتمالی مختلف را بررسی میکند. برخلاف مدلهای قدیمی که نمیدانستند کدام شاخه بهتر است، اعتبارسنج RLVR در هر گام میانی میتواند شاخههای غلط را شاخهزنی (Pruning) کند.
ترکیب این جستجوی ساختاریافته با پیشبینی چندتوکنی و استنتاج حدسی در مدلهای زبانی سرعت بررسی فرضیهها را به هزاران استدلال در ثانیه رسانده است. در حوزههایی مانند شیمی محاسباتی و کشف دارو، مدل فرمولهای واکنش یا ساختارهای کریستالی را به شبیهسازهای فیزیکی ارسال کرده و تنها در صورتی که قوانین ترمودینامیک نقض نشوند، فرآیند سنتز را ادامه میدهد.
بدین ترتیب، خطای توهم که به عنوان پاشنه آشیل همیشگی هوش مصنوعی شناخته میشد، در تمام دامنههایی که دارای قوانین فرمال و قابلتایید هستند مهار شده است. این دستاورد، افقهای نوینی را برای ایجاد آزمایشگاههای علمی کاملاً خودمختار باز کرده که در آنها فرضیهها در چند دقیقه آزموده و اثبات میشوند.
چشمانداز آینده؛ حرکت به سوی سیستمهای اثباتگر خودارتقادهنده (Self-Improving AI)
شاید عمیقترین دستاورد فنی RLVR امروزه گشودن مسیر واقعی به سمت خودبهینهسازی بازگشتی (Recursive Self-Improvement) در هوش مصنوعی باشد. در روشهای متکی به انسان، سرعت آموزش مدل همواره محدود به سرعت برچسبگذاری و توان فکری انسانها بود. اما با داوران فرمال رایانهای، مدل میتواند در طول شبانهروز با تولید میلیونها مسئله ریاضی و قضایای باز اثباتنشده با خود مسابقه دهد و مرزهای دانش ریاضی بشر را گسترش دهد.
ما اکنون شاهد مدلهایی هستیم که در حال کشف قضایای نوینی در هندسه جبری و نظریه اعداد هستند که ریاضیدانان برجسته برای دههها در حل آنها ناکام مانده بودند. با استقرار شبکههای اثباتگر مشترک، جوامع علمی میتوانند مقالات پژوهشی را نه به صورت متنهای گنگ پیدیاف، بلکه به شکل پایگاه دادههای کد Lean که در کسری از ثانیه اعتبارسنجی میشوند منتشر سازند.
دوران کنونی نماد بلوغ واقعی هوش مصنوعی از یک تقلیدکننده کلامی زبان به یک ماشین اثباتگر منطقی است؛ تحولی سترگ که در آن هوش مصنوعی نه با اتکا به حدس و تقریب، بلکه با تکیه بر برهانهای قاطع و خللناپذیر ریاضی، در حال پیریزی شالودههای تمدن علمی فرداست.
بیشتر از هوش مصنوعی



