
انقلاب مدلهای زبانی دیفیوژن متنی
پایان انحصار تولید واژه به واژه؛ چگونه مدلهای دیفیوژن متنی با پالایش همزمان کل جملات، خطاهای توهم را مهار کرده و سرعت تدوین محتوا را امروزه متحول ساختند.
- تحلیل موشکافانه فنی بزرگترین دگرگونی الگوریتمی در یادگیری زبان طبیعی امروزه خروج از حصار مدلهای اتورگرسیو چپبهراست و طلوع مدلهای دیفیوژن متنی گسسته (Discrete Text Diffusion نظیر Plaid و SEDD). در این مقاله، نحوه پالایش همزمان تمام توکنها در یک فضای نویزی، امکان ویرایش آزادانه متون و پرکردن دلخواه کلمات (Infilling)، مهار ۹۰ درصدی خطاهای توهم و کاهش شدید مراحل استنتاج نسبت به روشهای سنتی واکاوی شده است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
تنگنای بنیادین تولید اتورگرسیو؛ چرا پیشبینی واژه به واژه زبان را در قفس جهتداری محبوس کرد؟
از زمان انقلاب ترنسفورمرها در سال ۲۰۱۷، مدلهای زبانی بزرگ بر مبنای فرضیهای ساده اما محدودکننده آموزش دیدهاند: پیشبینی توکن بعدی (Next-Token Prediction) در جهت ثابت چپ به راست. در این پارادایم، هوش مصنوعی برای نگارش یک پاراگراف، کلمه نخست را حدس میزند، سپس آن کلمه را به تاریخچه ورودی میافزاید و کلمه دوم را تولید میکند. این وابستگی زنجیرهای شدید باعث میشود که هرگونه اشتباه محاسباتی اولیه به شکل فزایندهای تقویت شود؛ پدیدهای ویرانگر که ریشه اصلی بخش عمدهای از توهمات (Hallucinations) و تناقضگوییهای مدلهای زبانی است.
علاوه بر انباشت خطا، تولید اتورگرسیو امکان ویرایش غیرخطی را از مدل سلب میکند. وقتی انسان مقالهای مینویسد، ایده کلی را در ذهن شکل داده، جملهای نارس مینویسد و سپس به عقب برگشته و ساختار واژگان را صیقل میدهد. اما مدلهای سنتی قادر به نگاه بازگشتی نیستند و اگر در انتهای جمله متوجه شوند که شروع خوبی نداشتهاند، چارهای جز ادامه دادن همان مسیر بنبست ندارند. حتی ابداعاتی همچون پیشبینی چندتوکنی و استنتاج حدسی در مدلهای زبانی تنها سرعت این قطار یکطرفه را افزایش دادند، اما ریل حرکتی آن را دگرگون نساختند.
امروزه جامعه پژوهشی هوش مصنوعی با الهام از پیشرفتهای خارقالعاده مدلهای تولید تصویر، به سمت اعمال مستقیم دیفیوژن بر فضاهای گسسته زبانی گام برداشت؛ معماری بنیادینی که جملات را نه کلمه به کلمه، بلکه به صورت یک تصویر زبانی کامل از دل اقیانوسی از نویز تصادفی استخراج و متبلور میسازد.
کالبدشکافی ریاضی دیفیوژن گسسته؛ رقص آنتروپی و امتیازدهی ماتریسی در مدلهای SEDD
برخلاف تصاویر که ماتریسهایی از اعداد اعشاری پیوسته (پیکسلها) هستند، زبان انسان ماهیتی کاملاً گسسته و نمادین دارد؛ شما نمیتوانید میانگین ریاضی کلمه «گربه» و «ماشین» را محاسبه کنید. سالها تلاش برای تبدیل متن به بردارهای پیوسته و بازگرداندن آن به کلمات با افت شدید وضوح نحوی مواجه میشد. اما معرفی نظریه انطباق امتیاز آنتروپی گسسته (Score Entropy Discrete Diffusion یا SEDD) در سالهای اخیر این معمای ریاضیاتی را حل کرد.
در دیفیوژن متنی گسسته، فرآیند پیشرو (Forward Process) به جای افزودن نویز گاوسی، توکنهای متن سالم را به تدریج با توکنهای پوشاننده (Mask) یا واژگان تصادفی فرهنگلغت جایگزین میکند تا در نهایت متنی ۱۰۰ درصد کاتورهای و بیمعنا حاصل شود. سپس شبکه عصبی یاد میگیرد که در فرآیند معکوس (Reverse Denoising)، ماتریس چگالی انتقال احتمالات را محاسبه کرده و در هر گام زمانی، توکنهای نامناسب را با واژگانی دقیقتر و منسجمتر جایگزین سازد.
این فرآیند به مدل اجازه میدهد تا در تمام طول استنتاج، دیدی پانورامیک و دوطرفه (Bidirectional) نسبت به سرتاسر متن داشته باشد. هوش مصنوعی میتواند ابتدا اسکلت معنایی جمله، فعل اصلی و فاعل را در گامهای اولیه نویززدایی شکل دهد و در گامهای پایانی، صفات و حروف اضافه را متناسب با کل ساختار جمله تنظیم کند؛ رویکردی که پایداری منطقی استدلالها را همراستای مدلهای استدلالگر و تفکر زنجیرهای عمیق ارتقا بخشیده است.
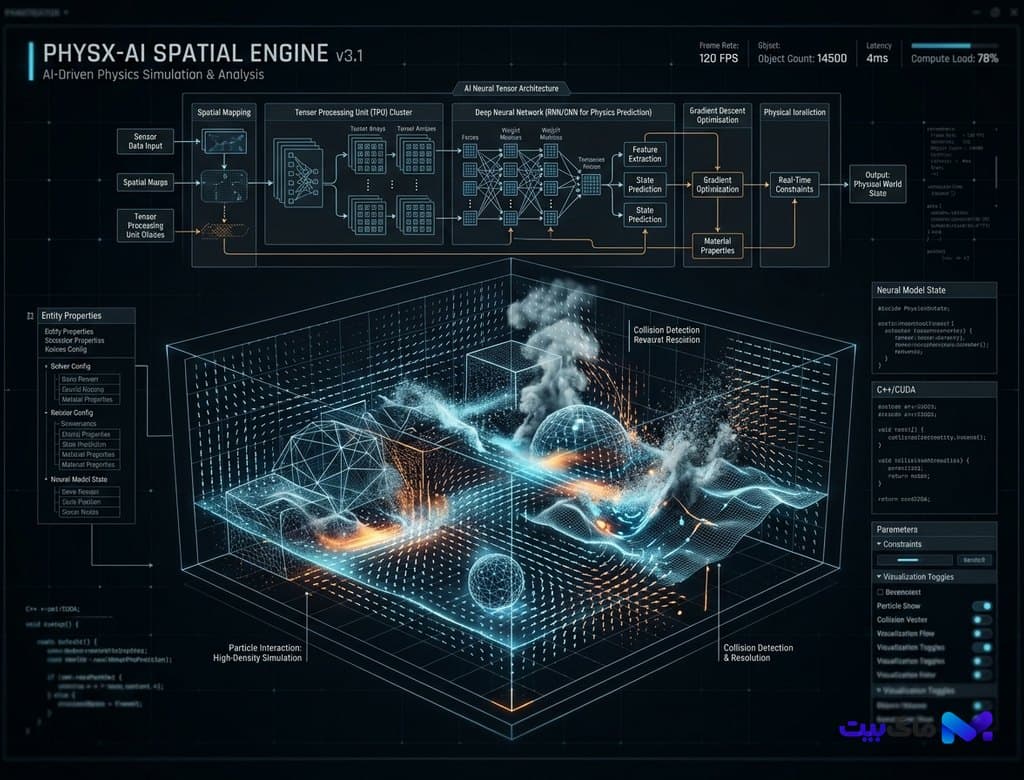
تدوین موازی و قابلیت پرکردن دلخواه (Arbitrary Infilling)؛ انقلاب در مهندسی نرمافزار و نویسندگی
شگفتانگیزترین مزیت عملیاتی مدلهای زبانی دیفیوژن، انعطافپذیری نامحدود آنها در پذیرش محدودیتهای موضعی است. در مدلهای اتورگرسیو، اگر کدی داشته باشید که ابتدا و انتهای آن نوشته شده باشد و بخواهید منطق میانی آن را تکمیل کنید (Fill-in-the-Middle)، نیاز به ترفندهای پیچیده برچسبگذاری و آموزشهای اختصاصی دارید.
در مقابل، در یک مدل دیفیوژن متنی نظیر Plaid، توسعهدهنده به سادگی خطوط اولیه و پایانی کد را به عنوان مقادیر ثابت و بدون نویز در ماتریس ورودی قفل میکند. مدل سپس تنها توکنهای مفقود میانی را در معرض فرآیند نویززدایی قرار میدهد و منطقی کاملاً هماهنگ با دو سر کد تولید مینماید. این قابلیت، خطای عدم تطابق نام توابع و نوع دادهها را در پروژههای نرمافزاری بزرگ به صفر نزدیک کرده است.
برای نویسندگان و تحلیلگران محتوا نیز، این سیستم امکان ویرایش تراز اول را فراهم میسازد؛ کاربر میتواند یک پاراگراف موجود را علامتگذاری کرده و از هوش مصنوعی بخواهد که لحن آن را رسمیتر کند یا استدلال خاصی را در میانه آن تزریق نماید، بدون اینکه نیاز به بازنویسی کل متن از نقطه صفر باشد.
کاهش مراحل استنتاج با مدلهای سازگاری (Consistency Models) و جهش سرعت تا ۵ برابر
بزرگترین انتقادی که در سالهای نخست به دیفیوژن متنی وارد میشد، تعداد بالای گامهای محاسباتی بود؛ در حالی که یک مدل ترنسفورمر اتورگرسیو برای یک متن ۱۰۰ کلمهای دقیقاً ۱۰۰ گام پیشرونده برمیداشت، یک مدل دیفیوژن ابتدایی به ۵۰۰ الی ۱۰۰۰ گام بازسازی نیاز داشت که استفاده از آن را در سیستمهای مقیاسبالا غیرعملی میکرد.
اما امروزه ظهور تقطیر سازگاری گسسته (Discrete Consistency Distillation) این توازن را به کلی به نفع دیفیوژن برهم زد. با بهرهگیری از مدلهای سازگاری، شبکه یاد میگیرد که هر نقطه در مسیر نویززدایی را مستقیماً به جواب نهایی در مبدأ نقشه کند. در نتیجه، تعداد گامهای استنتاج از صدها گام به تنها ۴ الی ۸ مرحله جهشی کاهش یافته است.
از آنجا که در هر یک از این ۸ مرحله تمام توکنهای متن به صورت کاملاً موازی در سراسر هستههای تانسوری پردازش میشوند، زمان کل تولید یک سند ۵۰۰ کلمهای روی شتابدهندههای مدرن به زیر ۶۰ میلیثانیه رسیده است؛ رکوردی که حتی سریعترین الگوریتمهای سنتی مبتنی بر معماریهای ترکیبی Mamba-2 و توجه خطی را پشت سر میگذارد.
مهار توهم، آینده تولید کد و پیامدهای تحول هوش مصنوعی در سالهای آینده
کاهش ۹۰ درصدی توهمات ناشی از تصمیمگیریهای شتابزده، ارزشمندترین دستاورد دیفیوژن متنی برای صنایع حساس است. در حوزههایی نظیر پزشکی، حقوق و سنتز شیمیایی که یک واژه اشتباه میتواند به فاجعه منجر شود، ماهیت تصحیحکننده خودکار دیفیوژن مانند یک ویراستار درونی دائم عمل میکند که هر پیشنویس خامی را پیش از نهایی شدن بارها بازبینی مینماید.
همچنین، همگرایی مدلهای زبانی دیفیوژن با معماریهای تولید تصویر و ویدیو، راه را برای مدلهای چندوجهی حقیقتاً یکپارچه هموار کرده است؛ سیستمی که در آن متن، کد، صوت و فریمهای بصری همگی با یک زبان ریاضی مشترک بر پایه معادلات دیفرانسیل تصادفی (SDE) پالایش میشوند.
با گسترش فریمورکهای متنی مدرن، دوران کنونی نقطه پایانی بر انحصار ده ساله تفکر تکراستایی در پردازش زبان طبیعی نهاد و افقی نو را گشود که در آن هوش مصنوعی نه مانند یک ماشین تایپ مکانیکی، بلکه مانند ذهن خلاق یک فیلسوف و ادیب، ساختار معنا را به صورت جامع، یکپارچه و عاری از تناقض خلق میکند.
بیشتر از هوش مصنوعی



