
مقیاسپذیری زمان آزمون و استدلال عمیق
پایان دوران اتکای کورکورانه به بزرگتر کردن مدلها؛ اکنون هوش مصنوعی با صرف زمان و پردازش بیشتر در لحظه پاسخدهی و شبیهسازی مسیرهای تفکر، مسائل غیرقابلحل را با دقتی بیسابقه میشکافد.
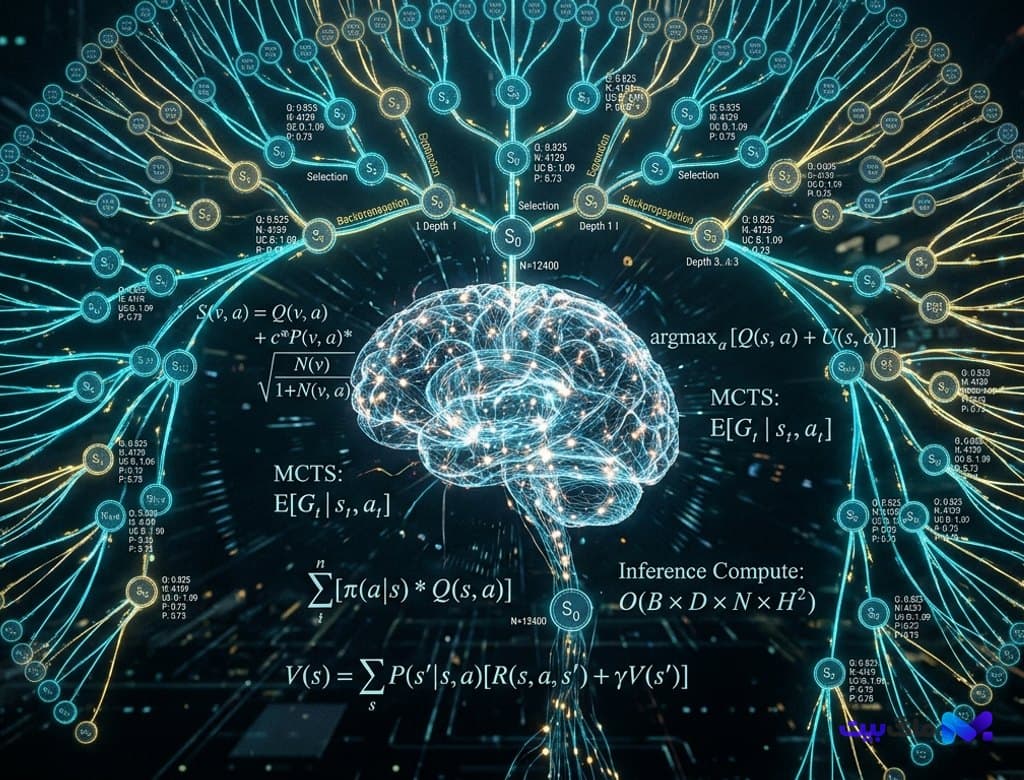
- تحلیل تخصصی تغییر پارادایم هوش مصنوعی از مقیاسبندی پیشآموزش به مقیاسپذیری زمان آزمون (Test-Time Compute Scaling) امروزه. کالبدشکافی تلفیق جستجوی درختی مونتکارلو (MCTS)، مدلهای پاداش فرایندی (Process Reward Models)، زنجیره تفکر خوداصلاحگر (Self-Correction CoT) و بهینهسازی بودجه محاسباتی استنتاج برای حل مسائل پیچیده ریاضی، المپیاد، مهندسی نرمافزار و تحقیقات علمی بدون نیاز به دیتاستهای عظیم وب. واکاوی دستاوردهای نسل نوین استدلال عمیق و کاربرد آن در اثبات قضایا و کشف الگوریتمها.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
مقدمه و بررسی اولیه
پایان قانون مقیاس پیشآموزش؛ اشباع دادههای وب و ظهور قانون استنتاج
برای بیش از یک دهه، قانون طلایی پیشرفت یادگیری ماشین بر پایه قانون مقیاسبندی کاپلان و چنچیلا استوار بود: مدل بزرگتر، دادههای آموزش بیشتر و کلاسترهای حجیمتر پردازشی، مستقیماً به کاهش خطای پیشبینی کلمات منجر میشدند. با این وجود، در آستانه دوران کنونی صنعت هوش مصنوعی با واقعیتی سخت روبهرو شد: منابع متنی باکیفیت وب به پایان رسیدهاند و هزینههای آموزش مدلهای تریلیون پارامتری با بازده نزولی شدیدی دستبهگریبان است. مدلهای سنتی حتی با صدها میلیارد پارامتر، به محض مواجهه با یک مسئله منطقی چندمرحلهای یا معمای الگوریتمی نامتعارف، در تله توهم آماری گرفتار میشدند.
همانطور که در واکاوی انقلاب هوش مصنوعی نوروسیمبولیک و اثبات صوری Lean 4 بیان شد، تولید سریعترین توکن بعدی (Next-Token Prediction) در کسری از میلیثانیه برای نوشتن شعر یا خلاصهسازی اخبار کافی است، اما تفکر انسانی در رویارویی با مسائل غامض بر سیستم ۲ دانیل کانمن اتکا دارد؛ تعمق، بررسی شاخههای مختلف فرضیه، بازگشت به عقب در صورت اشتباه و آزمودن منطقی راهحل. پارادایم مقیاسپذیری زمان آزمون (Test-Time Compute Scaling) دقیقاً این امکان را برای شبکههای عصبی محقق ساخته است.
در این الگوی انقلابی، مدل دیگر محدود به تولید خطی پاسخ در اولین تلاش نیست؛ بلکه سیستم بر اساس درجه سختی پرامپت، بودجه محاسباتی متغیری را در زمان استنتاج تخصیص میدهد. این یعنی هوش مصنوعی میتواند ثانیهها یا حتی دقایق متوالی در پشت صحنه «فکر کند»، احتمالات متکثر را بسنجد و پس از تایید درستی گامبهگام، خروجی نهایی قطعی و بدون توهم را به کاربر عرضه نماید.
کالبدشکافی جستجوی درختی MCTS و هدایت با مدلهای پاداش فرایندی (PRM)
هسته مهندسی مقیاسپذیری زمان استنتاج، احیای پیشرفته الگوریتمهای کلاسیک تئوری بازیها به ویژه جستجوی درختی مونتکارلو (Monte Carlo Tree Search) در پیوند با مدلهای زبانی است. در این فرآیند، هر تصمیم یا مرحله حل مسئله به عنوان یک گره در گراف تفکر در نظر گرفته میشود. مدل زبانی به عنوان مولد فرضیهها (Proposal Generator) عمل میکند و چندین سناریو یا استدلال موازی را برای هر مرحله پیشنهاد میدهد.
تفاوت حیاتی دوران کنونی با نسلهای گذشته، جایگزینی مدلهای پاداش نتیجهمحور (Outcome Reward Models - ORM) با مدلهای پاداش فرایندی (Process Reward Models - PRM) است. پیش از این، سیستم تنها در پایان کار و با داشتن پاسخ نهایی متوجه درست یا نادرست بودن مسیر میشد؛ رویکردی که در مسائل ریاضی و کدنویسی پیچیده، بازخورد به شدت کمتراکم و کمارزشی فراهم میکرد. اما مدلهای PRM مدرن، تکتک خطوط استدلال و پرشهای منطقی را بلافاصله پس از تولید وزندهی و اعتبارسنجی میکنند.
اگر یک شاخه از تفکر حاوی یک مغالطه جبری یا خطای منطقی باشد، ناظر فرایندی به سرعت امتیاز آن گره را کاهش داده و الگوریتم جستجو با هرس کردن شاخه معیوب (Pruning)، به عقب بازمیگردد (Backtracking) و انرژی محاسباتی را به شاخههای با پتانسیل بالاتر معطوف میسازد. این چرخه بازگشتی سبب شده مدلهای استدلالی در المپیادهای بینالمللی ریاضی و چالشهای مهندسی نوین به نمرات بالاتر از ۹۰ درصد دست یابند.
پروتکل توکنهای تفکر پنهان و زنجیره خوداصلاحگر (Self-Correction)
پیشرفت تکنولوژیک دیگر امروزه شکلگیری استانداردهای شفاف برای توکنهای تفکر درونی (Thinking Tokens) است. مدلهای استدلال چندمرحلهای پیش از ارائه پاسخ نهایی به کاربر، صدها یا هزاران توکن پنهان را برای کاوش و بحث درونی با خود تولید میکنند. در این فاز گفتوگوی مونولوگ، مدل فرضیات اولیه خود را زیر سوال میبرد، استثنائات پنهان مسئله را بررسی میکند و با آزمایش فرضیات روی حالتهای خاص، از درستی مسیر اطمینان حاصل مینماید.
تکنیکهای یادگیری تقویتی در سطح استنتاج (Inference-Time Reinforcement Learning) به مدل آموختهاند که چگونه استراتژیهای حل مسئله را بسته به پیچیدگی تنظیم کند. همانطور که در بررسی تخصصی انقلاب معماری مامبا Mamba-2 و مدلهای ترکیبی SSM تشریح شد، پردازش این حجم از توکنهای تفکر پنهان بدون معماریهای بهینه حافظه میتوانست منجر به قفل شدن کلاسترهای پردازشی شود، اما ترکیب مدلهای استدلالی با لایههای خطی و کشهای استنتاجی پایدار، این رویکرد را از نظر اقتصادی کاملاً مقیاسپذیر کرده است.
این توانایی خوداصلاحگری سبب شده است که حتی یک مدل نسبتاً کوچک با ۸ یا ۱۴ میلیارد پارامتر، چنانچه مجاز به استفاده از محاسبات طولانیتر در زمان استنتاج باشد، بتواند در حل مسائل دشوار ریاضی و مهندسی، مدلهای غولپیکر با وزنهای دهبرابری را که به صورت تکضرب پاسخ میدهند، با اختلافی فاحش پشت سر بگذارد.
پیامدهای استراتژیک در علم، داروسازی و مهندسی نرمافزار خودکار
پیامد تجاری مقیاسپذیری زمان آزمون امروزه مرزهای علوم بنیادی را دستخوش تحولی تاریخی کرده است. در حوزه کشف دارو و بیوانفورماتیک، سیستمهای استدلالی اکنون میتوانند مسیرهای دینامیک تاخوردگی پروتئین و مکانیسمهای اتصال مولکولی را به صورت گامبهگام در زمان استنتاج شبیهسازی و اعتبارسنجی کنند و فرضیات شیمیایی غیرممکن را پیش از ورود به آزمایشگاه حذف نمایند.
در مهندسی نرمافزار، ایجنتهای استدلالگر دیگر صرفاً کدنویسهای متنی نیستند؛ آنها با ایجاد محیطهای شبیهسازی محلی در زمان استنتاج، کدهای نوشتهشده را با تستهای لبه اجرا کرده، خطاها را ردیابی و اصلاح میکنند و سپس یک کامپایل بدون نقص را تحویل تیمهای توسعه میدهند. این چرخه استدلالی عمیق، نیاز به خطاهای انسانی در توسعه کدهای زیرساختی حساس را به حداقل رسانده است.
در نهایت، مدل تجاری ارائهدهندگان هوش مصنوعی ابری نیز در حال دگرگونی است؛ به جای قیمتگذاری ثابت بر اساس حجم پرامپت، اکنون شاخص «عمق تفکر» و بودجه زمانی پردازش به عنوان فاکتور اصلی ارزشگذاری خدمات شناختی شناخته میشود؛ تحولی بنیادین که مسیر دستیابی به هوش عمومی مصنوعی مبتنی بر استدلال موثق را هموارتر از هر زمان دیگری ساخته است.
بیشتر از هوش مصنوعی



