
مقیاسپذیری محاسبات زمان استنتاج و مدلهای استدلال عمیق
امروزه تمرکز پژوهشگران هوش مصنوعی از مقیاسپذیری سرسامآور پیشآموزش به مقیاسپذیری استنتاج و اختصاص بودجه محاسباتی به تفکر عمیق تغییر یافته است.
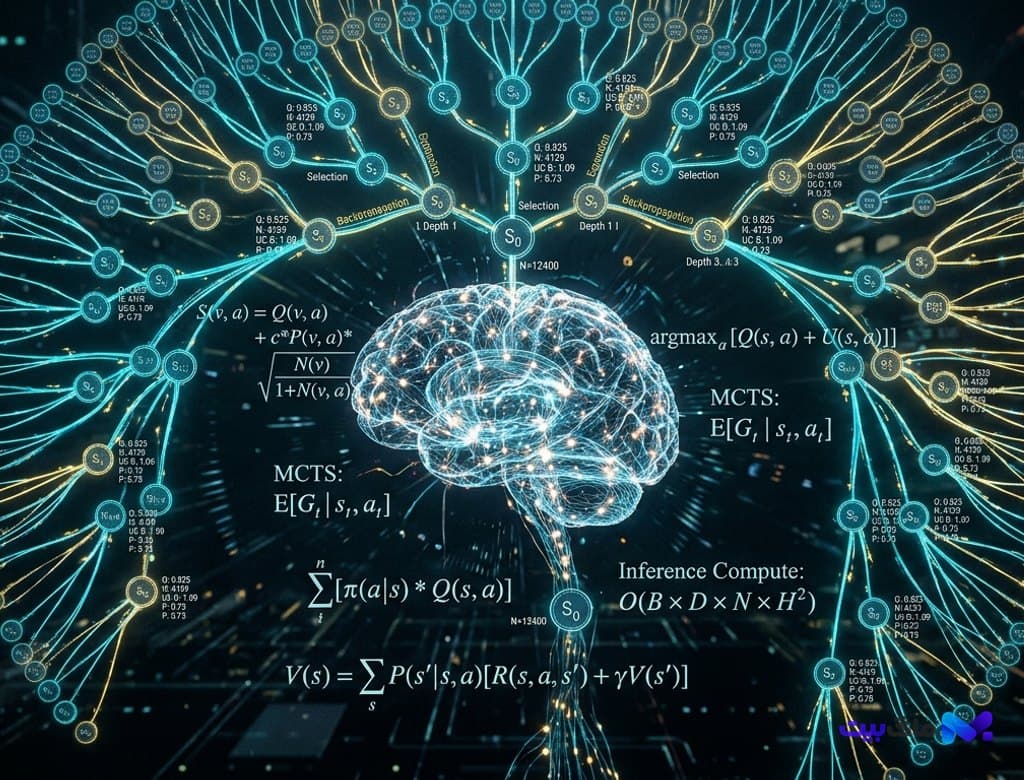
- واکاوی عمیق دگرگونی بنیادین در معماری هوش مصنوعی با ظهور مقیاسپذیری محاسبات در زمان استنتاج (Test-Time Compute) امروزه بررسی عبور صنعت از قانون چنچیلا (Chinchilla Laws) به سوی مدلهای بهینه استنتاج، تلفیق زنجیره افکار عمیق (Deep CoT)، مدلهای پاداش فرآیندمحور (PRM) و الگوریتمهای جستجوی درخت مونتکارلو (MCTS) برای حل مسائل پیچیده استدلالی و بازتولید عاملیتهای شناختی بدون نیاز به کلاسترهای فوقسنگین پیشآموزش.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران تکبعدی پیشآموزش؛ ظهور قانون دوم مقیاسپذیری در استنتاج
برای بیش از نیم دهه، باور رایج در محافل یادگیری ماشین این بود که تنها کلید دستیابی به هوش برتر، افزایش ابعاد پارامترهای مدل و تزریق تریلیونها توکن متنی در مرحله پیشآموزش (Pre-training) بر اساس قوانین شناختهشده کاپلان و چنچیلا است. با این حال، در آستانه دوران کنونی صنعت هوش مصنوعی به یک دیوار فیزیکی و دادهای برخورد کرد: پایان متون باکیفیت انسانی وب، هزینههای میلیارد دلاری برق دیتاسنترها و نرخ بازگشت نزولی عملکرد مدلهای فوقبزرگ چندصدمیلیارد پارامتری.
نقطه عطف تاریخی دوران کنونی با رونمایی از پارادایم «مقیاسپذیری محاسبات در زمان استنتاج» (Test-Time Compute Scaling) رقم خورد. در این رویکرد انقلابی، مدل دیگر مجبور نیست پاسخی آنی و تکمرحلهای بر اساس توزیع آماری کلمات تولید کند؛ بلکه به آن «زمان برای اندیشیدن» (Inference-Time Budget) اعطا میشود. مدل میتواند صدها تا هزاران توکن درونی تولید کند، فرضیههای مختلف را بسنجد، شاخههای اشتباه را هرس نماید و پیش از ارائه پاسخ نهایی، تناقضات استدلالی خود را تصحیح کند.
همانطور که در واکاوی معماری مدلهای حافظه عمیق تایتانز و حافظه عصبی ماندگار تشریح شد، نگهداری زمینه و پردازش متوالی نیازمند ساختاری پویاست. مقیاسپذیری در زمان استنتاج دقیقا مکمل این تحول است و به یک مدل فشرده و کارآمد با ۱۰ تا ۲۰ میلیارد پارامتر اجازه میدهد در آزمونهای دشوار المپیاد ریاضی، رمزنگاری و سنتز کد، از مدلهای عظیم الجثه فاقد تفکر درونی پیشی بگیرد.
کالبدشناسی استدلال عمیق؛ تلفیق PRM، زنجیره افکار و الگوریتمهای جستجوی درختی
معماری سیستمهای استدلال عمیق امروزه بر سه پایه الگوریتمی استوار است که ساختار فرآیند تصمیمگیری هوش مصنوعی را دگرگون ساختهاند. پایه نخست، زنجیره افکار پنهان (Hidden Chain-of-Thought) است. در این لایه، توکنهای تفکر به عنوان گامهای شناختی عمل میکنند و کاربر بدون درگیر شدن با نویزهای استدلالی، تنها برونداد اعتبارسنجیشده نهایی را مشاهده مینماید.
رکن دوم و حیاتی، استفاده از «مدلهای پاداش فرآیندمحور» (Process-based Reward Models یا PRM) است. تا پیش از این، مدلهای سنتی مبتنی بر یادگیری تقویتی از بازخورد انسانی (RLHF) از مدلهای پاداش نتیجهمحور (Outcome-based Reward Models) استفاده میکردند که صرفاً درست یا غلط بودن پاسخ نهایی را بررسی میکردند. این امر باعث میشد مدلی که با استدلال کاملاً غلط و بر حسب تصادف به جواب درست رسیده بود، پاداش دریافت کند! در مقابل، مدلهای PRM امروزه هر خط استدلال و هر گزاره ریاضی یا منطقی را به صورت مستقل ارزیابی میکنند و به مدل اجازه میدهند نقطه دقیق بروز خطا را شناسایی کند.
رکن سوم، پیادهسازی الگوریتمهای هدایتشده جستجوی درخت مونتکارلو (Monte Carlo Tree Search - MCTS) و جستجوی پرتوئی تطبیقی (Beam Search) در فضای حالت تفکر است. مدل در هر مرحله چندین مسیر احتمالی را شبیهسازی میکند؛ اگر امتیازبندی PRM نشان دهد که یک شاخه استدلالی به بنبست یا استنتاج موهوم (Hallucination) ختم میشود، مدل فوراً مسیر را ترک کرده و به گره والد بازمیگردد (Backtracking).
این فرآیند شبیهسازی و اعتبارسنجی بلادرنگ، نیازمند سامانههای ابری با تأخیر فوقپایین است که در مقاله سیستمهای توزیعشده و رصدپذیری بلادرنگ با eBPF به طور کامل بررسی شده است. این همگرایی زیرساختی به مدلها امکان میدهد به صورت خودکار ابزارهای خارجی مانند مفسرهای پایتون و اثباتکنندههای قضایای ریاضی (Lean 4) را فراخوانی کرده و استدلال خود را در لحظه محک بزنند.
اقتصاد استنتاج؛ چرا شرکتهای فناوری بودجه محاسباتی را تغییر دادند؟
از دیدگاه اقتصاد مهندسی، آموزش یک مدل پرچمدار چندصد میلیارد پارامتری در سالهای گذشته هزینهای بالغ بر صدها میلیون دلار و چندین ماه مصرف مداوم برق را تحمیل میکرد. اما این مدل پس از آموزش، برای یک پرامپت ساده سلام و احوالپرسی همان میزان محاسبات سنگین را اجرا میکرد که برای اثبات یک قضیه پیچیده مکانیک کوانتومی صرف مینمود!
پارادایم مقیاسپذیری زمان استنتاج، انعطافپذیری اقتصادی بیسابقهای به ارمغان آورده است. سیستم اکنون میتواند دشواری پرامپت را تشخیص دهد (Task Difficulty Classifier): برای پرسشهای پیشپاافتاده، مدل بودجه تفکر را روی صفر تنظیم کرده و پاسخی سریع با تاخیر ۵۰ میلیثانیه تحویل میدهد. اما برای وظایف خطیر مهندسی، تحلیل مالی یا باگیابی کدبیسهای چند ده هزار خطی، سیستم بودجه تفکر را تا چند دقیقه محاسبات موازی افزایش میدهد.
این استراتژی نه تنها مصرف انرژی کلی دیتاسنترها را تا ۶۰ درصد بهینهسازی کرده، بلکه دروازه استقرار هوش استدلالگر روی دستگاههای لبه (Edge Devices) را باز نموده است. هنگامی که یک پردازنده محلی در کنار حسگرهای بینایی نورومورفیک و دوربینهای مبتنی بر رخداد قرار میگیرد، میتواند تصمیمگیریهای حیاتی را بدون اتکا به سرورهای ابری با دقت استدلالی بالا اتخاذ کند.
معرفی ابزارها و فریمورکهای مدرن استدلال زمان استنتاج امروزه
برای مهندسان هوش مصنوعی و توسعهدهندگان، تسلط بر ابزارهای نوین ارکستراسیون تفکر الزامی است. امروزه کتابخانهها و پلتفرمهای تخصصی متعددی برای پیادهسازی این پارادایم به بلوغ رسیدهاند:
۱. فریمورک Search-o-Matic: کتابخانه متنباز پایتون که پروتکلهای جستجوی درختی (MCTS و A*) را مستقیماً روی مدلهای منبعبازی چون Llama-3.3 و Qwen-2.5-Coder سوار میکند و ارزیابی گامبهگام PRM را روی کلاسترهای GPU توزیع مینماید.
۲. پایپلاینهای Lean-CoT Verifier: سامانهای یکپارچه که کدهای اثبات صوری زبان Lean 4 و پلتفرمهای آزمایش خودکار کد را با مراحل تفکر مدل گره میزند تا از عدم وجود باگ منطقی در کدها اطمینان حاصل شود؛ ابزاری که در عاملهای خودمختار مهندسی نرمافزار و معماری استدلال درختی نقش ستون فقرات تولید نرمافزار را ایفا میکند.
۳. سیستمهای خودانعکاسی Reflexion-v3: ابزاری سبک برای ارزیابی حافظه رویدادی و ثبت خطاهای پیشین مدل در حین حل مسئله، که با ایجاد حلقههای نقد خودکار (Critique Loops) مانع از چرخشهای باطل در درخت استدلال میگردد.
چشمانداز و آینده؛ گام بزرگ به سوی مدلهای علمی خودمختار
تحریریه تخصصی ماگ بیت بر این باور است که مقیاسپذیری در زمان استنتاج، مرز میان «تولید محتوای متنی روان» و «اکتشافات بنیادین علمی» را شکسته است. دیگر نیازی نیست منتظر انتشار مدلهای تریلیون پارامتری باشیم؛ هوش مصنوعی امروز با عمیقتر اندیشیدن، میتواند فرضیههای دارویی جدید تدوین کند، مقالات علمی پیچیده را نقادی نماید و پدیدههای فیزیکی ناشناخته را مدلسازی کند.
جهان فناوری امروزه شاهد تولد عصری است که در آن «کیفیت اندیشیدن» بر «حجم حافظه» برتری یافته است و توسعهدهندگانی که بتوانند موتورهای جستجوی شناختی را با زیرساختهای مهندسی نوین ترکیب کنند، پیشگامان موج بعدی انقلاب هوش مصنوعی خواهند بود.
بیشتر از هوش مصنوعی



