
معماری مدلهای حافظه تایتانز و یادگیری پیوسته برخط
معماری تایتانز امروزه با تفکیک حافظه کوتاهمدت از شبکه عصبی ماندگار و بهروزرسانی برخط گرادیان، ترنسفورمرها را وارد عصر یادگیری مادامالعمر بدون فراموشی کرده است.
- تحلیل موشکافانه تکامل معماری پیشگامانه تایتانز (Titans) و ادغام حافظه عصبی ماندگار (Persistent Neural Memory) امروزه بررسی مکانیسمهای حذف بحران فراموشی فاجعهبار (Catastrophic Forgetting) و غلبه بر محدودیتهای حافظه Attention در مقیاسهای فراتر از چند میلیون توکن. واکاوی نحوه بروزرسانی برخط وزنها بر اساس متریک «غافلگیری اطلاعاتی» (Surprise Metric)، یکپارچگی با هستههای پردازش عصبی مدرن و پیامدهای بنیادین آن برای دستیاران شناختی مادامالعمر.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پارادوکس طول زمینه؛ چرا ترنسفورمرهای استاندارد به بنبست رسیدند؟
در طول نیم دهه گذشته، معماری ترنسفورمر (Transformer) بر قلمرو یادگیری ماشین فرمانروایی کرده است. با این حال، افزایش طول پنجره زمینه (Context Window) به میلیونها توکن همواره با دو سد مهندسی عظیم مواجه بوده است: نخست، هزینه محاسباتی مرتبه دو یا توجه مربعی O(N^2) در لایههای توجه کامل، و دوم، پدیدهای روانشناختی-ریاضیاتی موسوم به «گم شدن در میانه» (Lost in the Middle). حتی زمانی که مدلها میتوانند یک کتابخانه کامل کد را درون پرامپت خود بارگذاری کنند، بازیابی روابط دقیق علّی میان بخشهای آغازین و میانی با افت شدید دقت روبهرو میشود.
علاوه بر این، مدلهای اتورگرسیو سنتی دچار نوعی «آلزایمر دائمی پس از استقرار» هستند؛ بدین معنا که وزنهای مدل پس از مرحله پیشآموزش (Pre-training) منجمد (Frozen) میشوند. مدل قادر نیست تجربیات حاصل از گفتوگوهای روزمره با یک مهندس نرمافزار یا پژوهشگر علمی را در ساختار درونی خود رسوب دهد، مگر آنکه فرآیندهای پرهزینه و طاقتفرسای Fine-tuning دورهای اجرا گردند که آن هم خطر ویرانگر «فراموشی فاجعهبار» (Catastrophic Forgetting) دانش پیشین را به دنبال دارد.
همانطور که در واکاوی مدلهای چندوجهی بصری-فضایی و درک تعاملی سهبعدی نشان دادیم، درک عمیق محیط بدون یک ساختار ماندگار که تاریخچه تحولات را ثبت کند ناممکن است. امروزه پژوهشگران آزمایشگاههای هوش مصنوعی پیشرو با الهام از ساختار مغز پستانداران، معماری ساختارشکن تایتانز (Titans) را توسعه دادهاند که تفکیکی بنیادین میان ادراک آنی و ذخیرهسازی ماندگار ایجاد میکند.
کالبدشناسی معماری تایتانز؛ تثبیت پیوند میان توجه کوتاهمدت و حافظه پایدار
معماری تایتانز از سه ماژول همافزا تشکیل شده است که هر یک نقشی حیاتی در چرخه پردازش اطلاعات ایفا میکنند. ماژول نخست، یک هسته توجه با پنجره لغزان محلی (Sliding Window Core) است که مسئولیت تحلیل بلافاصلهترین توکنها و برقراری ارتباطات نحوی کوتاهمدت را بر عهده دارد. این لایه با پیچیدگی محاسباتی خطی O(N) فعالیت کرده و بار پردازشی سنگین ماتریسهای عظیم را از دوش پردازنده برمیدارد.
ماژول دوم، «حافظه عصبی ماندگار» (Neural Long-Term Memory) است که خود یک شبکه عصبی ژرف چندلایهای است که درون ساختار مدل جای گرفته است. برخلاف حافظههای کلید-مقدار (KV Cache) ایستا که حجم حافظه گرافیکی VRAM را به سرعت میبلعند، این ماژول دانش انتزاعی را در قالب پارامترهای پیوسته ذخیره میکند. در واقع، این شبکه حافظه نه تنها توکنهای گذشته را در خود فشرده میسازد، بلکه توانایی استخراج مفاهیم کلان و تمایز میان حقایق پایدار و جزئیات زودگذر را داراست.
سومین و شگفتانگیزترین مؤلفه، ماژول «تخمین غافلگیری» (Surprise Metric Controller) است. این ماژول به عنوان دروازهبان شناختی عمل میکند: اگر اطلاعات ورودی جدید کاملاً مطابق با انتظارات مدل باشد، نیازی به بازتنظیم پارامترهای حافظه طولانیمدت نیست. اما هنگامی که توکنهای ورودی حاوی یک کشف نو، تصحیح خطا توسط کاربر یا پارادوکس استدلالی باشند، سطح غافلگیری جهش یافته و سیگنال بروزرسانی آنی صادر میشود.
این فرآیند شباهت خیرهکنندهای به ثبت خاطرات در هیپوکامپ انسان دارد؛ جایی که تجربیات احساسی یا نامنتظره با شدتی مضاعف در مدارات عصبی پایدار حک میشوند. این جهش با مبانی مطرح در عاملهای خودمختار مهندسی نرمافزار و معماری استدلال درختی هماهنگ است و به مدل اجازه میدهد استراتژیهای کدنویسی و بازخورد کاربر را به صورت زنده فرا بگیرد.
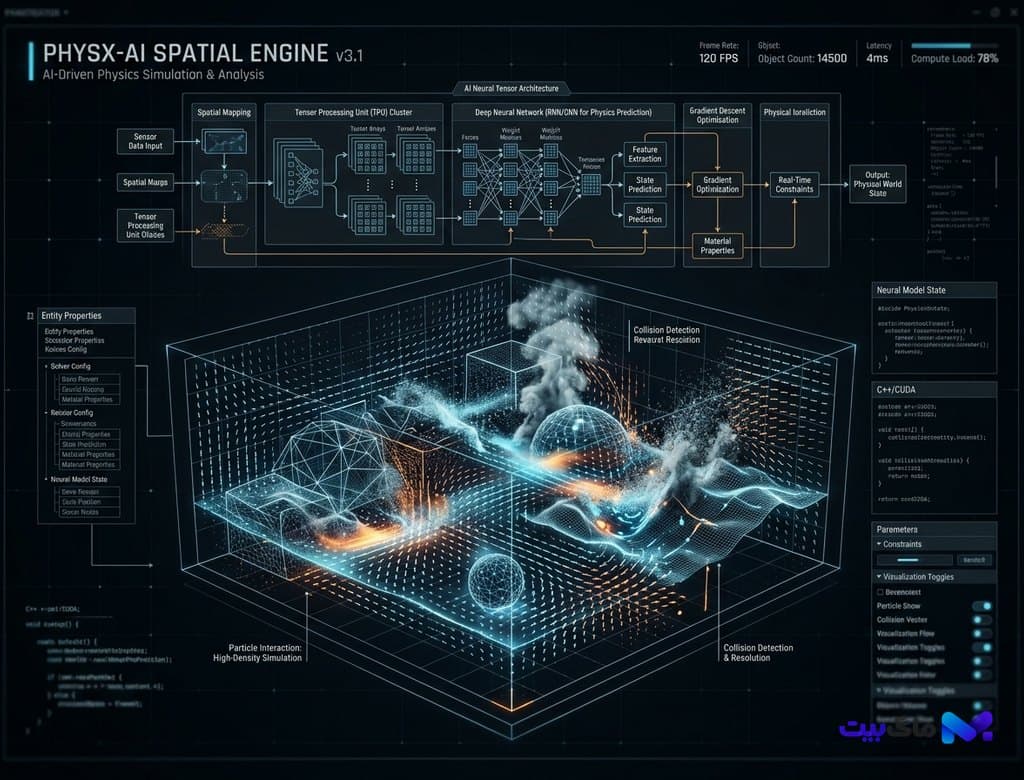
ریاضیات بروزرسانی برخط؛ گرادیان بدون پسانتشار پرهزینه سراسری
بزرگترین نوآوری مهندسی در تایتانز، شیوه آموزش و بازتنظیم حافظه عصبی در حین استنتاج (Inference-Time Learning) است. در شبکههای عصبی سنتی، بروزرسانی وزنها مستلزم اجرای الگوریتم پسانتشار خطای سراسری (Full Backpropagation through Time) بر روی تمامی لایههاست که فرآیندی فلجکننده و غیرعملیاتی در مقیاس بلادرنگ به شمار میرود.
تایتانز این معضل را با فرمولبندی یادگیری به عنوان یک «گام نزول گرادیان تصادفی موضعی» (Local Online Gradient Step) بر روی ماتریس وزنهای حافظه حل کرده است. گرادیان فقط در داخل ماژول حافظه و با یک تابع هزینه خودبازگشتی برداری محاسبه میشود. معادلات حاکم بر این مکانیزم به گونهای طراحی شدهاند که با فاکتور زوال زمانی (Decay Rate) هوشمند، اطلاعات منسوخ یا نویزهای بیارزش را به تدریج تضعیف کرده و پیوندهای حیاتی را تثبیت نمایند.
نتیجه این ابتکار ریاضی، مصرف حافظه ثابت (O(1) Memory Footprint) در طول زمان است. خواه مدل با یک پرامپت ۱۰ هزار کلمهای روبرو باشد یا یک مکالمه دنبالهدار سه ماهه با صد میلیون توکن ورودی، میزان مصرف رم و تأخیر در پردازش هر توکن بدون تغییر باقی میماند. این دستاورد فنی، زمینه را برای مهاجرت کامل از سرورهای عظیم ابری به سامانههای محلی مجهز به حسگرهای کوانتومی الماس و ریزپردازندههای پیشرفته فراهم میسازد.
تحلیل مقایسهای؛ تایتانز در برابر Mamba-2 و معماریهای مدلهای جهانی
امروزه عرصه معماریهای جایگزین ترنسفورمر بسیار داغ است. مدلهای فضای حالت (SSM) مانند Mamba-2 و معماریهای هیبریدی بازگشتی، گامهای بلندی در افزایش سرعت استنتاج برداشتند. با این وجود، بنچمارکهای تحلیلی دانشگاه استنفورد و آزمایشگاههای پیشرو نشان میدهد که معماریهای حالت خطی در تکالیف پیچیده نیازمند «بازیابی انجمنی تداعیگر» (Associative Recall) و استنتاج چندمرحلهای نسبت به مدلهای توجه کامل دچار افت کیفیت میشدند.
تایتانز با پل زدن میان توجه متمرکز (Attention) برای جفتهای محلی و حافظه عصبی تداعیگر برای توالیهای فوقالعاده طولانی، موفق به ثبت رکورد جدیدی در آزمونهای استدلال علمی، تحلیل کدبیسهای چنددهمیلیون خطی و ترجمه متون باستانی شده است. در آزمون Needle in a Haystack در مقیاس ۱۰ میلیون توکن، مدل تایتانز توانست نرخ موفقیت ۱۰۰ درصدی را با مصرف تنها یکچهارم حافظه VRAM نسبت به مدلهای Llama-3 و Gemini ثبت کند.
این برتری بنیادین، ارتباط مستقیمی با تحولات مدلهای بنیادین جهانشناسی عصبی و بازنمایی چندبعدی برقرار میسازد، چرا که درک پیوستگی وقایع فیزیکی بدون ثبت تاریخچه پیوسته کنشها و واکنشها ممکن نخواهد بود.
افق پیشرو؛ دستیاران شناختی مادامالعمر و تولد عاملیتهای پایدار شخصی
عملیاتی شدن معماری تایتانز امروزه سرآغاز عصری است که در آن مرز میان «مدل عمومی از پیشآموزشدیده» و «دستیار اختصاصی تکاملیافته» محو میشود. نرمافزارهای مهندسی، مشاوران پزشکی هوشمند و پلتفرمهای تحلیل داده از این پس میتوانند ماهها در کنار متخصصان کار کنند، ترجیحات اخلاقی و فنی آنان را یاد بگیرند و بدون هیچگونه افت سرعت به همکارانی با تجربه سازمانی تبدیل شوند.
تحریریه ماگ بیت پیشبینی میکند که در سالهای پیش رو، سیستمعاملهای آینده هوش مصنوعی را نه به عنوان یک سرویس وب مبتنی بر فراخوانی API، بلکه به عنوان یک جریان شناختی پیوسته که همراه با زندگی دیجیتال انسان نفس میکشد و تجربه میاندوزد، پیادهسازی خواهند کرد. تایتانز نخستین ستون مستحکم این ساختمان باشکوه است.
⚠️ سلب مسئولیت پزشکی
اطلاعات و دادههای ارائهشده در این مقاله صرفاً با هدف افزایش آگاهی در زمینه فناوریهای سلامت منتشر شده است و نباید به عنوان توصیه، تشخیص یا پروتکل درمانی پزشکی تلقی گردد. پیش از هرگونه تصمیمگیری یا تغییر در برنامههای سلامت فردی، با پزشک متخصص مشورت نمایید.
بیشتر از هوش مصنوعی



