
مدلهای چندوجهی بصری-فضایی و درک تعاملی سهبعدی
با استقرار مدلهای چندوجهی بصری-فضایی امروزه عاملهای هوش مصنوعی توانستهاند هندسه پیوسته دنیای واقعی را درک کرده و با دقت میلیمتری در محیطهای سهبعدی به تعامل فیزیکی بپردازند.
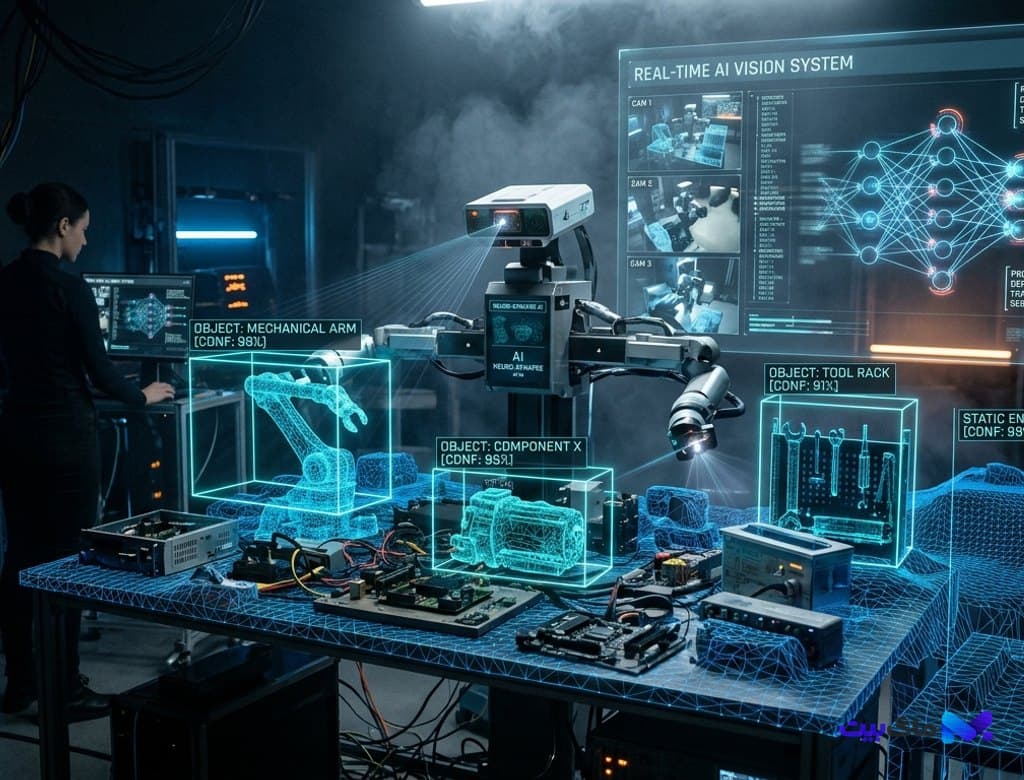
- تحلیل عمیق تکامل مدلهای زبانی-دیداری فضایی (Spatial Vision-Language Models) امروزه بررسی معماریهای ادغام ابر نقاط لایدار، رندرهای Gaussian Splatting سهبعدی و گرافهای صحنه معنایی (Semantic Scene Graphs) در سامانههای عاملمحور. نحوه بازشناسی هندسی اشیا، تعاملات بلادرنگ در لبه پردازشی (Edge Inference) و پیادهسازی نسل نوین ابزارهای Gemini 2.5 Spatial، Apple Spatial Intelligence و Nvidia Isaac Sim در روباتیک پیشرفته.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
عبور از پیکسلهای دوبعدی؛ ضرورت درک فضایی پیوسته در هوش مصنوعی
در سالهای آغازین توسعه مدلهای بزرگ چندوجهی (VLMs)، سیستمهای بینایی ماشین عمدتاً متکی بر ماتریسهای پیکسلی مسطح دوبعدی بودند. اگرچه این مدلها در نامگذاری اشیاء، استخراج متن (OCR) و تحلیل محتوای تصاویر ایستا شاهکارهایی شگفتانگیز آفریدند، اما به محض قرارگیری در محیطهای تعاملی دنیای واقعی با چالشی بنیادین به نام «فقدان عمق و هندسه فیزیکی» روبرو شدند. هوش مصنوعی بدون درک فاصله، حجم، جهتگیری اقلیدسی و پایداری گرانشی، قادر به انجام کارهای سادهای نظیر برداشتن یک لیوان شیشهای یا گریز از مانع متحرک نبود.
💡 **پیشنیاز مطالعه:** برای درک بهتر این مقاله تخصصی، پیشنهاد میشود ابتدا مقاله پایهای VLM چیست و چگونه کار میکند؟ را مطالعه نمایید.
همانطور که در بررسی پیشین تحریریه ماگ بیت پیرامون عاملهای خودمختار مهندسی نرمافزار و استدلال درختی یادآور شدیم، حل مسائل بغرنج نیازمند جستجو در فضای حالت و استدلال بازگشتی است. امروزه این مفهوم در قلمرو فیزیکی به بلوغ رسیده و «مدلهای بصری-فضایی» (Spatial VLMs) متولد شدهاند؛ ساختارهایی که به جای برچسبگذاری سطحی، صحنه را به شکل یک میدان تابعی چندبعدی با خواص فیزیکی و روابط مکانی زنده بازآفرینی میکنند.
این جهش پارادایمی ارتباطی ناگسستنی با مفاهیم مدلهای بنیادین جهانشناسی عصبی و هوش فضایی دارد؛ جایی که عامل هوشمند نه تنها ساختار فعلی صحنه را میسنجد، بلکه اثر نیروها و پیامد جابهجایی اشیا را در فضای سهبعدی پیشبینی میکند.
معماری تلفیقی؛ همگرایی ابر نقاط، گاوسی اسپلش سهبعدی و گرافهای معنایی
ستون فقرات مدلهای Spatial VLM دوران کنونی بر یک معماری ترکیبی سهلایه استوار است. لایه نخست، اطلاعات هندسی خام را از منابع چندحسگری دریافت میکند؛ حسگرهای رادار نوری لایدار، دوربینهای استریو با عمقسنجی فوتونی و واحدهای اندازهگیری اینرسی (IMU) به طور همزمان دادههای ورودی را تشکیل میدهند. این دادهها بلافاصله به بازنماییهای پرسرعت بر پایه «اسپلتینگ گاوسی سهبعدی» (3D Gaussian Splatting) تبدیل میشوند که امکان رندر آنی و برآورد پیوسته سطوح بدون افت وضوح را میسر میسازد.
لایه دوم، یک ماژول تبدیل تانسوری فضایی است که توکنهای متنی و پرسشهای طبیعی کاربر (نظیر «جعبه ابزار فلزی پشت مانیتور را بردار») را به مختصات فضایی مقید (Bounding Volumes) و توابع پتانسیل حرکتی متصل میسازد. در این مرحله، الگوریتم یک «گراف صحنه معنایی» (Semantic Scene Graph) پویا ایجاد میکند که در آن هر شیء به عنوان یک رأس با ویژگیهایی نظیر وزن تقریبی، شکنندگی و ضریب اصطکاک شناخته شده و یالها روابطی مانند «قرارگیری روی»، «درون» یا «پشت» را کدگذاری میکنند.
در لایه سوم، مدل با اجرای استنتاج برداری، مسیر حرکتی بهینه و گشتاور مورد نیاز بازوی روباتیک را تعیین مینماید. چنین محاسبات سنگینی تنها با تکیه بر زیرساختهای سختافزاری مدرن امکانپذیر شده است؛ دستاوردی که در بررسی انقلاب لپتاپهای ARM و پردازندههای عصبی یکپارچه نیز به عنوان کلید گذار به پردازش آفلاین محلی مورد تأکید قرار گرفته است.
ابزارهای شاخص دوران کنونی پیشتازی پلتفرمهای Gemini Spatial و Nvidia Isaac
در بعد صنعتی و نرمافزاری، ماههای اخیر شاهد ظهور چارچوبهای استانداردشدهای برای استقرار این مدلها در رباتیک کارخانهای، عینکهای هوشمند و اتاقهای جراحی بودهایم. پلتفرم Gemini 2.5 Spatial گوگل با پشتیبانی بومی از مختصات ششدرجه آزادی (6DoF) به توسعهدهندگان اجازه میدهد رابطهای تعاملی را در فضای اقلیدسی بازتعریف کنند. همچنین کیتهای توسعه Apple Spatial Intelligence با ادغام در سختافزارهای مجهز به اسکنر لایدار، نقشه اتاق و مبلمان را در کسری از ثانیه با دقت سانتیمتری استخراج مینمایند.
از سوی دیگر، شرکت انویدیا با بهروزرسانی زیرساخت شبیهسازی Isaac Sim و موتور ادراک Nova Carter، امکان آموزش عاملهای خودران را در محیطهای فیزیکی دوقلوی دیجیتال (Digital Twins) با نرخ شتابدهی هزار برابری فراهم کرده است. روباتهای مجهز به این فناوری پیش از مواجهه با دنیای واقعی، میلیونها سناریوی برداشتن اشیای لغزنده و پرهیز از برخوردهای غیرمنتظره را در شبیهساز پشت سر میگذارند.
این ادغام فناورانه مستقیماً در صنایع حملونقل هوشمند و نسل چهارم رادارهای نوری حالت جامد و خودروهای خودران کاربرد دارد، زیرا وسایل نقلیه سطح ۴ نیازمند درک بیدرنگ موانع پنهان و الگوهای ترافیکی در سطوح سهبعدی هستند.
غلبه بر محدودیت تأخیر در لبه؛ تروتلینگ تانسوری و مدلهای سبک VLA
یکی از گلوگاههای تاریخی در عملیاتیسازی مدلهای بینایی-فضایی، حجم سرسامآور محاسبات و وابستگی به پردازش ابری بود. یک ربات انباردار یا پهپاد امدادرسان نمیتواند منتظر ارسال گیگابایتها داده سهبعدی به دیتاسنترهای راه دور و دریافت پاسخ بماند، چرا که حتی تاخیر پنجاه میلیثانیهای در سرعتهای بالا به معنای سقوط یا برخورد با دیواره است.
راهکار دوران کنونی برای این چالش، بهرهگیری از تکنیکهای تقطیر دانش (Knowledge Distillation) و هرس تانسوری بر پایه توجه متمرکز بر عمق است. با پیادهسازی مدلهای دیداری-حرکتی سبک (VLA - Vision-Language-Action) با کمتر از ۳ میلیارد پارامتر بر روی شتابدهندههای NPU کممصرف، نرخ بازخوانی و تصمیمگیری به بیش از ۶۰ فریم بر ثانیه (۶۰ هرتز) رسیده است. این یعنی روباتها میتوانند واکنشهای محافظتی و بازتنظیم مسیر را با سرعتی همتراز با رفلکسهای بیولوژیکی انسان به انجام رسانند.
افق پیشرو؛ پیامدهای تجسد هوش در صنایع و زندگی روزمره
دوران کنونی را میتوان نقطه عطف تاریخ هوش مصنوعی دانست؛ برههای که در آن هوش ماشینی از محفظه نمایشگرهای شیشهای و چتباتهای متنی بیرون آمده و جسمیت فیزیکی یافته است. تلفیق استدلال زبانی با درک عمیق سهبعدی، روباتهای خدمتکار خانگی، بازوهای صنعتی همکار (Cobots) و ابزارهای توانبخشی معلولان را به دستیارانی بصیر و انعطافپذیر تبدیل کرده است.
تحریریه ماگ بیت بر این باور است که گام بعدی در این مسیر، ادغام دادههای حس بساوایی (Tactile Sensing) و بازخورد نیرو در مدلهای Spatial VLM خواهد بود. زمانی که یک هوش مصنوعی بتواند جهان را همانند یک انسان بالغ ببیند، عمق آن را احساس کند و نرمی یا زبری سطوح را لمس نماید، مرز میان ماده و هوش فرو ریخته و تمدن بشری وارد عصر شگفتانگیز همکاری مستقیم انسان و ربات خواهد شد.
بیشتر از هوش مصنوعی



