
VLM چیست؟ راهنمای کامل مدلهای بینایی-زبانی (Vision-Language Models) در هوش مصنوعی؛ کالبدشکافی معماری ViT، اتصال به LLM و مقایسه GPT-4o، کلود ۳.۵ و جمنای
VLM چیست و چگونه کار میکند؟ راهنمای جامع معماری مدلهای Vision-Language، تفاوت با LLM، نقش پروژکتور بینایی، بنچمارکها و مقایسه GPT-4o، کلود ۳.۵ و جمنای.
- مدلهای بینایی-زبانی یا VLM (کوتاهشدهی Vision-Language Models) دستهای نوین و انقلابی از شبکههای عصبی چندوجهی در هوش مصنوعی هستند که توانایی درک همزمان و استدلال روی محتوای بصری (تصاویر، دیاگرامها، فیلمها) و زبان طبیعی (متن) را دارند. یک VLM بر خلاف مدلهای زبانی صرف (LLM) که تنها با متن سر و کار دارند، میتواند اشیاء داخل تصویر را شناسایی کند، روابط مکانی و متنی را بسنجد، جداول و نمودارهای پیچیده را تحلیل کرده و به سوالات استدلالی کاربر پاسخ دهد. این مدلها از طریق تلفیق یک انکودر بینایی (معمولاً Vision Transformer یا ViT)، یک لایه پروژکتور نگاشت (MLP Connector) و یک مدل زبانی بزرگ خودبازگشتی ساخته میشوند و اساس سیستمهایی نظیر GPT-4o، کلود ۳.۵ سونیک و جمنای ۱.۵ را تشکیل میدهند.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
VLM چیست؟ پاسخ مستقیم و علمی به نسل جدید هوش مصنوعی چندوجهی
اگر مدلهای زبانی بزرگ (LLM) نظیر نسخههای اولیه چتجیپیتی را مغزهایی بسیار باهوش اما «نابینا» تصور کنیم که جهان را صرفاً از طریق توالی کلمات متنی درک میکردند، **مدلهای بینایی-زبانی یا VLM (مخفف Vision-Language Models)** چشمهای این مغز متفکر هستند. VLM کلاسی پیشرفته از معماریهای یادگیری عمیق است که دو ورودی ناهمگون—یعنی پیکسلهای نوری تصویر و توکنهای متنی زبان طبیعی—را در یک فضای برداری مشترک (Shared Latent Space) ترکیب میکند.
به زبان ساده، یک VLM نه تنها به شما میگوید درون یک عکس چه چیزهایی وجود دارد، بلکه با اتکا به درک زمینهای، استدلال میکند که آن اشیاء چه معنایی دارند، روابط علّی و معلولی میان آنها چیست، نمودار بورس چه سیگنالی میدهد و حتی شوخی پشت یک میم تصویری پیچیده کجاست. این پارادایم، هوش مصنوعی را از سطح یک سامانه پردازش متن به یک «سامانه ادراکی کامل» ارتقا داده است.
همانگونه که در بررسی تخصصی معماری Spatial VLM و درک سهبعدی در هوش مصنوعی تشریح کردیم، نسل نوین این مدلها حتی از درک دوبعدی مسطح فراتر رفته و به قابلیت تخمین ژرفا، جهتگیری فضایی و قوانین فیزیکی دنیای واقعی مجهز شدهاند.
تفاوت اساسی VLM با LLM و سیستمهای سنتی بینایی ماشین (CNN)
برای درک چرایی ظهور VLM، باید تمایز آن را با دو فناوری پیشین مشخص کنیم: مدلهای زبانی بزرگ (LLM) و شبکههای عصبی پیچشی سنتی (CNN).
مدلهای کلاسیک بینایی ماشین (نظیر معماریهای ResNet یا YOLO) برای وظایف بستهدامنه (Closed-Set Tasks) آموزش میدیدند؛ برای مثال، یک مدل تشخیص چهره فقط انسان را تشخیص میداد و اگر تصویری از یک نمودار ریاضی یا دستنوشته به آن میدادید، عملکردی نداشت. آنها خروجی متنی تولید نمیکردند، بلکه صرفاً جعبههای محدودکننده (Bounding Boxes) یا برچسبهای کلاسی از پیش تعریفشده ارائه میدادند.
در سوی دیگر، LLMها تسلط بینظیری بر گرامر، استدلال کلامی و کدنویسی دارند اما درک ارگانیکی از نور، بافت و فضا ندارند. هنگامی که یک VLM متولد میشود، این دو جهان با یکدیگر پیوند میخورند: توانایی ادراک ادامهدار بینایی ماشین مدرن با قدرت تولیدی و استدلالی نامحدود ترنسفورمرهای زبانی تلفیق میشود.
این پیوند به مدل اجازه میدهد وظایفی را انجام دهد که پیش از این غیرممکن مینمود؛ از جمله استخراج ساختاریافته داده از فاکتورهای خطخطی، راهنمایی گامبهگام جراحی پزشکی از روی تصاویر آندوسکوپی، و اجرای فرمانهای کاربر در هوش مصنوعی عاملمحور انتروپیک و کنترل کامپیوتر توسط Claude 3.5 Sonnet که با مشاهده اسکرینشات دسکتاپ، جایگاه دکمهها را تحلیل کرده و کلیک میکند.
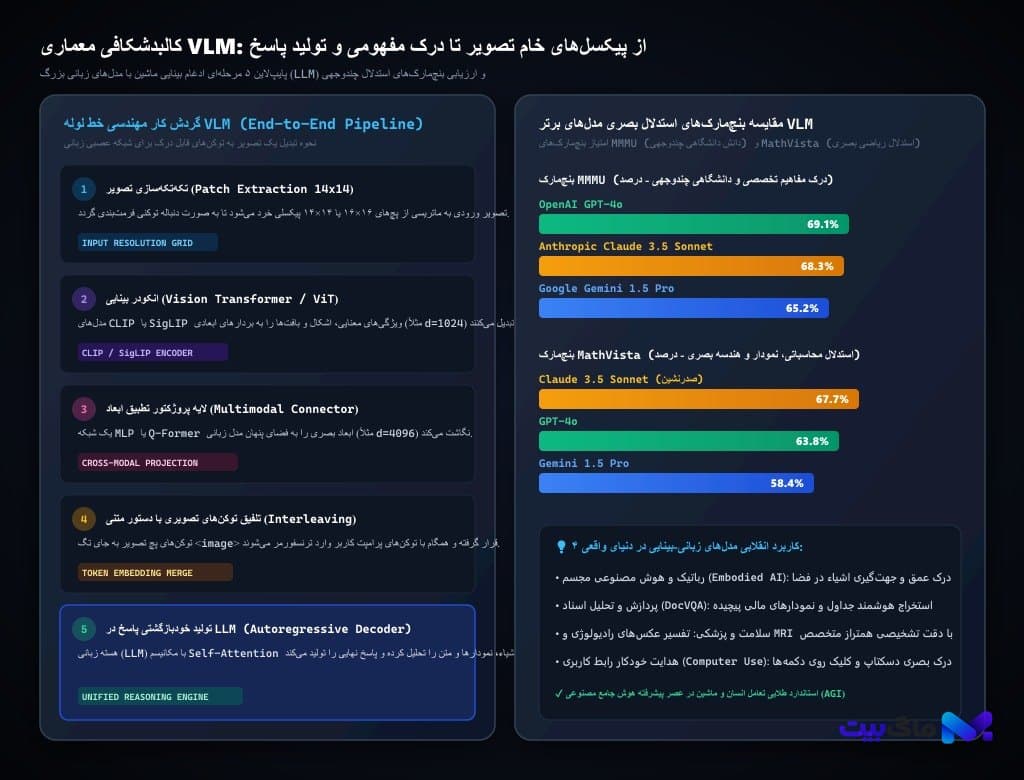
کالبدشکافی معماری خط لوله VLM؛ گردش کار تبدیل پیکسل به معنا
معماری مدرن یک VLM از سه ستون اصلی تشکیل شده است که هماهنگ با یکدیگر کار میکنند:
**۱. انکودر بینایی (Vision Encoder):** نخستین گام، دریافت تصویر با ابعاد مثلاً ۳۳۶×۳۳۶ یا مقیاسهای پویا و خرد کردن آن به شبکهای از پچهای مربعی (معمولاً ۱4×۱۴ یا ۱۶×۱۶ پیکسل) است. سپس این پچها از لایههای ترنسفورمر بینایی (Vision Transformer یا ViT) نظیر شبکههای CLIP یا SigLIP عبور داده میشوند تا نقشه ویژگیهای ادراکی با بردار ابعادی بالا (مثلاً ۱۰۲۴ بعدی) استخراج گردد.
**۲. لایه پروژکتور و نگاشت متقابل (Multimodal Connector / Projector):** این بخش حیاتیترین حلقه مفقوده است. ابعاد بردار خروجی انکودر تصویر (۱۰۲۴) با ابعاد بردار تعبیه توکنهای مدل زبانی (مثلاً ۴۰۹۶ در LLaMA یا Vicuna) همخوانی ندارد. یک شبکه پرسپترون چندلایه (MLP) با توابع فعالسازی غیرخطی یا شبکههای توجه متقابل (Cross-Attention نظیر Q-Former)، بردارهای بصری را به گونهای بازطراحی و فشرده میکند که مدل زبانی بتواند آنها را دقیقاً مانند کلمات متنی «بخواند».
**۳. مدل زبانی بزرگ خودبازگشتی (Decoder-only LLM):** در نهایت، توکنهای بصری تولید شده به جای یک تگ نگهدارنده مانند <image> در توالی پرامپت متنی کاربر قرار میگیرند. مدل زبانی با مکانیسم خودتوجهی (Self-Attention)، روابط متقابل متن سوال کاربر و توکنهای تصویر را سنجیده و به شیوه خودبازگشتی، کلمه به کلمه پاسخ نهایی را تولید میکند.
این فرآیند یکپارچه در سیستمهای پیشرفتهتر، با تکنیکهای استدلال تعمقی پیوند خورده است؛ دقیقاً مشابه آنچه در تحلیل جامع مدل هوش مصنوعی استدلالگر OpenAI o1 بررسی کردیم تا مدل پیش از پاسخدهی به جزئیات بصری، زنجیرهای از افکار پنهان را سپری کند.
جدول مقایسه جامع و بنچمارکهای مدلهای پیشرو VLM
امروزه رقابت شدیدی میان آزمایشگاههای هوش مصنوعی بر سر صدرنشینی در بنچمارکهای چندوجهی در جریان است. دو بنچمارک کلیدی برای سنجش عیار یک VLM عبارتند از **MMMU** (آزمون دانش دانشگاهی چندرشتهای شامل سوالات مصور فیزیک، بیولوژی و هنر) و **MathVista** (حل مسائل پیشرفته ریاضی، هندسه و نموداری مبتنی بر تصویر).
جدول زیر مشخصات فنی و توانمندیهای مدلهای شاخص Vision-Language جهان را خلاصه میکند:
| مدل هوش مصنوعی | شرکت توسعهدهنده | معماری پایه | امتیاز MMMU | امتیاز MathVista | قابلیت کلیدی متمایز |
|---|---|---|---|---|---|
| **Claude 3.5 Sonnet** | Anthropic | Vision Transformer یکپارچه | ۶۸.۳٪ | **۶۷.۷٪** (رتبه ۱) | استدلال ریاضی بصری، نمودارها و هدایت رابط کامپیوتر |
| **GPT-4o** | OpenAI | بومی چندوجهی سرتاسری (Omni) | **۶۹.۱٪** (رتبه ۱) | ۶۳.۸٪ | سرعت پردازش خیرهکننده، صدای همزمان و ورودی ویدیو |
| **Gemini 1.5 Pro** | Mixture of Experts (MoE) | ۶۵.۲٪ | ۵۸.۴٪ | پنجره کانتکست ۲ میلیون توکنی، تحلیل ۱ ساعت فیلم | |
| **LLaVA-NeXT** | جامعه متنباز (Open Source) | CLIP ViT + LLaMA 3 | ۴۸.۶٪ | ۴۵.۱٪ | قابلیت استقرار محلی و شخصیسازی در سازمانها |
| **PaliGemma** | Google Research | SigLIP + Gemma | ۴۵.۳٪ | ۳۸.۷٪ | وزن سبک، مناسب اجرا روی سختافزارهای لبه و موبایل |
همانطور که در جدول مشهود است، کلود ۳.۵ سونیک در استدلالهای منطقی، کدنویسی از روی طرحهای رابط کاربری (UI) و نمودارهای هندسی دست بالا را دارد، در حالی که GPT-4o در گستره وسیع سوالات عمومی و جمنای ۱.۵ در پردازش ویدیوهای طولانی بیرقیب هستند.
کاربردهای تحولآفرین VLM؛ از هوش مصنوعی مجسم تا سلامت دیجیتال
توانایی درک جهان از دریچه نور، کاربردهای VLM را به طیف وسیعی از صنایع حیاتی بسط داده است:
**۱. رباتیک و هوش مصنوعی مجسم (Embodied AI):** رباتهای انساننما و بازوهای صنعتی برای جابجایی ایمن اشیاء در کارخانهها و منازل، نیاز دارند فیزیک و ساختار هندسی محیط را درک کنند. این مدلها به ربات اجازه میدهند دستور کلامی «لیوان آب را بردار و روی میز بگذار» را مستقیماً به نقشه حرکتی سهبعدی تبدیل کند، رویکردی که در تحلیل مدلهای چندوجهی بصری-فضایی و درک تعاملی سهبعدی و مدلهای جهان و درک فیزیک حرکتی نیز بررسی شده است.
**۲. پردازش پیشرفته اسناد (DocVQA):** تحلیل اسناد مالیاتی، صورتهای سود و زیان، نقشههای مهندسی CAD و مقالات علمی که پر از جدولهای تودرتو و ارجاعات تصویری هستند، به لطف VLMها با دقتی نزدیک به انسان اتوماسیون شده است.
**۳. تصویربرداری و تشخیص پزشکی:** مدلهای بینایی-زبانی تخصصی به رادیولوژیستها در تشخیص سریع تودههای مشکوک در تصاویر سیتیاسکن، MRI و ماموگرافی کمک میکنند و پیشنویس گزارشهای بالینی را با ادبیات دقیق پزشکی آماده میسازند.
**۴. دستیارهای صوتی و بینایی برای نابینایان:** ترکیب دوربین عینکهای هوشمند با VLM به افراد کمبینا امکان میدهد جزئیات پیرامون خود، تابلوهای راهنما و اشخاص مقابل را به صورت گفتاری و بلادرنگ درک کنند.
چالشهای کلیدی VLM؛ توهم بصری و محدودیتهای رزولوشن
با وجود تمامی شگفتیها، مدلهای بینایی-زبانی با چالشهای فنی مهمی روبرو هستند:
**توهم بصری (Visual Hallucination):** یکی از شایعترین باگهای VLMها این است که گاهی شیئی را در تصویر توصیف میکنند که اصلاً وجود ندارد، یا جزئیات یک تصویر را بر اساس پیشفرضهای متنی خود جعل مینمایند (مثلاً ادعا میکنند روی میز یک لپتاپ هست، صرفاً به این دلیل که ماگ قهوه را دیدهاند!).
**محدودیت رزولوشن و جزئیات ریز:** خرد کردن تصویر به پچهای پیکسلی به این معناست که جزئیات بسیار کوچک (مثل یک پلاک خودرو در فاصله دور یا یک نقطه ریز در نقشه مدار) ممکن است در فرآیند پچینگ محو شوند. راهکارهای نوین نظیر «برش پویا» (Dynamic High-Resolution Cropping) تلاش میکنند با ارسال پچهای تکمیلی با وضوح بالا، این نقص را مرتفع سازند.
سوالات متداول درباره مدلهای بینایی-زبانی (FAQ)
**۱. تفاوت VLM با LLM در چیست؟** مدل LLM (مانند نسخه متنی GPT-3) فقط دادههای متنی را پردازش و تولید میکند، در حالی که VLM (مانند GPT-4o و Gemini) از ابتدا توانایی درک همزمان تصاویر، نمودارها و ویدیوها را در کنار متن داراست.
**۲. چگونه میتوان از یک VLM در پروژههای برنامهنویسی استفاده کرد؟** از طریق API مدلهای تجاری (نظیر OpenAI API یا Anthropic API با ارسال تصاویر به صورت Base64 یا URL) یا با پیادهسازی مدلهای متنباز نظیر LLaVA، Qwen2-VL و PaliGemma با کتابخانههای Hugging Face Transformers و vLLM.
**۳. آیا VLM میتواند ویدیو را هم پردازش کند؟** بله؛ ویدیوها در حقیقت توالی پیوستهای از فریمهای تصویری در گذر زمان هستند. مدلهای پیشرفته با نمونهبرداری از فریمهای کلیدی (مثلاً ۱ فریم بر ثانیه) و ارسال آنها به انکودر بینایی، میتوانند روند رویدادها را در ویدیو درک و خلاصه کنند.
بیشتر از هوش مصنوعی



