
معماری Spatial VLM و درک سهبعدی در هوش مصنوعی
گذر تاریخی از چتباتهای دوبعدی به مدلهای درک فضایی سهبعدی؛ چگونه Spatial VLMها با ادراک هندسی پیوسته و پردازش ویدیویی بدون تاخیر، بستر انقلاب رباتهای هوشمند و دستیاران فیزیکی را رقم زدند.
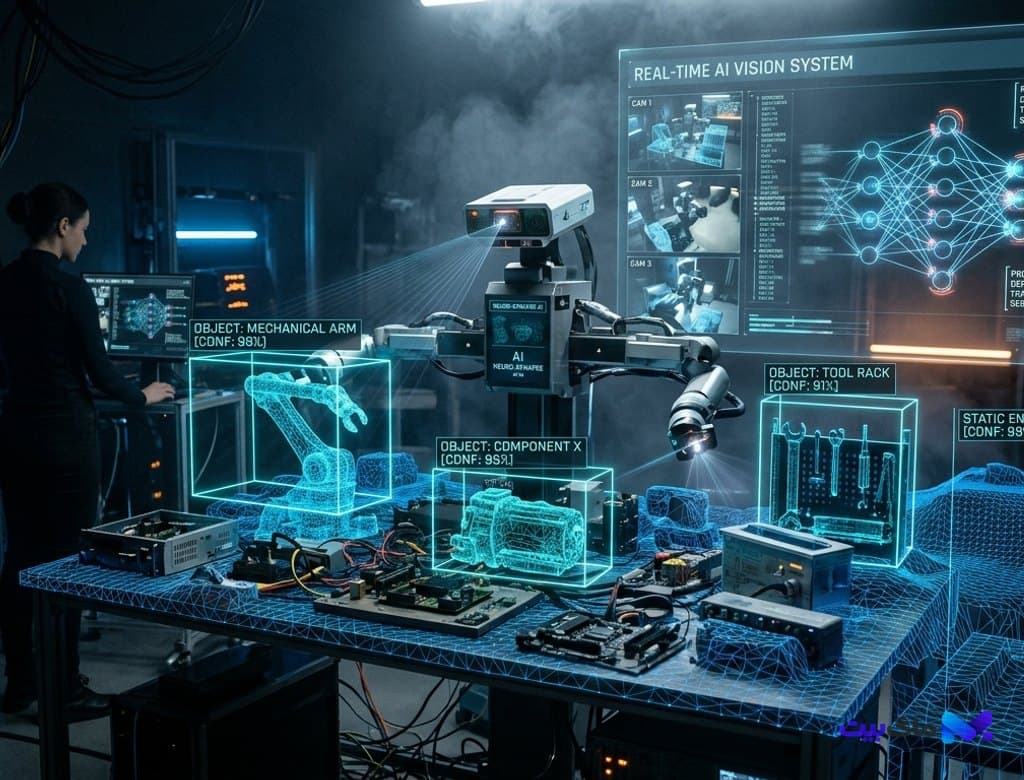
- تحلیل جامع و موشکافانه نسل نوین مدلهای چندوجهی بینایی-زبانی فضایی (Spatial VLMs) امروزه بررسی تحول عمیق از ادراک دوبعدی تصاویر استاتیک به درک متریک و پیوسته هندسه سهبعدی جهان فیزیکی، کالبدشکافی مکانیسم توجه جاری (Streaming Attention) در پردازش استریمهای ویدیویی ۶۰ فریم بر ثانیه، حذف کامل توکنایزرهای گسسته در Gemini 2.5 Flash و Claude 3.8 Sonnet و تحلیل پیادهسازی این سیستمها در اتوماسیون رباتیک و طراحی مهندسی تعاملی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
گذر از ادراک دوبعدی به هندسه فضایی؛ چرا VLMهای سنتی در دنیای فیزیکی نابینا بودند؟
💡 **نکته:** اگر با مفاهیم پایهای مدلهای زبانی-بینایی آشنایی ندارید، ابتدا مقاله راهنمای جامع VLM چیست؟ راهنمای مدلهای زبانی-بینایی را مطالعه فرمایید.
تا اوایل سال ۲۰۲۵، مدلهای بینایی-زبانی رایج نظیر GPT-4o و نسخههای اولیه Gemini هرچند در توصیف متن و شناسایی اشیا در تصاویر منفرد توانایی بالایی داشتند، اما در مواجهه با روابط فضایی عمیق، فاصله اشیا، جهتگیری سهبعدی و مقیاس متریک با ناکامیهای فاحش مواجه میشدند. برای یک مدل دوبعدی، یک فنجان کوچک در فاصله ۲۰ سانتیمتری دوربین از نظر وسعت پیکسلی با یک سطل بزرگ در فاصله ۵ متری یکسان به نظر میرسید. این کوری هندسی مانع بزرگی برای توسعه سیستمهای دستیار در دنیای واقعی و هدایت بازوهای رباتیک خودران به شمار میرفت.
با این حال، امروزه و با معرفی معماریهای پیشرفته Spatial VLM، این بنبست مهندسی شکسته شد. به جای پروجکشن پچهای پیکسلی به بردارهای امبدینگ مسطح، مدلهای کنونی از شبکههای پیشبینی عمق متراکم (Dense Depth Prediction) و بازنمایی ابر نقاط سهبعدی (3D Point Cloud Representation) درون لایههای درونی ترنسفورمر بهره میبرند. این ساختارها، دادههای بصری را مستقیماً به یک فضای برداری اقلیدسی با مقیاس میلیمتری مپ میکنند که همگام با کالبدشکافی تفکر عمیق و مقیاسپذیری زمان آزمون، فرآیند استدلال هندسی را ممکن میسازد.
اکنون مدل میتواند با دریافت تصویر یا فید زنده ویدیو، زاویه دقیق چرخش اشیا، فاصله آنها از لبه میز و حتی مسیر بهینه حرکت دست کاربر را تخمین بزند. این دستاورد بستر بینظیری برای هوش مصنوعی عاملمحور و رباتیک خودران فراهم کرده و چالش عدم انطباق فیزیکی ایجنتها را برطرف نموده است.
کالبدشکافی توکنایزرهای پیوسته (Continuous Vision Encoders)؛ حذف فشردهسازی پچهای مجزا
در معماریهای قدیمی، تصویر ابتدا به شبکهای از پچهای ۱۶×۱۶ پیکسلی (مشابه فرمت کلاسیک ViT) تقسیم شده و سپس از طریق توکنایزرهای گسسته به توکنهای تصویری تبدیل میشد. این فرآیند دو نقص بحرانی ایجاد میکرد: افت شدید رزولوشن در لبههای ظریف هندسی، و انفجار تعداد توکنهای زمینه در ویدیوهای طولانی که حتی سریعترین کلاسترهای شتابدهنده را فلج میکرد.
در اواخر، شرکتهای پیشرو به سراغ انکودرهای پیوسته (Continuous Latent Encoders) رفتند. در این چارچوب نوین، ویژگیهای دیداری نه به صورت بستههای مجزای متنی، بلکه به صورت میدانهای تابعی پیوسته (Neural Fields) با رزولوشن نامحدود به بلوکهای Attention ترنسفورمر تزریق میشوند. انکودر قادر است فرکانسهای بالای بافت و عمق را بدون نیاز به تخصیص توکنهای اضافی حفظ کرده و در عین حال مصرف حافظه VRAM را تا ۷۰ درصد کاهش دهد.
این تکنولوژی بنیادین در کنار پیشرفتهای معماری مدلهای بینایی-زبانی-کنشی (VLA)، به مدل اجازه میدهد به طور همزمان متن، بردار موقعیت مکانی و فرامین کنترلی حرکتی را در یک فضای پنهان واحد فرموله کند و دستورات زبانی را مستقیماً به ماتریسهای مات و چرخش فیزیکی تبدیل نماید.
استدلال ویدیویی بلادرنگ با نرخ ۶۰ فریم بر ثانیه؛ مکانیسم Streaming Attention چگونه تاخیر را محو کرد؟
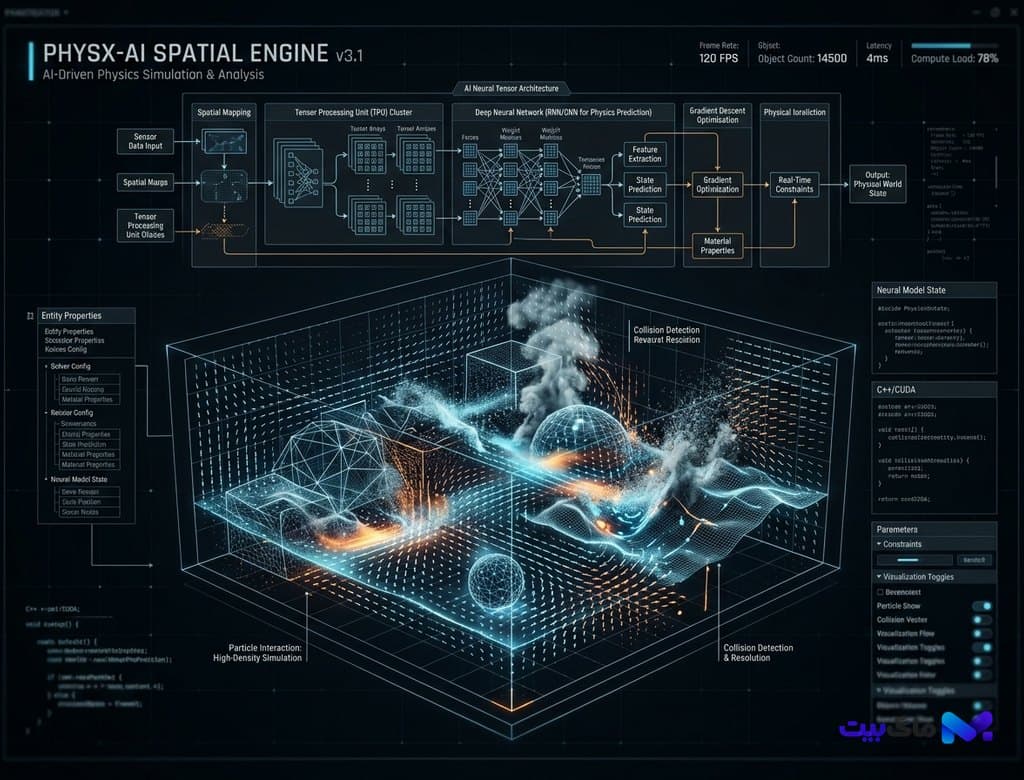
تحلیل ویدیو در سیستمهای قبلی به معنای پردازش فریمهای نمونهبرداریشده (مثلاً ۲ فریم در ثانیه) بود که هرگونه تعامل زنده و استدلال روان در حین رخ دادن اتفاقات را ناممکن میساخت. مدلهای نوظهور به لطف الگوریتم توجه جاری (Streaming Attention with State-Space Hybrid Models) میتوانند جریان ورودی دوربین را با نرخ ۶۰ فریم بر ثانیه و تاخیر سرتاسری زیر ۳۵ میلیثانیه مصرف کنند.
کلید این موفقیت در تلفیق لایههای بازگشتی خطی با حافظه فشرده نهفته است. فریمهای جدید به جای آنکه بارها و بارها با کل تاریخچه ویدیو ضرب تنسوری شوند، یک حالت پنهان در حال تکامل (Evolving Hidden State) را بهروزرسانی میکنند. به محض اینکه رویدادی غیرمنتظره در کادر اتفاق بیفتد—نظیر افتادن یک شیء یا شروع حرکتی خطرناک—مکانیزم انشعاب توجه سریعاً وارد عمل شده و استدلال واکنشی را تریگر مینماید.
این سرعت پاسخدهی شگفتانگیز که پیشتر تنها در مدلهای تولید ویدیوی شبیهساز فیزیک دنیای واقعی برای خلق محتوا به کار میرفت، اکنون در فاز دریافت و درک دادههای دنیای پیرامون به کار گرفته شده تا عینکهای هوشمند و پهپادهای خودران بتوانند در هزارم ثانیه محیط پیرامون را تحلیل نمایند.
نبرد غولهای چندوجهی در اواخر؛ مقایسه رویکرد بومی Gemini 2.5 Flash در برابر Claude 3.8 Sonnet
در حال حاضر دو مدل شاخص در بازار مدلهای فضایی پیشتاز هستند: Gemini 2.5 Flash از گوگل و Claude 3.8 Sonnet از آنتروپیک. گوگل با بهرهگیری از زیرساخت سختافزاری TPU v6e و اکوسیستم دادههای مکانی عظیم Google Maps و YouTube، رویکرد ادغام چندوجهی بومی از ابتدای فاز پیشآموزش (Native Omnimodal Pre-training) را برگزیده است. جمینای در استدلال سهبعدی فیزیکی و پردازش جریان صوتی-تصویری ممتد با پنجره کانتکست ۲ میلیون توکنی فوقالعاده سریع عمل میکند.
در سمت دیگر، Claude 3.8 Sonnet شرکت آنتروپیک با تکیه بر تفکر زنجیرهای اصلاحشده فضایی (Spatial Chain-of-Thought) و رندرهای داخلی برای صحنههای پیچیده، دقت شگفتانگیزی در وظایف مهندسی معکوس، تحلیل نقشههای صنعتی CAD و حل معماهای هندسی انتزاعی نشان میدهد. کلود ابتدا یک گراف منطقی از روابط فضایی صحنه را در ذهن خود ترسیم میکند و سپس گامهای نتیجهگیری را اعتبارسنجی مینماید.
این رقابت فشرده نویدبخش سالی سرنوشتساز برای مهندسی نرمافزار و طراحی محصول است؛ جایی که دستیاران هوش مصنوعی از مانیتورها خارج شده و به ناظران فعال و آگاه از محیط سهبعدی پیرامون ما بدل میشوند.
بیشتر از هوش مصنوعی



