
مدلهای VLA و رباتیک انساننما
امروزه هوش مصنوعی از مانیتورها خارج شده و بدن فیزیکی یافته است؛ بررسی مدلهای نوین VLA که به رباتهای انساننما توانایی درک تصویر و اجرای ماهرانه کارهای بدنی را میدهند.
- کالبدشکافی جامع گذار تاریخی رباتیک از سیستمهای کنترلی سنتی مبتنی بر برنامهنویسی صلب به مدلهای هوش مصنوعی بینایی-زبانی-کنشی (Vision-Language-Action) در نیمه دوم؛ تحلیل معماری بنیادین π0 از استارتاپ Physical Intelligence، پروژه RT-3 گوگل، یکپارچهسازی با رباتهای صنعتی Figure 02 و نبرد برای پیوند درک معنایی با عملگرهای حرکتی در کارخانهها و منازل.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران کنترل خطی رباتها؛ چرا دوران معاصر نقطه عطف رباتیک عمومی است؟
تا پایان سال ۲۰۲۴، رباتهای صنعتی در خطوط تولید اتومبیل عملکردی فوقالعاده اما به شدت محدود داشتند. آنها برای سالها در محیطهایی کامپیوترمحور و ایزوله، دقیقاً یک مسیر هندسی از پیش تعیینشده را هزاران بار در روز با دقت دهم میلیمتر تکرار میکردند. هرگونه جابجایی ناخواسته حتی به اندازه دو سانتیمتر در موقعیت قطعه کار، موجب توقف کامل خط تولید یا برخورد فاجعهبار بازوی مکانیکی میشد؛ زیرا رباتها فاقد «درک فضایی و انطباق حسی» بودند.
اما امروزه این وضعیت با استقرار گسترده مدلهای بینایی-زبانی-کنشی (Vision-Language-Action یا VLA) به طور کامل دگرگون شده است. در مدلهای VLA، ورودی نه تنها متن و تصویر است، بلکه خروجی مستقیماً فرامین تانسوری ولتاژ و گشتاور موتورهای الکتریکی و زاویه مفاصل (Action Tokens) است. این پیشرفت بنیادین درست در ادامه مسیری محقق شد که پیشتر در کالبدشکافی مدلهای جهانمدل و شبیهساز فیزیک فضایی Genie 2 تحلیل کردیم؛ جایی که هوش مصنوعی سرانجام قوانین فیزیکی دنیای سهبعدی را فرا گرفت.
اکنون رباتهای انساننما دیگر منتظر کدنویسی اختصاصی برای هر وظیفه تازه نمیمانند؛ بلکه با یک پرامپت ساده زبانی نظیر «جعبه قطعات برقی را باز کن و پیچهای آلن را درون سینی آلومینیومی بچین»، صحنه را میبینند، اشیا را تفکیک میکنند و بر پایه شبیهسازی درونی، بلافاصله دست به کار میشوند.
کالبدشکافی معماری π0 استارتاپ Physical Intelligence؛ مدل فونداسیون جهان فیزیکی
یکی از درخشانترین دستاوردهای مهندسی امروزه معرفی مدل π0 (Pi-Zero) توسط استارتاپ Physical Intelligence است. این مدل به عنوان یک «مدل پایه همهمنظوره برای رباتها» (Generalist Robot Policy) طراحی شده است. برخلاف رویکردهای گذشته که یک مدل جداگانه برای تا زدن لباس و مدلی دیگر برای پیچاندن درپوش قوطی آموزش داده میشد، π0 ساختاری یکپارچه را بر پایه ترکیب یادگیری خودنظارتی بر میلیونها ساعت ویدیوی انسانی و شبیهسازی یادگیری تقویتی پیادهسازی کرده است.
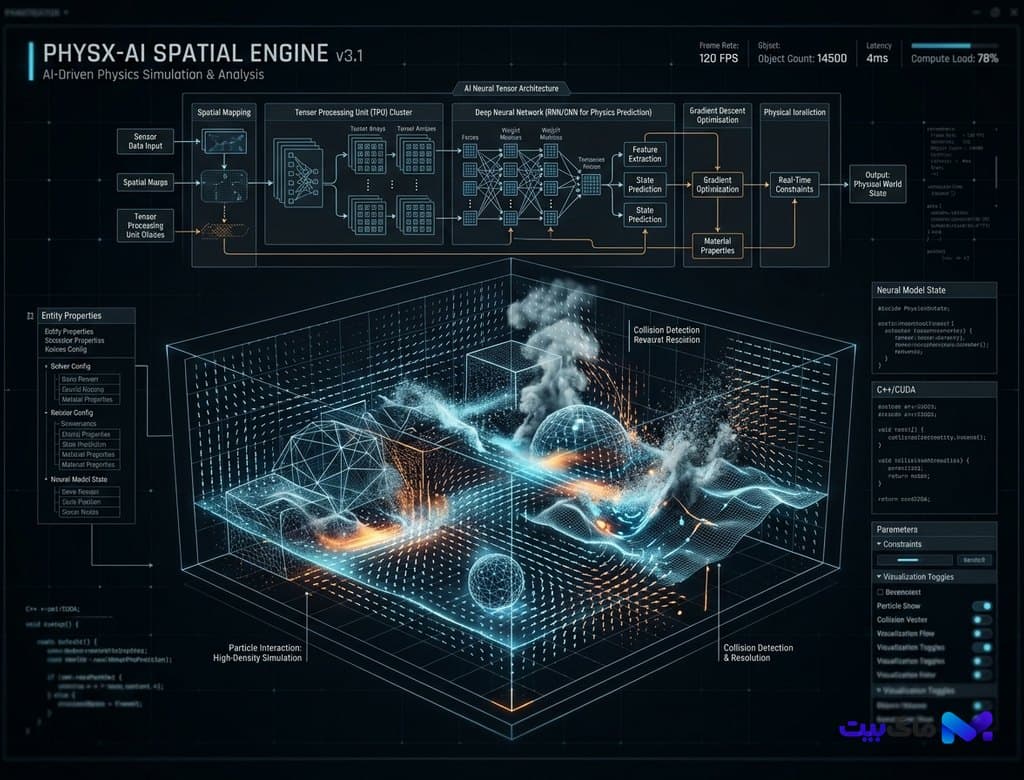
معماری π0 از یک ترنسفورمر چندوجهی پیشرفته تشکیل شده که فریمهای دوربینهای استریوی روی سر و مچ دست ربات را با فرکانس ۵۰ هرتز پردازش کرده و آنها را با دستورات صوتی ادغام مینماید. نکته انقلابی در این سیستم، بهرهگیری از یک شبکه پخشی (Flow Matching / Diffusion Policy) در لایه نهایی است که میتواند حرکات روان، پیوسته و بدون لرزش را حتی در شرایط غیرمنتظره (مانند سرخوردن ناگهانی یک آچار از میان انگشتان لاستیکی) به صورت لحظهای بازسازی و اصلاح کند.
این مکانیزم پردازش بلادرنگ بدون تاخیر، پیوند مستقیمی با فناوریهای هوش مصنوعی روی دستگاه، پردازندههای کممصرف NPU و اجرای محلی مدلها دارد؛ زیرا یک ربات در حال تعادل دینامیکی هرگز نمیتواند منتظر رفتوبرگشت پکتهای اینترنت به کلود بماند.
پروژه Google RT-3 و همگرایی با شبیهسازهای داده Open X-Embodiment
گوگل دیپمایند نیز امروزه با رونمایی رسمی از RT-3 (Robotic Transformer 3)، استانداردهای یادگیری رباتیک را ارتقا داد. RT-3 حاصل آموزش بر روی پایگاه داده تجمیعی عظیم Open X-Embodiment است که دادههای بیش از ۳۵ نوع بدنه رباتیک مختلف (از بازوهای تکمحوره تا رباتهای انساننمای کامل) را در بیش از ۷۰۰ هزار سناریوی محیطی واقعی گردآوری کرده است.
نقطه عطف RT-3، پدیده «تعمیمپذیری بدون آموزش قبلی» (Zero-Shot Generalization) است. اگر یک کارگر کارخانه یا فرد مسن در منزل، میوهای ناآشنا یا ابزاری جدید را در زاویهای عجیب به ربات نشان دهد، RT-3 با تکیه بر درک نمادین زبانی و دانش فیزیکی خود، مفهوم شکنندگی، وزن تخمینی و مرکز ثقل آن جسم را حدس زده و میزان فشار انگشتان سیلیکونی خود را بدون شکستن جسم تنظیم میکند.
این سطح از هوشمندی محیطی ادامهدهنده مسیری است که در تحلیل تکامل هوش مصنوعی عاملمحور و دستیاران خودران شاهد بودیم؛ با این تفاوت که اینجا ایجنت به جای جابجا کردن فایلها در ویندوز، قطعات سنگین فولادی را در سالن مونتاژ جابجا میکند.
همکاریهای صنعتی در خطوط تولید؛ Figure 02 در خط مونتاژ غولهای خودروسازی
شاید نمادینترین تجلی تجاری این انقلاب در ماههای اخیر، استقرار گسترده رباتهای انساننمای Figure 02 در کارخانههای پیشروی خودروسازی در آلمان و آمریکای شمالی باشد. ربات Figure 02 با قدی معادل ۱.۶۸ متر، وزن ۶۰ کیلوگرم و دستان پیشرفته مجهز به ۱۶ درجه آزادی و حسگرهای لامسه متراکم، اکنون شیفتهای کاری مداوم ۶ ساعته را در کنار کارگران انسانی سپری میکند.
این رباتها وظایف طاقتفرسا و تکراری نظیر نصب عایقهای کف کابین، حمل سپرهای سنگین و پیچکاری در زوایای ارگونومیک دشوار را بر عهده دارند. مجهز بودن به باتریهای حالت جامد ۲.۲ کیلوواتساعتی و قابلیت شارژ خودکار در ایستگاههای لبه خط، توقفهای ناخواسته را به صفر رسانده است.
جالب اینجاست که پردازشهای حرکتی و ادراکی این رباتها شباهت شگفتانگیزی با پلتفرمهای محاسباتی دارد که در تحلیل خودروهای نرمافزارمحور و تراشههای مرکزی متمرکز Drive Thor تشریح کردیم؛ هر دو از معماری خوشهای تانسوری برای ناوبری بلادرنگ در دنیای واقعی بهره میبرند.
چالشهای ایمنی، تعامل لمسی و توهم رفتاری در تعامل انسان و ربات
با وجود جهشهای تحسینبرانگیز، چالشهای ایمنی همچنان اولویت نخست آزمایشگاههای رباتیک است. همانگونه که مدلهای زبانی دچار توهم کلامی (Hallucination) میشوند، مدلهای VLA نیز ممکن است دچار «توهم حرکتی» (Kinematic Hallucination) شوند؛ جایی که مدل در تفسیر یک سایه یا خطای نوری در کارگاه، دستور شتاب ناگهانی به بازوی فولادی صادر میکند.
برای پیشگیری از حوادث مرگبار، مهندسان لایههای محافظتی سختافزاری غیرقابل دورزدن (Hardware-Level Interlocks) و سنسورهای پوست مصنوعی پیزوالکتریک را طراحی کردهاند. این پوستهها به محض تماس ناگهانی با بدن انسان، جریان هیدرولیک یا سرووموتورها را در کمتر از ۵ میلیثانیه قطع کرده و ربات را در وضعیت خنثی قرار میدهند.
تحریریه ماگ بیت پیشبینی میکند که وضع استانداردهای سختگیرانه صنعتی و گواهینامههای ایمنی سایبرفیزیکی در سالهای و ۲۰۲۷، عامل اصلی در تعیین سرعت ورود این رباتها به منازل و مدارس خواهد بود.
نتیجهگیری و چشمانداز تحریریه ماگ بیت: سپیدهدم عصر همزیستی با ماشینهای متحرک
دوران معاصر در تاریخ فناوری به عنوان سالی ثبت خواهد شد که در آن هوش مصنوعی از تله نمایشگرهای دو بعدی رهایی یافت. مدلهای بینایی-زبانی-کنشی (VLA) پل میان زبان ذهن و مهارت دست را بنا نهادند.
رباتهای انساننما در آستانه تغییر بنیادین مفاهیمی چون کمبود نیروی کار، مراقبت از سالمندان و ساختوساز در شرایط سخت اقلیمی هستند. انسان مدرن دیگر تنها ابزار نمیسازد؛ بلکه شریکانی فیزیکی خلق میکند که زبان ما را میفهمند، دنیای ما را میبینند و بار کارهای طاقتفرسای مادی را با متانت بر دوش میکشند.
بیشتر از هوش مصنوعی



