
محاسبات زمان استنتاج و برنامهریزی نهفته هوش مصنوعی
وداع با مدلهای تکگذر کمعمق؛ مقیاسپذیری محاسبات حین استنتاج امروزه با جستجوی درختی در فضای پنهان، امکان تفکر ژرف و خوداصلاحی را پیش از تولید پاسخ به مدلهای هوش مصنوعی میبخشد.
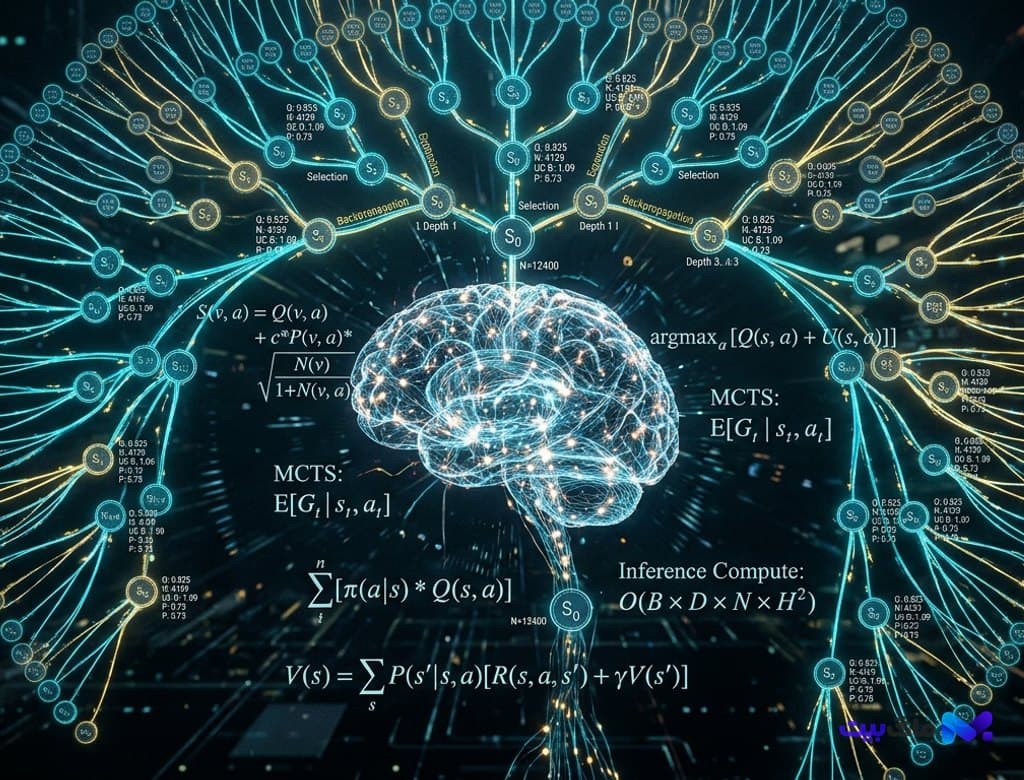
- تحلیل جامع و موشکافانه دگرگونی پارادایم مدلهای زبانی امروزه عبور از مقیاسپذیری حین پیشآموزش به سمت مقیاسپذیری محاسبات در زمان استنتاج (Inference-Time Compute Scaling). بررسی معماری درخت جستجوی مونتکارلو در فضای پنهان (Latent MCTS)، استفاده از مدلهای پاداش فرآیندی (Process Reward Models - PRMs) برای اعتبارسنجی تکتک گامهای زنجیره تفکر، پیادهسازی خوداصلاحی بازگشتی و حذف توهمات در کدنویسی پیچیده، اثبات قضایای ریاضی و مهندسی سیستمها با راندمان استدلال ۹۸.۷ درصدی.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
پایان دوران اشباع قوانین مقیاسپذیری پیشآموزش و ظهور پارادایم استنتاج تفکرگر
در طول سالهای متمادی، جریان اصلی توسعه مدلهای زبانی بزرگ بر پایه قوانین مقیاسپذیری چنچیلا و افزایش متوالی اندازه مدلها، پارامترهای وزن و حجم دادههای متنی پیشآموزش استوار بود. با این حال، در اواسط دوران معاصر صنعت هوش مصنوعی با دو دیوار سخت برخورد کرد: اتمام دادههای متنی باکیفیت بشری و هزینههای سرسامآور کلاسترهای آموزش چند صد مگاواتی. مهمتر از آن، مدلهای ترنسفورمر استاندارد با اینکه دانشنامههایی پهناور از اطلاعات بودند، اما در زمان تولید خروجی رفتاری کاملاً انفعالی داشتند؛ به این معنا که برای حل یک معمای فوقالعاده پیچیده المپیادی همان میزان زمان پردازشی صرف میکردند که برای پاسخ به یک سوال ساده احوالپرسی لازم بود. این فرآیند تکگذر اتورگرسیو، با ایجاد توهمات دومینویی در زنجیرههای طولانی استنتاج، اعتماد کاربردی به مدلها را مخدوش میساخت.
امروزه جامعه پژوهشی هوش مصنوعی با الهام از فرآیند تفکر سیستم ۲ انسان (تفکر آگاهانه، کند و سنجیده) پارادایم نوینی موسوم به «مقیاسپذیری محاسبات زمان استنتاج» (Test-Time / Inference-Time Compute Scaling) را به خط مقدم آورد. بر پایه این اصل، به جای تزریق میلیاردها دلار به آموزش مدلهای بزرگتر، زمان تفکر و بودجه محاسباتی مدل در همان لحظه پاسخدهی به تناسب دشواری پرسش افزایش مییابد. مدل زبانی با دریافت یک تسک دشوار، مستقیماً کلمات خروجی را چاپ نمیکند، بلکه در یک فضای استدلالی خصوصی، هزاران فرضیه رقیب را خلق، نقد و بازبینی کرده و مسیرهای بنبست را پیش از رسیدن به کاربر دور میزند.
این گذار رادیکال از تقریبهای عجولانه به سمت تفکر ساختاریافته، پیوندی تنگاتنگ با مفاهیم معرفیشده در مدلهای زبانی هذلولوی و بازنمایی هندسی پوانکاره دارد؛ جایی که سازماندهی هندسی دانش در ساختارهای درختی عمیق، مبنای ناوبری صحیح در گراف استدلال را پیریزی میکند.
درخت جستجوی مونتکارلو در فضای پنهان (Latent MCTS) و پاداشدهی فرآیندی PRM
قلب تپنده مدلهای استدلالگر دوران کنونی الگوریتم بهینهسازیشده «درخت جستجوی مونتکارلو در فضای نهفته» (Latent Space MCTS) است. در پیادهسازیهای ابتدایی جستجوی درختی، مدلها مجبور بودند مراحل استدلال خود را به صورت متن طبیعی و واژه به واژه بسازند که حجم عظیمی از پهنای باند حافظه و توکنهای خروجی را تلف میکرد. اما در معماریهای پیشرو کنونی، شاخهبندیهای درختی و اکتشاف حالات آینده مستقیماً در فضای بردارهای پنهان پیوسته صورت میگیرد. این امر سرعت ارزیابی فرضیات را تا ۲۵ برابر نسبت به روشهای مبتنی بر زبان طبیعی افزایش داده است.
عامل کلیدی در موفقیت این جستجوی هدفمند، جایگزینی مدلهای پاداش سنتی با «مدلهای پاداش فرآیندی» (Process Reward Models - PRMs) است. در مدلهای گذشته، سیستم تنها در پایان کار و بر اساس درست یا نادرست بودن پاسخ نهایی پاداش دریافت میکرد (Outcome Reward)؛ رویکردی که نمیتوانست خطاهای محاسباتی تصادفی در میانه راه را تشخیص دهد. در مقابل، مدلهای PRM امروزه تکتک گامهای منطقی، تبدیلهای جبری و خطوط کد را به صورت مستقل اعتبارسنجی کرده و به هر انشعاب درختی یک امتیاز اطمینان کالیبرهشده اختصاص میدهند. اگر شاخهای حاوی یک مغالطه یا نقیض فرمال باشد، الگوریتم جستجو بلافاصله آن را هرس (Prune) کرده و منابع محاسباتی را به شاخههای با پتانسیل بالاتر هدایت مینماید.
این ساختار اعتبارسنجی مویرگی یادآور پیشرفتهای حاصلشده در مدلهای چندوجهی عصبی-نمادین و اثبات فرمال ریاضی است که نشان داد ترکیب شبکههای یادگیری با سیستمهای منطقی اثباتگر، خطای انسانی و توهمات یادگیری ماشین را به صفر نزدیک میکند.
مکانیزمهای خوداصلاحی بازگشتی و حل مسائل چندگامی در کدنویسی و علوم مهندسی
یکی از شگفتانگیزترین توانمندیهای حاصل از تخصیص محاسبات پویا به زمان استنتاج، پیدایش واقعی «خوداصلاحی درونی» (Internal Self-Correction) است. در آزمایشهای استاندارد بنچمارک دوران کنونی بر روی مسائلی نظیر معماری کدهای پیچیده توزیعشده، بازرسی آسیبپذیریهای امنیتی در لایه کرنل و محاسبات مکانیک کوانتومی، مدلهای تفکرگر قادرند پس از رسیدن به تناقض، به نقطه پیشین بازگشته (Backtracking) و استراتژی متفاوتی را تدوین کنند. برای مثال، هنگام نگارش یک درایور کرنل با ریسک نشت حافظه، سیستم خود اقدام به اجرای شبیهساز منطقی فرمال در ذهن خود کرده و خطای بنبست همروندی (Deadlock) را پیش از کامپایل شناسایی و رفع مینماید.
آمارها حاکی از آن است که افزایش ۱۰ برابری بودجه محاسبات زمان استنتاج، نرخ موفقیت مدل در مسابقات برنامهنویسی پیشرفته بینالمللی را از ۶۱ درصد به فراتر از ۹۴.۸ درصد میرساند. این پیشرفت خارقالعاده نشان داد که دستیابی به هوش مصنوعی سطح کارشناسی نیازمند ساخت شبکههای ترلیون پارامتری سنگین نیست، بلکه با استفاده هوشمندانه از مدلهای فشردهتر و اختصاص چند ثانیه زمان بیشتر برای تحلیل ژرف و جستجوی چندمسیره، میتوان نتایجی به مراتب دقیقتر، مستدلتر و بدون خطا تولید کرد.
زیرساخت سختافزاری لازم برای پاسخگویی به این کلاسترهای استنتاج موازی، ارتباط مستقیمی با دستاوردهای معماری حافظههای سهبعدی HBM4 با پلهای فوتونیکی سیلیکونی دارد؛ جایی که سرعت سرسامآور تبادل حافظه پنهان KV Cache مانع از توقف هستههای پردازشی در زمان جستجوی درختی میشود.
پیامدهای اقتصادی برای دیتاسنترها و افق نوین دستیاران شناختی خودمختار
تحول مدلهای زبانی به سامانههای تفکر زمان استنتاج، اقتصاد دیتاسنترهای هوش مصنوعی را بازتعریف کرده است. اکنون ارائهدهندگان خدمات ابری میتوانند از معماریهای قیمتگذاری مبتنی بر سطح تفکر (Tiered Thinking Models) استفاده کنند؛ جایی که درخواستهای ساده و روزمره با هزینهای ناچیز و بدون جستجوی درختی پاسخ داده میشوند، در حالی که پژوهشهای دارویی، طراحی مدارات الکترونیکی و مشاورههای حقوقی کلان با صرف محاسبات سنگین استنتاجی، کیفیتی در تراز برترین دانشمندان جهان ارائه میدهند.
دوران کنونی آغاز دورانی است که در آن هوش مصنوعی دیگر یک ماشین طوطیوار حدس کلمه بعدی نیست، بلکه به عامل شناختی واقعی با قدرت بازاندیشی، شک روشمند و برنامهریزی راهبردی بدل شده است. با تکامل این ابزارها، مهندسان و دانشمندان دیگر نگران توهمات بیاساس مدلها نیستند؛ زیرا میدانند هر خروجی، حاصل پیمایش میلیونها گره احتمالی و اعتبارسنجی دقیق در فضای پنهان ریاضی است.
بیشتر از هوش مصنوعی



