
رونمایی رسمی و کالبدشکافی هوش مصنوعی Meta Llama 3.2؛ جهش تاریخی متای زاکربرگ با مدلهای بینایی ۱۱B و ۹۰B، انقلاب پردازش محلی روی گوشیهای پرچمدار و آغاز عصر اپنسورس چندوجهی
کالبدشکافی کامل هوش مصنوعی Meta Llama 3.2؛ مدلهای بینایی ۱۱B و ۹۰B با دقت ۹۰.۱٪ در DocVQA، مدلهای سبک ۱B و ۳B برای پردازش آفلاین روی NPU موبایل و معرفی جعبهابزار Llama Stack.
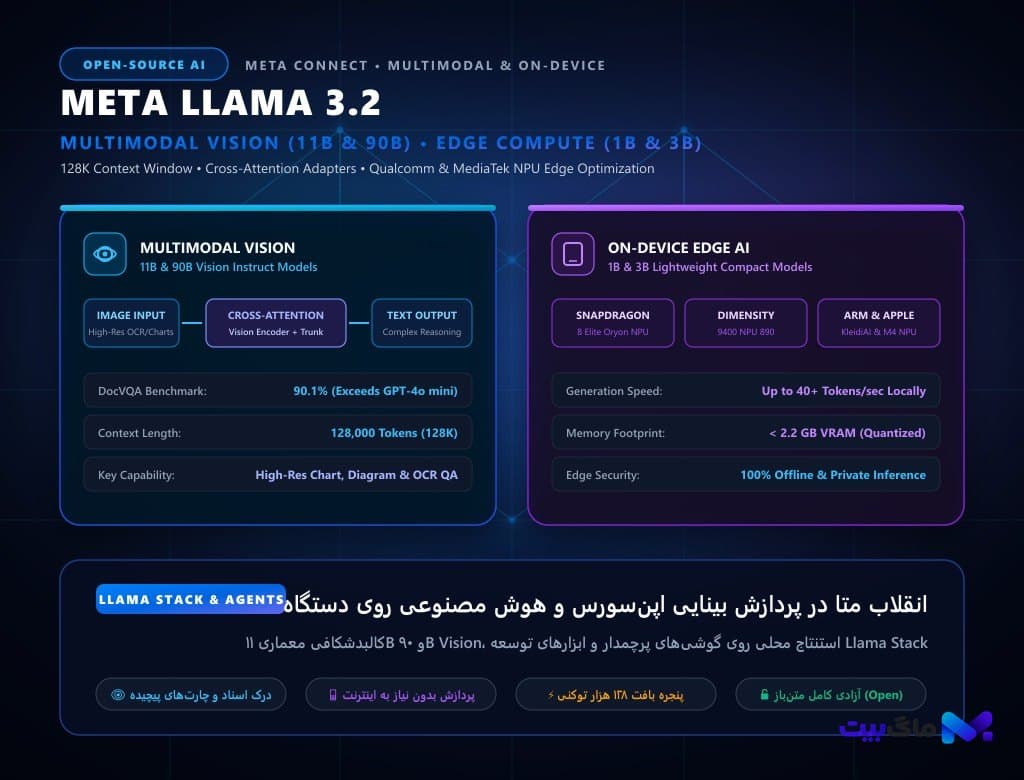
- کمپانی متا در رویداد سالانه Meta Connect با معرفی رسمی خانواده هوش مصنوعی Llama 3.2، فصلی نوین در تاریخ هوش مصنوعی متنباز رقم زد. این خانواده شامل دو ستون بنیادین است: مدلهای چندوجهی بینایی ۱۱B و ۹۰B که با تکیه بر معماری خلاقانه Cross-Attention، توانایی استدلال بر روی اسناد متنی، نمودارها و تصاویر پیچیده را همتراز با برترین مدلهای تجاری اختصاصی فراهم میآورند؛ و مدلهای فوقسبک ۱B و ۳B که با همکاری نزدیک با غولهای سیلیکون نظیر کوالکام، مدیاتک و آرم برای پردازش مستقیم روی دستگاه (Edge AI) و بدون نیاز به ارتباط ابری بهینهسازی شدهاند. با پشتیبانی از پنجره بافت ۱۲۸ هزار توکنی و معرفی فریمورک استاندارد Llama Stack، متا انحصار غولهای انحصاری را در پردازش چندوجهی در هم شکسته است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
انقلاب متنباز متا در رویداد Connect؛ پایان انحصار غولهای انحصاری بر بینایی چندوجهی
دنیای هوش مصنوعی در طول دو سال گذشته با یک دوگانگی ساختاری دستبهگریبان بود: در حوزه مدلهای صِرفاً متنی، موج متنباز به رهبری کمپانی متا توانسته بود با عرضه مدلهای پرچمدار لاما شکاف میان پروژههای آزاد و سیستمهای تجاری انحصاری را تقریباً به صفر برساند؛ اما در قلمرو مدلهای بینایی-زبانی (VLM) و درک چندوجهی، کاربران و توسعهدهندگان همچنان ناچار به تکیه بر APIهای گرانقیمت و سرورهای ابری اختصاصی شرکتهایی همچون اوپنایآی و گوگل بودند. مارک زاکربرگ در جریان کنفرانس سالانه Meta Connect با رونمایی رسمی از خانواده قدرتمند Meta Llama 3.2، رسماً به این انحصار پایان داد و پرچم متنباز را بر فراز قلمرو بینایی چندوجهی و پردازش لبه برافراشت.
خانواده لاما ۳.۲ در یک استراتژی هوشمندانه به دو بخش مکمل تقسیم شده است: از یک سو، مدلهای بزرگ چندوجهی ۱۱ میلیارد پارامتری (11B Vision) و ۹۰ میلیارد پارامتری (90B Vision) که توانایی دیدن، استدلال و تحلیل عمیق بصری را به کلاسترها و سرورهای سازمانی میآورند؛ و از سوی دیگر، مدلهای کامپکت و فوقسریع ۱ میلیارد (1B) و ۳ میلیارد (3B) پارامتری که با تمرکز ویژه بر استنتاج آنی، مصرف ناچیز انرژی و پردازش کاملاً محلی بر روی پردازندههای عصبی (NPU) نسل جدید گوشیهای هوشمند و لپتاپهای هوش مصنوعی مهندسی شدهاند. این تحول درست در شرایطی رخ میدهد که رقابت بر سر سرعت استنتاج و کاهش هزینهها به نقطه اوج رسیده است؛ پدیدهای که اخیراً در رونمایی از مدل هوش مصنوعی Claude 3.5 Haiku و نبرد مدلهای سبک متنی نیز شاهد آن بودیم.
کالبدشکافی معماری Cross-Attention؛ پیوند نبوغآمیز انکودر بینایی با تنه پردازشی لاما ۳.۱
بزرگترین چالش مهندسی در ارتقای یک مدل زبانی قدرتمند به یک مدل چندوجهی، پدیدهای خطرناک به نام «تخریب فاجعهبار دانشی» (Catastrophic Forgetting) است؛ وضعیتی که در آن با آموزش دادن وزنهای مدل بر روی تصاویر، مهارتهای پیشرفته استدلال منطقی، حل مسائل ریاضی و کدنویسی تضعیف میشوند. مهندسان بخش پژوهشهای هوش مصنوعی متا (Meta AI) برای حل این معمای بغرنج، معماری تطبیقدهنده زنجیرهای مبتنی بر Cross-Attention را ابداع کردند که نحوه کارکرد آن مفاهیم بنیادین تشریحشده در مقاله VLM چیست؟ راهنمای کامل مدلهای بینایی-زبانی را ارتقا میدهد.
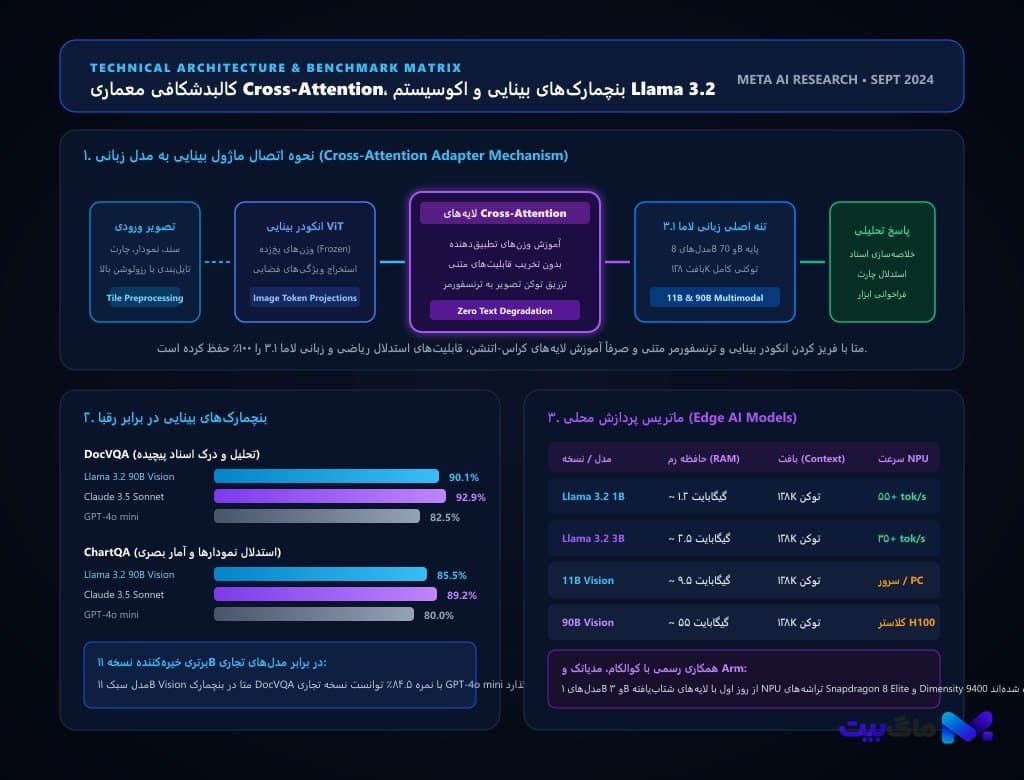
در این ساختار نوآورانه، تنه اصلی پردازش زبان طبیعی (Text LLM Trunk) که بر پایه مدلهای ازپیشآموزشدیده Llama 3.1 8B و Llama 3.1 70B بنا شده، به طور کامل در وضعیت فریز (Frozen) نگه داشته میشود تا تمامی نبوغ زبانی و استدلالی آن دستنخورده باقی بماند. همزمان، یک شبکه انکودر بینایی با معماری ترنسفورمر بینایی (ViT) به منظور پردازش و استخراج ویژگیهای بصری با رزولوشن بالا آموزش داده میشود. سپس، مجموعهای از لایههای کراس-اتنشن اختصاصی در فواصل منظم میان بلوکهای پردازشی تزریق میگردند که وظیفه دارند توکنهای تصویری بازنماییشده را به جریان بردارهای متنی پیوند بزنند. در نتیجه، نسخه ۱۱B ویژن در واقع حاصل افزودن یک لایه تطبیق ۳ میلیارد پارامتری به تنه لاما ۳.۱ نسخه ۸B است، و مدل ۹۰B ویژن نیز از تلفیق تنه ۷۰B با لایههای انکودر بینایی پیشرفته پدید آمده است. این تفکیک معماری باعث شده تا مدل نه تنها در استدلال تصاویری نظیر نمودارهای مالی، تصاویر پزشکی و نقشههای مهندسی بدرخشد، بلکه در استدلالهای گامبهگام و زنجیره تفکر نیز رفتاری پخته شبیه به آنچه در رونمایی رسمی از مدل استدلالگر OpenAI o1 دیدیم از خود بروز دهد.
کارزار بنچمارکهای بینایی؛ پیروزی مدل ۱۱B متنباز بر پرچمداران تجاری در DocVQA و ChartQA
ارزیابیهای جامع و مستقل بنچمارکها نشان میدهند که مهندسی متا توانسته استانداردهای کارایی را ارتقا دهد. در آزمون دشوار و حیاتی DocVQA که میزان درک، استخراج داده و استدلال بر روی اسناد ساختاریافته، فرمهای اداری و جداول پرپیچوخم متنی را میسنجد، مدل پرچمدار Llama 3.2 90B Vision توانست با کسب امتیاز خیرهکننده ۹۰.۱ درصد، فاصلهای میلیمتری با مدل قدرتمند Claude 3.5 Sonnet (با امتیاز ۹۲.۹٪) به ثبت برساند و قاطعانه رقبای معروفی چون GPT-4o mini (با امتیاز ۸۲.۵٪) را پشت سر بگذارد.
اما شگفتی واقعی در نسخه سبکتر رخ داد: مدل ۱۱B Vision متا با ثبت امتیاز ۸۴.۵ درصد در آزمون DocVQA، موفق شد پرچمدار اختصاصی اوپنایآی یعنی GPT-4o mini را مغلوب سازد؛ دستاوردی تاریخی که نشان میدهد یک مدل متنباز با حجم پارامتر بسیار کمتر میتواند در درک اسناد کاری روزمره، صورتحسابها و چارتهای اداری، خروجیهای دقیقتر و پایدارتری تولید کند. در بنچمارکهای استدلال گرافیکی و تفسیری ChartQA نیز نسخه ۹۰B به امتیاز ۸۵.۵ درصد دست یافت که در مقایسه با استاندارد ۸۰ درصدی GPT-4o mini یک جهش معنادار به شمار میرود. تمام این مدلها با یک پنجره بافت فوقالعاده وسیع ۱۲۸ هزار توکنی (128K Context Window) عرضه شدهاند؛ بدان معنا که کاربران میتوانند یک سند مالی چنددهصفحهای حاوی صدها جدول و تصویر پیچیده را در یک درخواست به مدل ارائه کرده و تحلیلی یکپارچه، عاری از هذیان و کاملاً مستند دریافت نمایند.
انقلاب پردازش لبه؛ استنتاج آفلاین و بلادرنگ مدلهای ۱B و ۳B روی NPUهای نسل نوین
دومین شاهکار بنیادین متا در خانواده لاما ۳.۲، تعریف مجدد مفهوم هوش مصنوعی روی دستگاه (On-Device AI) از طریق مدلهای ۱B و ۳B است. متا برای دستیابی به نهایت فشردگی بدون قربانی کردن کیفیت زبانی، از تکنیکهای پیشرفته هرس وزنی (Pruning) و تقطیر دانش (Knowledge Distillation) به طور مستقیم از روی مدلهای غولپیکر ۷۰B بهره گرفت. لایههای شبکههای عصبی با دقت بالا بازآرایی شدند تا مدلها بتوانند کل پنجره بافت ۱۲۸ هزار توکنی را با مصرف حافظه رم فوقالعاده پایین میزبانی کنند؛ به طوری که نسخه کوانتیزهشده مدل ۱B تنها به ۱.۲ گیگابایت رم و نسخه ۳B به کمتر از ۲.۵ گیگابایت رم نیاز دارد.
متا برای تضمین عملکرد بیدرنگ این مدلها، از مراحل اولیه طراحی با بزرگان صنعت نیمههادی وارد همکاری شد. این مدلها به طور بومی برای شتابدهندههای عصبی تعبیهشده در تراشههای پرچمدار بهینهسازی شدهاند؛ قابلیتی که آن را در هماهنگی عمیق پردازش با موتور عصبی Hexagon در کالبدشکافی معماری تراشه اسنپدراگون ۸ الیت کوالکام و قدرت پردازش چندوجهی در کالبدشکافی معماری تراشه مدیاتک دایمنسیتی ۹۴۰۰ مشاهده کردیم. مدل ۳B بر روی این چیپستها میتواند به سرعت پردازش بیش از ۳۵ تا ۴۰ توکن بر ثانیه دست یابد؛ سرعتی بالاتر از ریتم مطالعه طبیعی انسان که امکان خلاصهسازی محلی پیامها، پاسخدهی به ایمیلها، بازنویسی متون حساس بدون خروج کمترین بایت از حریم خصوصی کاربر و مدیریت تقویم را بدون نیاز به هیچگونه اتصال اینترنتی و با تأخیر صفر میلیثانیهای محقق میسازد.
فریمورک استاندارد Llama Stack و چشمانداز اکوسیستم؛ متا چگونه آینده عاملهای هوشمند را پیریزی میکند
انتشار مدلهای هوش مصنوعی به تنهایی برای دگرگونی فضای نرمافزاری کافی نیست؛ توسعهدهندگان نیازمند ابزارهایی استاندارد برای اتصال مدل به پایگاههای دانش، ابزارهای خارجی و محیطهای اجرایی هستند. همزمان با معرفی Llama 3.2، متا از پروژه بلندپروازانه «Llama Stack» پرده برداشت. لاما استک یک معماری استانداردسازیشده از رابطهای برنامهنویسی کاربردی (API) است که به برنامهنویسان اجازه میدهد برنامههای بازیابی اطلاعات تقویتشده (RAG)، سامانههای حافظه رویدادی و از همه مهمتر «عاملهای هوشمند خودران» (Autonomous Agents) را با کمترین میزان کدنویسی راهاندازی کنند.
با بهرهگیری از توزیعهای Llama Stack، مدلهای لاما ۳.۲ میتوانند ابزارهای دسکتاپ و وب را فراخوانی کرده و تسکهای چندمرحلهای را به انجام برسانند. این رویکرد در امتداد دستاوردهای شگفتانگیز دیگر غولهای فناوری نظیر رونمایی رسمی و کالبدشکافی هوش مصنوعی Meta Movie Gen در ایجاد هماهنگی چندرسانهای قرار دارد. متا با ارائه توزیعهای رسمی Llama Stack برای فریمورکهای موبایلی و لینوکسی، بستری فراهم کرده تا هر استارتاپ و شرکتی بتواند دستیار اختصاصی خود را بر بستر دادههای محلی پیادهسازی کند. در نهایت، عرضه Llama 3.2 پیامی صریح به سراسر اکوسیستم سیلیکونولی مخابره کرد: آینده هوش مصنوعی در انحصار دیوارهای بسته باقی نخواهد ماند؛ آینده به مدلهای شفاف، چندوجهی، کممصرف و در دسترسی تعلق دارد که قدرت پردازش را مستقیماً به کف دست میلیاردها انسان بازمیگردانند.
بیشتر از هوش مصنوعی



