
هوش مصنوعی صوتبهصوت بومی و مکالمه بلادرنگ
دوران پاسخهای رباتیک و تأخیرهای چندثانیهای به سر آمد؛ مدلهای صوتبهصوت بومی با ادراک لحن، خنده و احساسات، گفتوگوی زنده طبیعی با تأخیر زیر ۱۵۰ میلیثانیه را محقق ساختند.
- تحلیل جامع و عمیق دگرگونی بنیادین دستیاران هوشمند با ظهور مدلهای زبانی چندوجهی صوتبهصوت مادری (Native End-to-End Voice-to-Voice AI) امروزه. کالبدشکافی حذف خطوط لوله سهمرحلهای پرتاخیر متشکل از تبدیل گفتار به متن، پردازش LLM و سپس سنتز گفتار، سازوکار رمزگذاری پیوسته اسپکتوگرام و توکنایزرهای صوتی عصبی، درک ظرایف حسی، طعنه، خنده و تغییرات تن صدا در تعامل انسانی، قابلیت تعلیق و قطع کلام بلادرنگ دوطرفه (Full-Duplex Interruption)، و اثرگذاری این جهش بر ارتباطات انسان و ماشین در دستگاههای لبه بدون اتکای کامل به پردازش ابری.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
مرگ خط لوله سهمرحلهای آبشاری؛ چرا معماری سنتی صوتی هرگز زنده و طبیعی نبود؟
برای بیش از یک دهه، هر زمان که کاربری با سیری، الکسا یا دستیاران اولیه هوش مصنوعی صحبت میکرد، تعامل در پشت صحنه در سه مرحله کاملاً مجزا و ناپیوسته خرد میشد: نخست سیستم تشخیص خودکار گفتار (ASR) صدای کاربر را به متن تبدیل میکرد؛ سپس یک مدل زبانی بزرگ (LLM) آن متن را خوانده و پاسخ متنی تولید میکرد؛ و در نهایت موتور تبدیل متن به گفتار (TTS) با استفاده از نمونههای صوتی ضبطشده، متن خروجی را با صدایی مصنوعی بازخوانی مینمود. این معماری آبشاری سه فاجعه بنیادین در پی داشت: ایجاد تأخیر انباشته بین ۱.۵ تا ۳ ثانیه، نابودی کامل ۹۰ درصد اطلاعات فرامتنی مانند احساسات، خنده، اضطراب و مکثهای معنادار، و ناتوانی ذاتی در قطع کلام بلادرنگ.
هنگامی که گفتار انسان به کاراکترهای متنی خرد میشود، لحن صدا، لهجه، سرعت بیان و احساس نهفته در کلمات تبخیر میشوند؛ بنابراین مدل هیچ درکی نداشت که آیا کاربر جملهای را با کنایه و طنز ادا کرده یا در وضعیتی بحرانی درخواست کمک دارد. همانگونه که در بررسی تخصصی مقیاسپذیری زمان آزمون و استدلال عمیق هوش مصنوعی امروزه تشریح شد، جهتگیری مدرن محاسبات هوش مصنوعی بر پایهریزی مدلهایی استوار است که بتوانند مستقیماً در فضای بازنمایی مادری سیگنالها فکر کنند و از تبدیلهای واسطهای و پراتلاف اطلاعات بپرهیزند.
امروزه انتشار مدلهای بنیادین گفتار مادری (Native Audio LLMs) خط بطلانی بر این روش منسوخ کشید. این مدلها به گونهای از پایه آموزش دیدهاند که توکنهای صوتی فشرده عصبی را به صورت پیوسته دریافت و مستقیماً توکنهای موج صوتی متناظر را در همان لایههای درونی سنتز مینمایند؛ بدین ترتیب هوش مصنوعی بدون نیاز به واسطهگری متن، مستقیماً به زبان امواج صوتی میشنود و سخن میگوید.
مهندسی توکنایزرهای عصبی پیوسته و پروتکل تعلیق دوطرفه همزمان (Full-Duplex)
هسته فنی این جهش بزرگ، معرفی توکنایزرهای عصبی فوقفشرده مانند نسل جدید SoundStream و EnCodec با نرخ بیت زیر ۱.۵ کیلوبیت بر ثانیه است. این رمزگذارها میتوانند امواج آکوستیک را به بردارهای معنایی فضایی-زمانی تبدیل کنند که نه تنها ساختار آواشناختی واژهها، بلکه تن صدا، فرکانس زیروبم، نفس کشیدن گوینده و طنین محیط را در بردارهای نهفته حفظ مینمایند. این معماری پیوسته همان رویکرد انقلابی است که مشابه آن در فلو مچینگ و ترنسفورمرهای انتشار ویدیویی DiT امروزه برای حل معادلات دیفرانسیل برداری و تولید پیوسته فریمها به کار گرفته شده است.
دستاورد حیاتی دیگر، تحقق واقعی ارتباط دوجانبه کامل (Full-Duplex Interruption) است. در سیستمهای گذشته، اگر کاربر در میان صحبت مدل کلمهای میگفت، مدل تا پایان پاراگراف متوجه نمیشد یا دچار قطعی زننده میشد. اما در ترنسفورمرهای صوتبهصوت دوران کنونی مکانیسم توجه متقاطع صوتی به طور پیوسته در طول تولید هر هجای خروجی، کانال میکروفون ورودی را پایش میکند. به محض آنکه کاربر شروع به صحبت کند، مدل متناسب با اهمیت کلام کاربر، لحن خود را آرام میکند، کلامش را متوقف میسازد یا با عباراتی مثل «بله حتماً، ادامه بده» وارد گفتوگوی پویا میشود.
تأخیر رفتوبرگشت صدا در این شبکهها به کمتر از ۱۲۰ تا ۱۵۰ میلیثانیه کاهش یافته است؛ عددی که دقیقاً با آستانه ادراک مکالمه رو در روی دو انسان مطابقت دارد. این پاسخدهی آنی، حس صحبت با یک موجود دارای هوش زنده و ادراک حسی را القا میکند که تا پیش از این در تاریخ فناوری سابقه نداشته است.
ادراک احساسات، پایش سلامت روان و گفتار انطباقی بدون توهم کلامی
یکی از چشمگیرترین ابعاد هوش مصنوعی صوتبهصوت بومی امروزه توانایی انطباق آنی با سبک گفتاری مخاطب است. اگر کاربر با شتابزدگی و اضطراب صحبت کند، مدل بلافاصله پاسخهای خود را کوتاه، شمرده، اطمینانبخش و با فرکانس پایینتر تنظیم میکند تا اثر آرامبخشی داشته باشد. برعکس، در تعامل با کودکان یا در سناریوهای آموزش زبان، سیستم با لحنی هیجانزده، همراه با خندههای متناسب و تمپوی کلامی منعطف سخن میگوید.
علاوه بر جنبههای ارتباطی، شرکتهای پیشرو در سلامت دیجیتال از این مدلها به عنوان ابزارهای غربالگری زودهنگام بیماریها بهره میبرند. تغییرات میکرومتری در لرزش تارهای صوتی، افت فرکانس تنفسی و تأخیر در بازتولید اصوات، نشانگرهای زیستی دقیقی از شروع خستگی مفرط، آپنه خواب، اختلالات شناختی زودهنگام یا افسردگی بالینی هستند. دستیار صوتی بدون آنکه بازجویی کند، صرفاً از طریق لحن سلام و احوالپرسی صبحگاهی متوجه وضعیت فیزیولوژیک کاربر میشود.
همانطور که در مطالعه تحلیلی اسپیکرهای اولتراسونیک پارامتریک و باریکهسازی صدا امروزه بررسی شد، خروجی این مدلها بر روی سختافزارهای باریکهساز آکوستیک میتواند حبابهای مکالمه کاملاً خصوصی و بدون نشت صدا در اتاق نشیمن یا خودرو ایجاد کند؛ تعاملی محرمانه که آرامش و حریم خصوصی کاربر را پاس میدارد.
استقرار مدلهای گفتاری روی تراشههای NPU لبه و چشمانداز تعامل انسان و ماشین
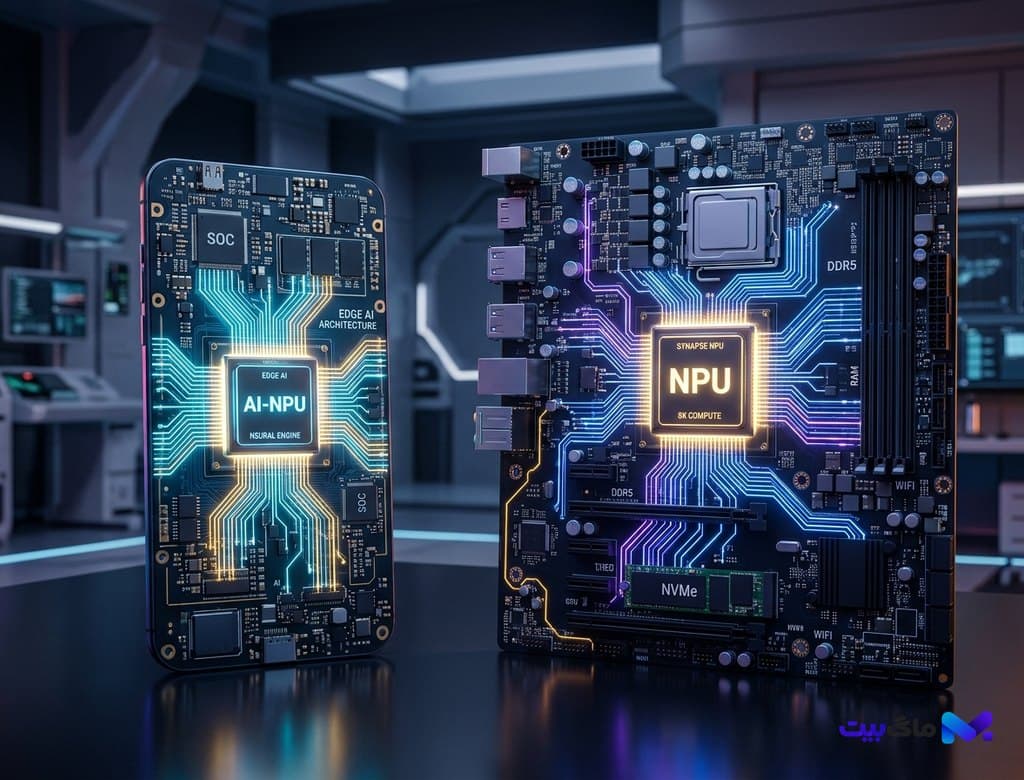
تا چند ماه پیش، اجرای مدلهای یکپارچه صوتی نیازمند اتصال دائمی به مزارع سرورهای ابری گرانقیمت با کلاسترهای H100 بود که علاوه بر هزینههای نجومی، نگرانیهای جدی درباره استراقسمع و نقض حریم شخصی ایجاد میکرد. با این حال، امروزه با گسترش تراشههای NPU اختصاصی روی گوشیهای هوشمند، خودروهای برقی و هندزفریهای نسل جدید، نسخههای کوانتیزهشده ۴ بیتی مدلهای صوتی با حجم زیر ۴ میلیارد پارامتر به صورت کاملاً محلی و بدون نیاز به یک بایت اینترنت در لبه اجرا میشوند.
این استقلال سختافزاری به این معناست که راننده در تونلهای کوهستانی فاقد آنتندهی، جراح در اتاق عمل ایزوله بیمارستان و کوهنورد در مسیرهای دورافتاده، دستیاری فوقهوشمند با درک کامل مکالمه طبیعی در اختیار دارند. هیچ داده صوتی از دستگاه خارج نمیشود و تمام پردازشها درون سیلیکون محلی کاربر صورت میپذیرد.
در جمعبندی، انقلاب صوتبهصوت بومی دوران کنونی نه تنها مفهوم جستجو و کاربری نرمافزار را از لمس صفحه به گفتار ارگانیک دگرگون ساخته، بلکه شکاف باستانی میان هوش مصنوعی و عواطف انسانی را پر کرده است؛ آغازی بر عصری که در آن ماشینها دیگر صرفاً ابزارهایی فرمانپذیر نیستند، بلکه همراهانی همدل و شنوندگانی هوشیار به شمار میروند.
بیشتر از هوش مصنوعی



