
رونمایی رسمی و کالبدشکافی هوش مصنوعی NVIDIA Llama-3.1-Nemotron-70B؛ شاهکار جدید انویدیا که در بنچمارکهای استدلال و کدنویسی، GPT-4o و Claude 3.5 Sonnet را پشت سر گذاشت!
کالبدشکافی کامل هوش مصنوعی NVIDIA Llama-3.1-Nemotron-70B-Instruct؛ پیروزی تاریخی مدل ۷۰ میلیاردی انویدیا بر GPT-4o و Claude 3.5 Sonnet در بنچمارکهای Arena Hard و AlpacaEval 2 با دادههای مصنوعی HelpSteer2.
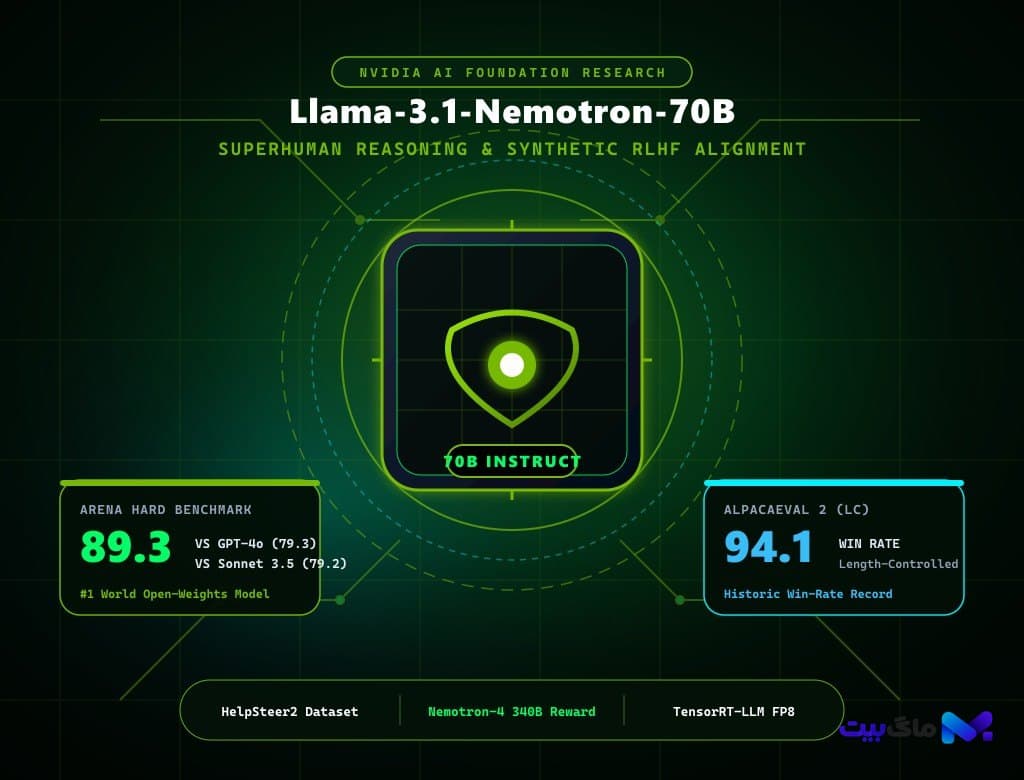
- کمپانی انویدیا با معرفی غیرمنتظره مدل هوش مصنوعی Llama-3.1-Nemotron-70B-Instruct، زلزلهای بزرگ در اکوسیستم هوش مصنوعی ایجاد کرد. این مدل زبانی ۷۰ میلیارد پارامتری که با بهرهگیری از مدل پاداش غولپیکر Nemotron-4 340B، دیتاست متنباز HelpSteer2 و الگوریتمهای ترازسازی پیشرفته پساآموزش (Post-Training) توسعه یافته، توانسته در آزمونهای معتبر دنبالکردن دستورات و شبیهسازی ترجیحات انسانی نظیر Arena Hard با کسب امتیاز ۸۹.۳ و در AlpacaEval 2 LC با نرخ برد خیرهکننده ۹۴.۱ درصد، قویترین مدلهای تجاری جهان از جمله GPT-4o اوپنایآی و Claude 3.5 Sonnet انتروپیک را قاطعانه شکست دهد. انویدیا با بهینهسازی بومی این مدل روی پشتههای نرمافزاری TensorRT-LLM و کوانتیزاسیون FP8، بستری بینظیر برای استقرار محلی و سازمانی سیستمهای استدلال هوشمند با هزینه و تأخیر بهینهسازیشده فراهم کرده است.
- بررسی جامع ابعاد فنی و کاربردی توسط تحریریه ماگ بیت.
- پیشبینی اثرات کوتاهمدت و بلندمدت بر اکوسیستم فناوری.
زلزله انویدیا در دنیای هوش مصنوعی؛ چگونه تیم سبز با یک مدل ۷۰ میلیاردی غولهای اختصاصی را به چالش کشید؟
در طول دو سال گذشته، نام کمپانی انویدیا همواره به عنوان تأمینکننده بلامنازع سختافزار، شتابدهندههای هوش مصنوعی خانواده هوپر (Hopper H100) و نسل نوین بلکول (Blackwell B200) بر سر زبانها بود؛ غول سیلیکونی که بدون تراشههای آن، حیات سرورهای ابری اوپنایآی، گوگل و متا غیرممکن به نظر میرسید. با این حال، جنسن هوانگ و مهندسان پژوهشی انویدیا ثابت کردهاند که بلندپروازی آنها به ساخت سختافزارهای پردازشی محدود نمیشود. تیم پژوهشی هوش مصنوعی بنیادی انویدیا در اقدامی غافلگیرکننده، با عرضه مدل هوش مصنوعی Llama-3.1-Nemotron-70B-Instruct نشان داد که در خط مقدم الگوریتمهای ترازسازی، معماری پساآموزش (Post-Training) و مهندسی دادههای مصنوعی نیز جایگاهی همتراز با برترین آزمایشگاههای پژوهشی جهان دارد.
نکته حیرتانگیز در مورد Nemotron-70B این است که این مدل حاصل پیشآموزش پرهزینه از نقطه صفر نیست؛ بلکه انویدیا وزنهای خام مدل متنباز Llama-3.1-70B-Base متای زاکربرگ را دریافت کرده و با تزریق یک خط لوله انقلابی از یادگیری تقویتی بر اساس بازخورد انسانی و هوش مصنوعی (RLHF/RLAIF)، مدلی خلق کرده که در بنچمارکهای پیچیده استدلال منطقی و نگارش کد، پرچمداران چندصدمیلیارد پارامتری و اختصاصی صنعت همچون GPT-4o و Claude 3.5 Sonnet را مغلوب ساخته است. این دستاورد درست در مقطعی رخ میدهد که پیشرفتهای زنجیرهای حوزه مدلهای زبانی متنباز نظیر رونمایی رسمی و کالبدشکافی هوش مصنوعی Meta Llama 3.2 و نبرد مدلهای کارآمد استدلالی همچون رونمایی از مدل هوش مصنوعی Claude 3.5 Haiku، ساختار انحصاری بازار را دچار فروپاشی کردهاند.
کالبدشکافی معماری و نوآوری دادههای مصنوعی؛ جادوی مدل پاداش Nemotron-4 340B و دیتاست HelpSteer2
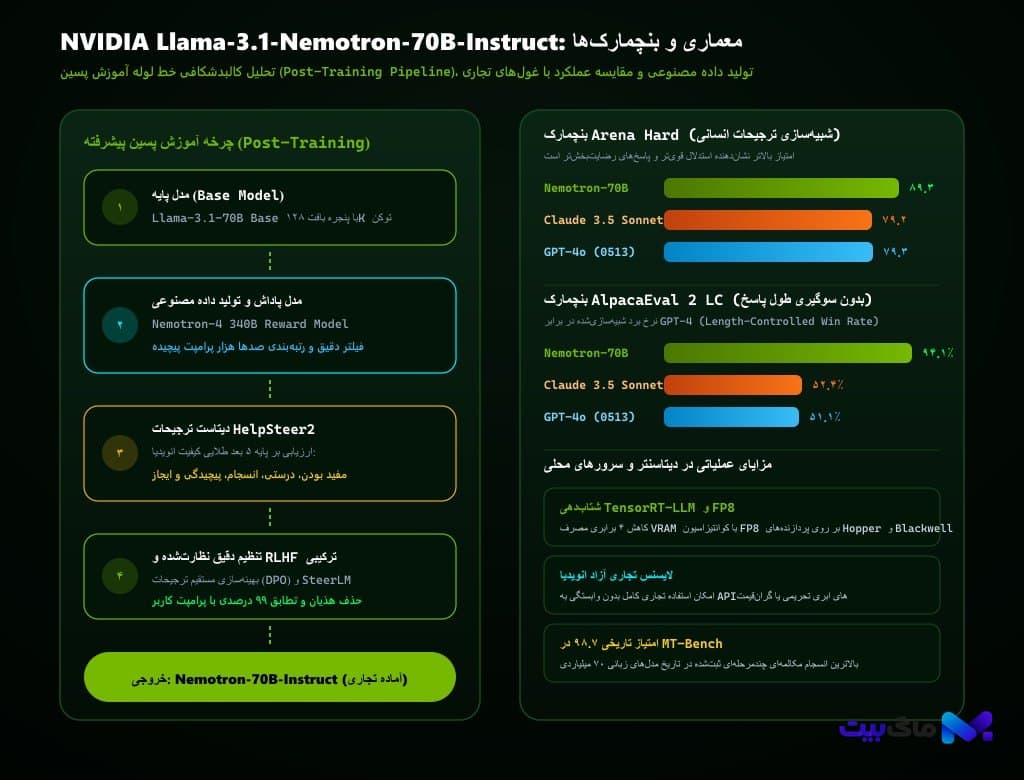
راز عملکرد معجزهآسای مدل نموترون ۷۰B چیست و انویدیا چگونه بدون تغییر در معماری بنیادین ترنسفورمر به چنین جهش خارقالعادهای دست یافته است؟ پاسخ این پرسش در هنر بیبدیل «تولید دادههای مصنوعی» (Synthetic Data Generation) و بازخورد مبتنی بر مدل پاداش نهفته است. انویدیا به جای استخدام هزاران برچسبزن انسانی کمدقت یا استفاده از دادههای پرخطای اینترنتی، از مدل پاداش غولپیکر Nemotron-4-340B-Reward به عنوان یک آموزگار فوقهوشمند استفاده کرده است. این مدل ارزیاب ۳۴۰ میلیارد پارامتری وظیفه داشته است صدها هزار پاسخ تولیدشده توسط مدلهای مختلف را در بوته آزمایش قرار داده و با دقتی خیرهکننده کیفیت آنها را محک بزند.
ستون فقرات این فرآیند، دیتاست باز و معتبر «HelpSteer2» است که انویدیا تحت مجوز آزاد CC-BY-4.0 در دسترس عموم قرار داده است. در این دیتاست، پاسخها بر اساس ۵ بعد طلایی کیفیت انویدیا رتبهبندی میشوند: مفید بودن (Helpfulness)، درستی فکتها و عدم هذیان (Correctness)، انسجام منطقی متن (Coherence)، توانایی مدیریت درخواستهای چندوجهی و پیچیده (Complexity) و در نهایت ایجاز و عدم حاشیهپردازی اضافی (Verbosity). سپس با ترکیب تنظیم دقیق نظارتشده (SFT) با الگوریتمهای نوینی نظیر بهینهسازی مستقیم ترجیحات (Direct Preference Optimization - DPO) و SteerLM، انویدیا وزنهای مدل را به گونهای تنظیم کرده که تمایل ذاتی به تفکر عمیق و منطقی پیدا کنند. این رویکرد پیشرفته به نوعی همپیمان با متدولوژیهای استدلال ساختاریافته در مدلهای استنتاجی مانند رونمایی رسمی از مدل استدلالگر OpenAI o1 است و نشان میدهد مهندسی پسین با دادههای باکیفیت تا چه اندازه میتواند قابلیتهای پنهان یک شبکه عصبی را شکوفا کند.
کارزار بنچمارکها و رقابت شانه به شانه؛ ارزیابی موشکافانه در Arena Hard، AlpacaEval 2 و MT-Bench
ارزیابیهای مستقل انجامشده توسط پژوهشگران و جامعه هوش مصنوعی متنباز (LMSYS و کارشناسان مستقل)، ابعاد حیرتانگیز توانمندیهای Nemotron-70B را اثبات کرده است. در آزمون دشوار و فوقالعاده معتبر «Arena Hard» که مجموعهای از ۵۰۰ پرامپت مهندسی، برنامهنویسی و استدلال انتزاعی بسیار پیچیده را با شبیهسازی ترجیحات خبرگان انسانی ارزیابی میکند، مدل Llama-3.1-Nemotron-70B-Instruct توانست امتیاز تاریخی ۸۹.۳ را به ثبت برساند. برای درک عظمت این رقم کافی است بدانیم پرچمدار مشهور اوپنایآی یعنی GPT-4o-0513 در این آزمون امتیاز ۷۹.۳ و مدل قدرتمند Claude 3.5 Sonnet انتروپیک امتیاز ۷۹.۲ را کسب کرده بودند؛ به این معنا که مدل ۷۰ میلیاردی انویدیا با اختلافی ۱۰ امتیازی این مدعیان چندصد میلیارد دلاری را شکست داده است.
شگفتیها به این نقطه ختم نمیشود؛ در بنچمارک معتبر «AlpacaEval 2 (Length-Controlled)» که نرخ برد پاسخهای مدل را در مقایسه مستقیم با پاسخهای GPT-4 میسنجد و به طور خودکار سوگیری مربوط به طولانی بودن کاذب پاسخها را حذف میکند، نموترون ۷۰B انویدیا به نرخ برد باورنکردنی ۹۴.۱ درصد دست یافت؛ رقمی که در مقایسه با نرخ ۵۲.۴ درصدی Claude 3.5 Sonnet و ۵۱.۱ درصدی GPT-4o یک رکورد دستنیافتنی در دنیای مدلهای زبانی محسوب میشود. همچنین در آزمون مکالمات پیوسته چندمرحلهای (MT-Bench)، این مدل با ثبت نمره ۹۸.۷، بالاترین وفاداری به بافت گفتگو، درک ظرایف چندمرحلهای و حل تعارضات اطلاعاتی را به نمایش گذاشت. این عملکرد نشان داد که یک مدل ۷۰B بهینهشده به سادگی میتواند بدون نیاز به زیرساختهای ابرمحاسباتی نجومی، سطحی از هوشمندی را ارائه دهد که پیش از این تنها در انحصار خوشههای چند دههزار پردازندهای شرکتهای انحصاری بود.
بهینهسازی روی سختافزار؛ شتابدهی استنتاج با TensorRT-LLM، FP8 Quantization و vLLM
یکی از مزیتهای استراتژیک انویدیا بر تمام رقبای نرمافزاری جهان، اشراف کامل این شرکت بر معماری سختافزار و پشتههای کامپایلر سیلیکون است. مدل Nemotron-70B نه تنها از نظر تئوریک برتر است، بلکه به صورت اختصاصی برای موتور استنتاج پرسرعت TensorRT-LLM و موتورهای مدرن ابری نظیر vLLM بهینهسازی شده است. به لطف پشتیبانی کامل از فرمت عددی ۸ بیتی ممیز شناور (FP8) بر روی هستههای تنسور معماری Ada Lovelace، Hopper و Blackwell، میزان مصرف حافظه ویدئویی (VRAM) این غول ۷۰ میلیاردی به کمتر از ۳۵ تا ۴۰ گیگابایت کاهش مییابد؛ بدین معنا که یک جفت کارت گرافیک پرچمدار RTX 4090 یا یک شتابدهنده منفرد H100 میتواند کل مدل را با حداکثر توان پردازشی میزبانی کند.
استفاده از تکنیکهای نوین مانند PagedAttention، کش بهینهشده کلید-مقدار (KV Cache) و موازیسازی تنسوری به Nemotron-70B امکان میدهد تا به نرخ استنتاج خیرهکننده بیش از ۸۰ تا ۱۰۰ توکن بر ثانیه در پردازشهای دستهای دست یابد. این بهرهوری خارقالعاده سختافزاری در تقارن با روندهای پرشتاب پردازش بر روی لبه است؛ درست همانگونه که در حوزه مدلهای فشرده شاهد تکنیکهای نوآورانه در اجرای هوش مصنوعی قدرتمند روی گوشی بدون اینترنت با BitNet بودیم و شتابدهندههای موبایلی پرچمدار در کالبدشکافی معماری تراشه مدیاتک دایمنسیتی ۹۴۰۰ نیز به سمت اجرای آفلاین الگوریتمهای هوش مصنوعی پیش میروند. انویدیا با تلفیق بینقص این مدل با ابزار NeMo Guardrails، امنیت سازمانی، جلوگیری از درز دادههای حساس و فیلترینگ ورودیهای مخرب را نیز در سطحی سازمانی و بیدرنگ تضمین کرده است.
دموکراتیزه شدن هوش مصنوعی سطح بالا؛ تأثیر Nemotron-70B بر آینده استارتاپها، عاملهای خودران و مدلهای متنباز
عرضه مدل Llama-3.1-Nemotron-70B-Instruct پیامی روشن و دگرگونکننده برای تمامی استارتاپها، شرکتهای فناوری و توسعهدهندگان مستقل در سراسر جهان به همراه دارد: دوران اسارت در چنگال APIهای ابری انحصاری، گرانقیمت و وابسته به سیاستهای تحریمی به پایان رسیده است. تا پیش از این، راهاندازی سامانههای هوشمند چندمرحلهای، اتوماسیون وظایف اداری و ابزارهای تحلیل اسناد، توسعهدهندگان را ناچار میکرد دادههای حساس و محرمانه سازمانی خود را به سرورهای ابری ارسال کنند؛ اما اکنون هر سازمان میتواند مغزی استدلالی قدرتمندتر از GPT-4o را بر روی سرورهای محلی و امن خود مستقر نماید.
این جهش کیفی به ویژه در قلمرو سیستمهای عاملمحور (Agentic AI) اهمیت حیاتی پیدا میکند. از آنجا که Nemotron-70B در درک دقیق دستورات ساختاریافته JSON، فراخوانی ابزارها (Function Calling) و حل مسائل گامبهگام دقت بینظیری دارد، بستری بینقص برای عاملهای هوشمندی است که وظیفه دارند مانند مفاهیم بنیادین تشریحشده در تحول بنیادین در هوش مصنوعی عاملمحور؛ رونمایی انتروپیک از قابلیت کنترل کامپیوتر و سامانههای اتوماسیون در مأموران هوشمند هوش مصنوعی؛ اتوماسیون کامل کارهای روزمره، وظایف پیچیده کامپیوتری را به طور خودکار انجام دهند. در کنار توسعه روزافزون سیستمهای بصری که در راهنمای جامع VLM چیست؟ راهنمای کامل مدلهای بینایی-زبانی به آنها پرداخته شد، شاهکار جدید انویدیا اثبات کرد که آینده هوش مصنوعی در گرو مدلهای متنباز، بهینهسازی پسین دادهمحور و شکستن دیوارهای بسته انحصاری رقم خواهد خورد.
بیشتر از هوش مصنوعی



